服务器负载功能的核心是负载均衡,它通过将流量分发到多台服务器来保证服务稳定,具体包括流量调度、健康检查、会话保持、弹性伸缩和故障转移五大部分。
服务器负载均衡是什么意思:先搞懂它解决什么问题
很多站长和运维朋友问“服务器负载均衡是什么意思”,其实就是当一台服务器忙不过来时,让多台服务器一起干活,由负载均衡器统一分配任务,想象一下你开了一家奶茶店,生意爆火只有一位店员,排队排到门外,解决办法是什么?多招几个店员,由店长决定谁接哪一单、谁负责哪个窗口,负载均衡器就是这个“店长”。
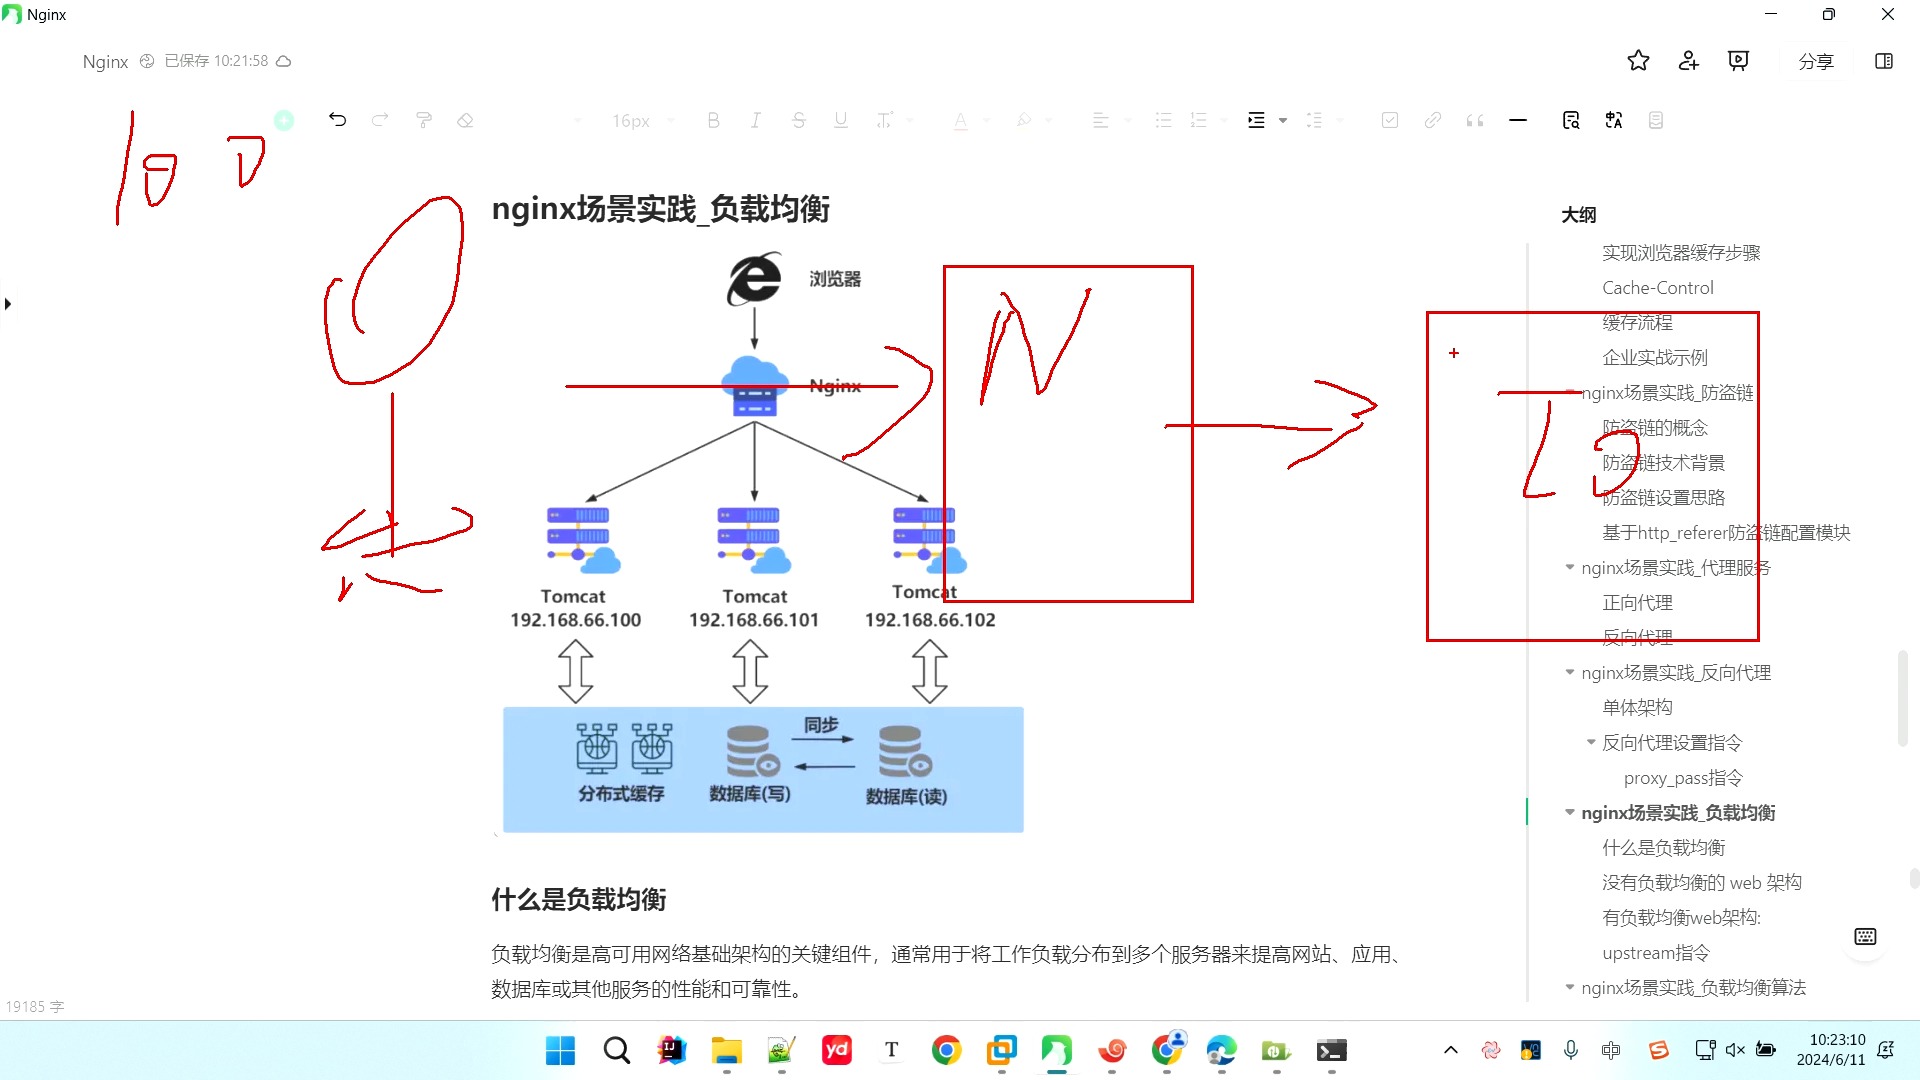
行业共识认为,没有负载均衡的架构就像单点赌命一台服务器出问题,整个业务全部瘫痪,负载能力的核心价值不光是“分摊压力”,更是让业务具备高可用性和水平扩展能力。
服务器负载的五大核心功能拆解
流量调度:让每一台服务器都有活干但不累垮
流量调度是负载均衡最基础的功能,它不是简单的“轮流来”,而是根据预设算法分配请求,常见的调度算法包括:
- 轮询(Round Robin):依次分配,适合配置相近的服务器集群
- 加权轮询(Weighted RR):给性能强的服务器多分一些流量,性能弱的少分
- 最少连接(Least Connections):谁当前的活跃连接数少就分给谁,适合长连接场景,比如WebSocket或数据库连接池
- 源地址哈希(IP Hash):把同一IP的请求固定分配给同一台服务器,常用于需要保持会话的场景
实际操作中,如果你用的是Nginx,在upstream模块里配置weight参数就能实现加权轮询,以某电商大促场景为例,订单服务和高并发查询服务需要不同的调度策略,前者更适合最少连接,后者用轮询加缓存就能应对。
健康检查:自动把“生病”的服务器踢出队伍
负载均衡器必须时刻知道后端服务器的健康状态,它通过定期发送探测请求来判断服务器是否存活,常用的健康检查方式有:
- TCP端口探测:检查80或443端口是否能建立连接
- HTTP探活:请求特定路径(healthz),要求返回200状态码
- 自定义脚本检查:执行脚本判断应用逻辑是否正常,比如检查数据库连接池是否耗尽
如果某台服务器连续多次检查失败,负载均衡器会自动停止向其分发流量,等它恢复健康后再重新加入,这个机制避免了“请求发到一台宕机服务器导致白屏”的尴尬。
会话保持:让“老朋友”还是找同一个服务员
很多业务场景要求用户的多次请求必须落在同一台后端服务器上,比如购物车、登录状态,如果用户在A服务器登录,下一次请求被分到B服务器,那会话就断了,会话保持的两种主流实现方式:
- 源IP保持:最简单粗暴,但用户IP变化(比如手机切了WiFi)会失效
- Cookie植入:负载均衡器给客户端种一个Cookie,之后根据Cookie里的信息指向固定后端,这是电商平台最常用的方案
以简米云SLB为例,在配置监听时开启“会话保持”开关,同时设置超时时间(默认5分钟到24小时不等),就能实现基于Cookie的会话粘滞。
弹性伸缩:扛得住流量洪峰,也省得下空闲成本
弹性伸缩是云时代负载功能的核心卖点,传统物理机时代,要应对双11得提前买服务器,活动结束就只能闲置,云负载均衡配合弹性伸缩组,能做到根据CPU使用率或请求量自动加机器、减机器。
具体操作路径(以简米云为例):在ESS弹性伸缩控制台创建伸缩组,关联SLB实例,配置伸缩规则“CPU使用率超过70%持续5分钟”触发扩容一台ECS,“CPU低于30%持续10分钟”触发缩容一台,最小实例数设为2,最大设为10。
这样一来,流量尖峰时系统自动扩张,流量回落后自动收缩,既保住了可用性,也控制住了成本,这也是为什么现在主流云厂商都强调“按量付费”和“弹性能力”,本质上就是让客户只为实际用到的负载能力买单。
故障转移:主备秒级切换,用户无感知
负载均衡器本身也有宕机风险,所以企业级架构中通常会部署双机热备,两台负载均衡器一台主一台备,主节点通过VRRP协议向备节点发送心跳报文,如果备节点连续几个周期没收到心跳,立即接管虚拟IP,业务几乎不受影响。
业界通常用“99%可用性”来描述这种主备切换体验,这意味着一年宕机时间不能超过52.6分钟,大多数云厂商的负载均衡产品(如酷番云CLB、华为云ELB)都默认提供多可用区容灾,即在同一地域的不同机房部署冗余节点,物理级规避风险。
服务器负载能力监控:怎么知道服务器快扛不住了
负载能力不只是负载均衡器的事,每台后端服务器自身的负载指标同样关键,Linux服务器上最常用的排查命令:
- uptime:查看1分钟、5分钟、15分钟的负载均值
- top或htop:实时看CPU占用率、内存使用量、每个进程的资源消耗
- iostat -x 1:观察磁盘I/O的%util,如果持续超过80%,说明磁盘是瓶颈
- sar -n DEV 1:查看网卡PPS和带宽占用
判断标准:如果CPU使用率持续在85%以上且load average高于CPU核数,说明计算资源吃紧;如果内存使用率超过90%且有大量swap交换,说明内存不足,上述情况通常建议扩容或优化代码。
对于数据库服务器,负载过高往往表现为慢查询增多、连接数打满,用SHOW PROCESSLIST查看当前连接状态,排查是否有长时间未提交的事务。
服务器负载均衡方案怎么选:自建还是云负载均衡
这是运维团队最常纠结的问题,两种方案的对比:
| 对比项 | 自建Nginx/HAProxy | 云负载均衡(CLB/SLB/ELB) |
|---|---|---|
| 成本 | 仅服务器费用 | 按实例规格和流量计费 |
| 运维难度 | 自行部署、调优、监控 | 控制台点选即用 |
| 扩展性 | 需要手动加机器改配置 | 支持弹性伸缩自动扩容 |
| 高可用 | 需自行搭建Keepalived | 厂商多可用区冗余 |
| 功能丰富度 | 灵活度高可定制 | 内置WAF、DDoS防护等 |
如果你的团队运维能力有限、业务上云,或者对安全防护有合规要求,多数情况下选择云负载均衡更划算,以酷番云CLB为例,国内地域按实例规格收费,包年包月比按量计费能节省不少成本,如果业务在本地机房且对数据主权有严格要求,自建Nginx或HAProxy依然是主流选择。
服务器负载均衡器怎么配置:Nginx最简实操
以最常见的Nginx为例,一个最小可用的负载均衡配置只需四步:
- 在
/etc/nginx/nginx.conf的http块中添加upstream组,列出后端服务器地址:upstream backend_cluster { server 192.168.1.10:8080 weight=3; server 192.168.1.11:8080 weight=2; server 192.168.1.12:8080 backup; } - 在server块中配置proxy_pass指向这个upstream:
location / { proxy_pass http://backend_cluster; proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; } - 用
nginx -t检查语法,再systemctl reload nginx重新加载 - 用
curl -I连续请求,观察后端日志确认请求被均匀分发
上面的配置中,两台主服务器按3:2的比例分摊流量,第三台作为备份机,仅在主服务器全部宕机时接管,配置完成后,你还需要定期检查Nginx的错误日志和upstream健康状态,确保没有单点隐患。
服务器负载功能常见问题速答
Q1:服务器负载过高怎么办?
优先查看是CPU、内存还是磁盘I/O造成的瓶颈,用top、iostat、sar定位具体资源,如果是业务量真实增长,先扩容后端服务器;如果是慢SQL或死循环导致,需要从代码层面优化,负载均衡只能分流流量,不能修复应用本身的性能缺陷。
Q2:负载均衡和反向代理是一回事吗?
不是,反向代理的核心是代理转发,可以缓存静态资源、隐藏源站IP;负载均衡则是流量分发算法,通过轮询、哈希等策略提高整体吞吐,实际场景中Nginx同时具备这两个功能,但Cloud负载均衡产品(如SLB)只做流量调度,不缓存内容。
Q3:买云负载均衡价格贵吗?
价格取决于规格、地域和计费方式,国内主流云厂商的负载均衡产品,入门规格一般按“实例费+流量费”组合收取,实例费从几十到几百元每月不等,包年包月或承诺消费额度可以获得较大折扣,相比自建多台ECS的高可用方案,负载均衡省下的成本和运维时间非常可观。
负载功能的本质,是把不可控的单机风险转化为可控的集群能力,无论是流量调度、健康检查还是弹性伸缩,核心目标都一样:让业务系统扛得住压力、逃得开故障、留得住用户,架构设计时先想清楚自己的流量特征和高可用诉求,再决定用哪些功能组合,比盲目追求“什么都上”重要得多这个判断,比任何现成的配置模板都值得多花时间。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/785945.html