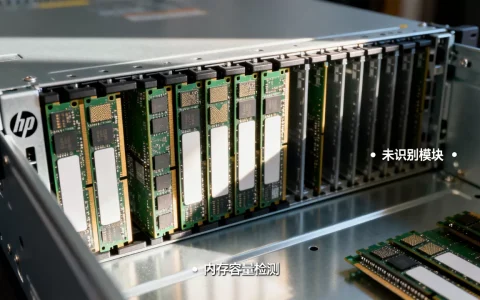
服务器巡检的核心是定期检查硬件、系统、应用三个层面的运行状态,通过日志、性能数据和硬件自检工具提前发现隐患,把故障扼杀在萌芽期。 这套动作就像给服务器做定期体检,不是等它“生病”了才去治,而是主动排查那些可能导致宕机、性能劣化的小问题,下面直接拆解巡检具体做什么、怎么做。
服务器巡检一般检查哪些内容?
先明确巡检的对象,一台物理服务器从上到下分三层:硬件层、操作系统层、应用层,每一层都有各自的检查重点,缺一不可。
硬件层:电源、风扇、硬盘、内存、CPU
硬件故障是服务器最怕遇到的事,因为一旦发生往往就是物理损坏,轻则丢数据,重则整机停摆。
- 电源与风扇状态:登录服务器的带外管理口(比如Dell iDRAC、HP iLO),查看电源模块是否冗余、风扇转速是否异常,带外管理是唯一能在系统死机时还能看到硬件状态的地方,巡检时别漏掉。
- 硬盘健康:用
smartctl -a /dev/sda查看SMART信息,重点关注Reallocated_Sector_Ct(重映射扇区数)和Pending_Sector(待映射扇区数),这两个数值只要不为0,就意味着硬盘在向你“求救”,同时检查RAID阵列状态,比如使用MegaRAID的storcli或HP的ssacli,确认阵列处于Optimal状态而不是Degraded。 - 内存与CPU:在系统层面看
/var/log/messages或dmesg里有没有大量ECC内存纠错记录,这类记录偶尔出现问题不大,但如果持续刷屏就说明内存颗粒不稳定了,CPU方面主要看温度传感器读数是否持续偏高。
行业共识认为,硬件巡检的重点不是“看有没有坏”,而是“看有没有要坏的迹象”,硬盘的SMART值、内存的ECC纠错次数、风扇转速的异常波动,都是提前几天甚至几周就能捕捉到的信号。
操作系统层:负载、内存、磁盘与系统日志
系统层面的巡检主要靠命令和日志分析,这块是日常巡检最花时间的地方。
- 系统负载与CPU占用:执行
uptime看1分钟、5分钟、15分钟的平均负载,正常服务器的负载应该稳定在一个固定区间,如果负载持续走高但业务量没涨,那八成是出了死循环或者被挖矿程序盯上了,再用top或pidstat看是哪个进程在吃掉CPU。 - 内存使用情况:用
free -h查看内存和Swap的状态,注意观察Swap使用量是否持续增长,如果Swap一直在涨,说明物理内存快见底了,应用性能会直线下滑。 - 磁盘空间与Inode:
df -h看磁盘使用率,但很多人会漏掉df -i查看Inode,曾经有台服务器磁盘还剩几百GB,业务却报“磁盘已满”,其实就是小文件太多把Inode耗尽了,日志目录、临时目录、邮件队列都是Inode消耗大户,巡检时多看一眼没坏处。 - 系统日志分级排查:直接看全部日志会累死人,要带着“找问题”的眼光去查,用
journalctl -p err -b查看本次启动以来的所有错误级日志,一条条过,看到不明错误就顺藤摸瓜用journalctl -u 服务名去追踪具体服务。
应用与服务层:进程、端口、中间件状态
系统层面没问题,不代表业务没问题,应用层的巡检要直接落到服务和业务接口上。
- 进程与端口检查:用
ps -ef | grep 服务名确认关键进程还活着,用ss -lntup查看监听端口是否正常,这里有类典型问题:服务进程还是个僵尸状态,端口也在监听,但业务已经卡死无响应了,所以光看进程和端口不够,还要主动发请求验证,比如用curl -I http://127.0.0.1:8080/health检查HTTP状态码是否返回200。 - 中间件与数据库连接数:Tomcat、Nginx、WebLogic等中间件要关注线程池使用率和活跃连接数,数据库要看当前连接数是否接近
max_connections上限,以及慢查询日志有没有突然变多,慢查询增多往往意味着索引失效或者SQL写得有问题。
服务器日常巡检包括什么?频率与场景怎么定
巡检不是一次性的任务,而是需要按周期持续推进的工作,巡检频率怎么定,主要看服务器的角色和业务重要性。
巡检频率分级:日检、周检、月检
- 每日巡检:主要针对核心业务服务器,每天上班后花10-15分钟执行一遍磁盘使用率、CPU负载、关键服务状态、昨日错误日志的检查,高频操作自动化跑,人为确认异常项就行。
- 每周巡检:覆盖到非核心但重要的服务器,检查项加上硬件状态(RAID状态、硬盘SMART值)、系统更新情况、安全日志审查、备份任务执行结果。
- 每月巡检:全量覆盖所有服务器,重点做硬件健康检查、固件版本梳理、日志归档清理、账号权限复核、安全补丁评估。
特殊场景的临时巡检
固定周期是一方面,有些特定时间点必须额外加巡一次。
- 业务大促或流量高峰前:提前检查带宽余量、数据库连接池上限、负载均衡后端节点的健康状态,很多线上事故都发生在流量翻倍的瞬间,高峰期前做一次压力摸底比什么都管用。
- 机房断电或UPS测试后:电源切换瞬间对硬件有冲击,开机后要重点看电源模块状态、RAID是否自动重建、系统有没有因非正常关机出现文件系统损坏。
- 版本发布或配置变更后:变更完成后的半小时内,重点盯错误日志、接口响应时间、资源消耗曲线,发现指标异常立刻回滚。
服务器巡检与监控告警有什么区别
不少人会问:上了监控系统还要做巡检吗?监控和巡检是互补关系,不是替代关系。
监控是实时告警,巡检测是周期体检,监控负责在你睡觉时盯住“出一台”的突发故障,比如CPU突然打满、端口挂了、磁盘瞬间写满,它通过网络告警第一时间通知你,但监控解决不了两类问题:
一是它只能暴露“当前已发生”的异常,无法判断“趋势正在变差”,比如硬盘SMART值里的重映射扇区数从0涨到50、内存ECC纠错频率逐渐升高,这类数据监控平台虽然也会采集,但很少有人给它们设告警阈值,因为它们短期内不影响业务,可一旦恶化到临界点就是硬故障。
二是监控采集的数据相对浅,拿不到深层信息,比如日志里的业务报错堆栈、数据库慢查询的具体SQL内容、应用线程池的排队情况,这些需要巡检时登录服务器做针对性下钻排查。
业内专家指出,成熟的运维体系里,监控负责“发现事故”,巡检负责“预防事故”,两者结合,才能既挡住突发故障,又截住潜在的慢性问题。
服务器巡检报告与脚本怎么落地
巡检不能做了就忘,痕迹化管理很重要,一份清晰的巡检记录,不仅能帮你追溯历史状态变化,出问题时也是排查的重要线索。
巡检报告写什么
报告不需要长篇大论,但要能一眼看出异常,建议每台服务器一张表,包含以下核心内容:
- 服务器IP与角色(10.0.3.18-订单中心应用”)
- 巡检时间与执行人
- 关键指标数值(磁盘使用率、内存使用率、系统负载、启动时间)
- 异常项记录(错误日志摘要、硬件告警详情、性能指标超标情况)
- 处置动作(当场处理、已报修、待观察)
如果历史巡检有记录,顺手对比一下本次数据和上周数据,磁盘空间是涨了还是降了,负载有没有逐步爬升的趋势,这些趋势对比往往比单一数值更有价值。
巡检脚本怎么做
常用操作完全可以固化成脚本,你可以写一个简单的Shell脚本,把df -h、free -m、uptime、sar -q、smartctl -a这些命令的输出统一汇总到一个文本文件里,再配合mailx发到指定邮箱。
还有更省事的思路:利用Ansible这类自动化工具,写一份playbook,批量对几十台服务器执行巡检命令并收集结果,再生成统一的HTML报告,在监控大盘上挂一个入口随时查看,比起你手动登录每台机器敲一遍命令,效率和准确性都高得多。
常见问题解答
服务器巡检多久做一次合适?
核心业务服务器建议每天巡检一次,重点看资源使用率和错误日志;外部非核心服务器至少保证每周一次全量检查,巡检间隔长短取决于业务的重要程度,而不是服务器的数量。
服务器巡检脚本怎么写?
使用Shell或Python均可,Shell适合快速收集系统指标,比如执行df -h、free -m、uptime并拼接输出;Python适合做更复杂的日志解析和趋势判断,脚本核心是检查阈值、记录结果、输出异常告警,推荐用crontab配合邮件或Webhook通知结果。
服务器巡检表包含哪些检查项?
一份完整的巡检表至少要有带外管理状态、电源与风扇健康、硬盘SMART与RAID状态、内存ECC记录、系统负载、磁盘空间与Inode、系统日志中的Error级别条目、关键进程与端口监听状态、中间件线程池和数据库连接数,根据业务特点再扩展相应的应用专属检查项。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/786512.html