赶论文的研究生抢不到合适的GPU卡,本质上是算力供需错配问题,短期靠错峰排队和轻量模型过渡,中期靠租用云GPU或抢占实验室闲置卡解决,长期则要在选题阶段就把算力成本纳入考量。每年三四月和九十月是论文冲刺的高峰期,实验室那几台带卡的机器永远处于满载状态,盯着屏幕刷nvidia-smi的人比跑实验的人还多,这篇文章就从卡为什么难抢、抢不到时怎么办、云卡和本地卡怎么选、租卡大概要花多少钱几个角度,把这件事讲透。
卡为什么总在关键时刻被抢光
先说清楚原因,才能对症下药,组里卡不够用不是某一个实验室的问题,而是普遍现象。
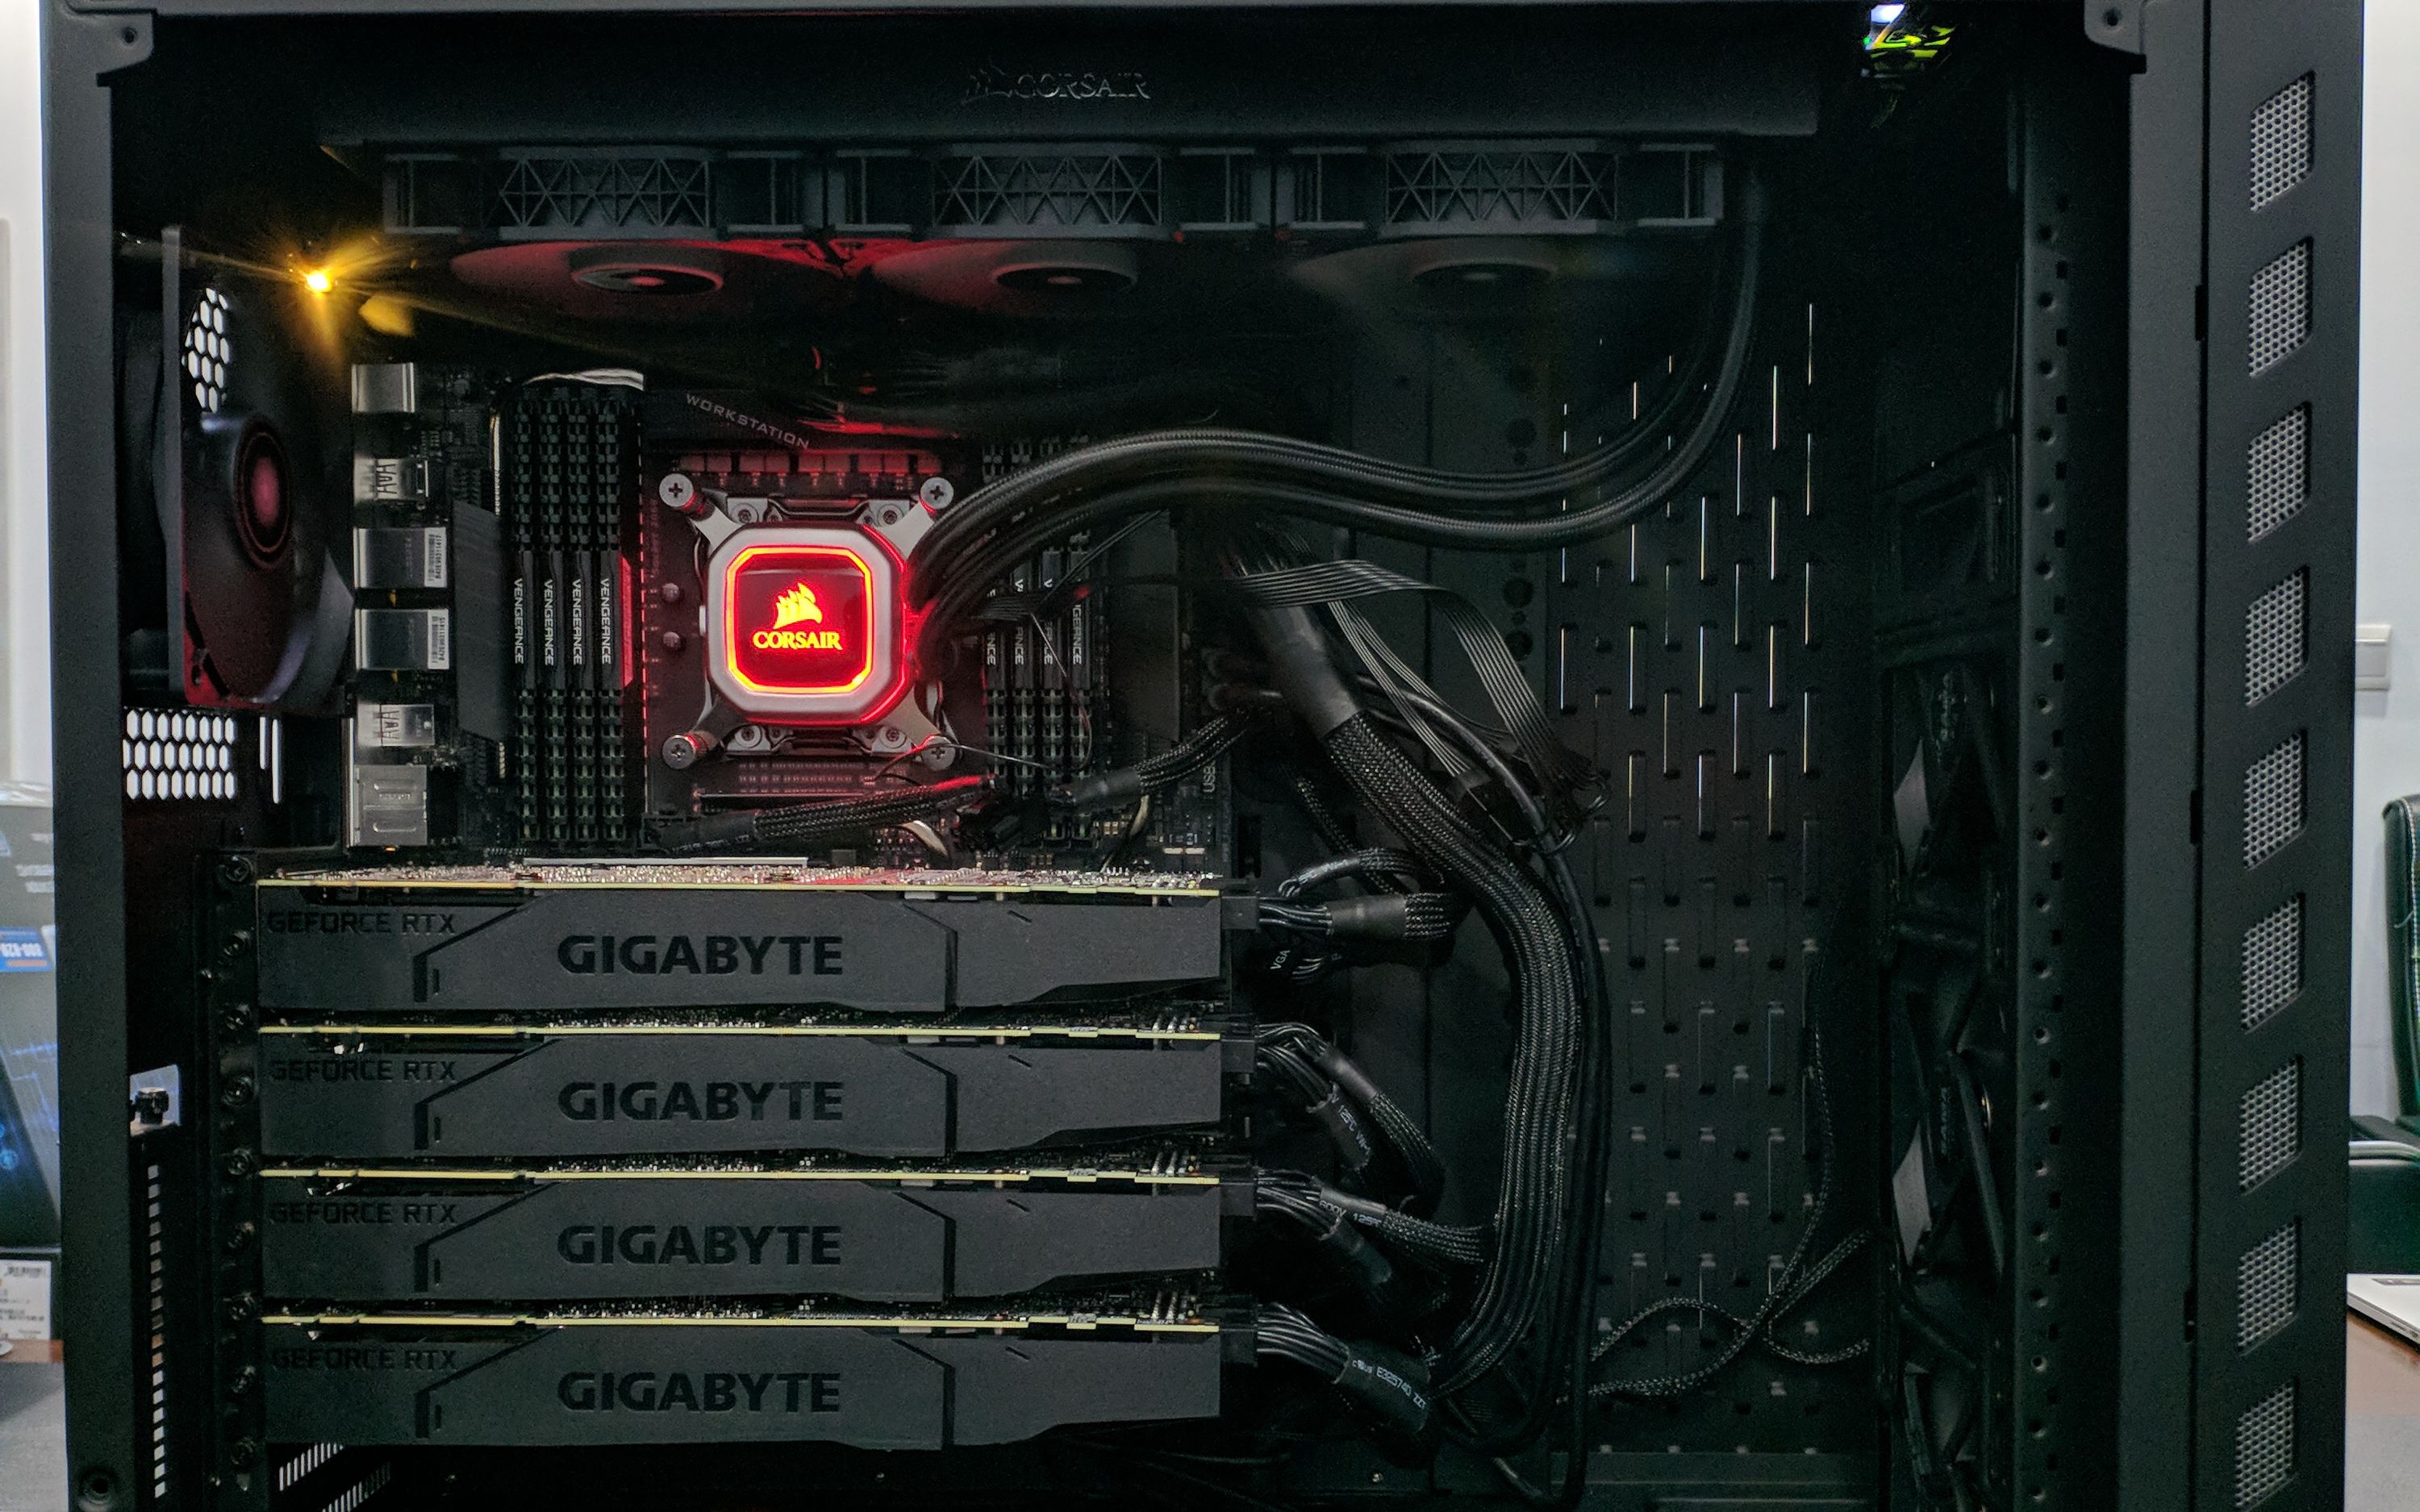

供需两端同时挤压
- 需求端:毕业论文、会议投稿、项目结题往往集中在同一时间段,几个人同时要跑对比实验、消融实验、超参搜索,一张卡一天只能服务一个训练任务。
- 供给端:实验室采购预算有限,一张主流训练卡从申请到到位周期较长,机器数量常年跟不上学生人数增长,据行业共识,高校实验室人均可用GPU算力普遍低于企业研发团队,这个差距在论文季会被放大。
行业专家指出,多数高校的GPU集群调度仍以人工协商为主,缺少统一的配额和排队机制,导致“谁先占谁先用”成为潜规则,于是有人开一个终端挂三天,有人用极小的batch占着卡不放,资源利用率并不高。
抢不到卡的典型场景
- 早上八点登录服务器,发现四张卡已经被三个任务占满,显存余量只够跑推理。
- 自己的实验需要24G以上显存,但空闲的只有小显存卡,大模型根本加载不进去。
- 排了一晚上队,轮到自己时正好赶上组会,任务又不敢停。
- 好不容易抢到卡,跑了一半发现数据预处理写错,重跑又要重新排队。
这些场景背后其实是同一个问题:你没有把“算力”当成项目管理的一部分来对待,而是当成运气。
抢不到卡时的四个应急办法
在硬件短期不可能增加的前提下,先把现有资源用到位,这部分是实操,照着做能缓解相当一部分压力。
用任务分级压缩占用时间
把实验按“必须用卡”和“不用卡”分开,数据清洗、格式转换、小规模特征工程、结果画图全部放到CPU机器上完成,GPU只留给真正的前向反向传播,具体操作路径:
- 在本地或CPU节点完成数据集构建,保存为训练脚本可直接读取的格式。
- 用几张小图或小批量数据在GPU上跑通全流程,确认代码无bug再提交全量训练。
- 全量训练时用
tmux或screen挂后台,日志重定向到文件,避免终端断开导致任务中断。 - 训练前设置检查点保存间隔,例如每半小时存一次,被中断后可断点续跑,不用从头排队。
错峰使用与协商机制
观察组里卡的使用规律,多数情况下凌晨到早上八点是相对空闲的时段,把长任务安排在夜间,白天做数据分析和论文写作,同时推动组内建立简单的预约表,哪怕只是一个共享文档,也比口头争抢有效率,有条件的实验室可以用 slurm 这类调度系统,提交任务后自动排队,谁也无法长期霸占。
模型轻量化换时间
如果实验允许,把大模型换成小模型做前期验证,把大batch换成梯度累积,把全量微调换成LoRA这类参数高效微调,这些做法能显著降低显存占用和单次实验时长,原本需要一张大卡跑一天的实验,改成小模型加梯度累积后,可能在小卡上几小时就能出初步结论,等大卡空出来再做最终版本。
分布式与混合精度
多卡并行不是只有大团队才能用,PyTorch的 DistributedDataParallel 配合混合精度训练,在两张中等显存的卡上也能跑起单卡跑不动的模型,前提是先把通信和同步调通,这一步在CPU节点上用小数据调试即可,不占用GPU。
云GPU和本地显卡哪个更适合研究生跑实验
云GPU和本地显卡哪个更适合研究生跑实验
这个问题的答案取决于三个变量:实验时长、预算、数据合规要求,下面用表格做一个维度对比。
| 对比维度 | 本地实验室卡 | 云GPU租用 |
|---|---|---|
| 等待时间 | 高峰期长,取决于排队 | 下单即用,按需开通 |
| 单次成本 | 已沉没,边际成本低 | 按小时计费,短任务划算 |
| 长任务成本 | 低 | 持续租用成本上升明显 |
| 显存规格 | 受限于实验室采购 | 可选范围大,按需选型 |
| 数据安全 | 内网可控 | 需关注平台合规与传输加密 |
| 运维负担 | 需自己配环境 | 镜像预装,开箱即用 |
结论很清楚:短周期、赶进度的实验优先用云卡;长期反复训练、数据敏感的项目留在本地,不少研究生采用混合策略,本地卡跑最终实验和需要保密的数据,云卡跑超参搜索、对比实验和临时验证。
云卡怎么选才不踩坑
- 先确认框架和CUDA版本,选预装镜像能省掉半天配环境的时间。
- 按显存需求选型,24G能覆盖多数中等规模实验,更大模型再往上选。
- 优先选支持按量计费和随时释放的平台,避免包月套餐在论文写完后闲置。
- 数据上传前做好压缩和脱敏,训练脚本里把数据路径写成环境变量,方便迁移。
租GPU跑实验一个月多少钱
租GPU跑实验一个月多少钱
价格是研究生最关心的现实问题,近年来云GPU按量计费的价格区间跨度较大,单卡每小时从个位数到数十元不等,取决于卡型、显存和平台,粗算一笔账:
- 如果每天实际训练四小时,按中等价位估算,一个月(按30天计)大致在几百到一两千元区间。
- 如果只是零散验证,每天一小时以内,成本可以压到百元级。
- 如果包月不限时,价格通常高于按量计费的总和,只适合确定要长期跑的任务。
真正省钱的关键不是单价,而是减少无效训练时长。先在本地小数据上把代码跑通,再上云跑全量,能避免大量“租着卡调bug”的浪费,多家平台的新用户优惠和学术优惠可以关注,但要以平台公开信息为准,不轻信非官方渠道的低价转卖。
北京高校GPU集群免费申请的真实情况
北京高校GPU集群免费申请的真实情况
地域词放在这里是因为北京高校集中,校际和校级公共算力平台相对多,但“免费”通常有前提:
- 校级公共集群一般对本校师生开放,需要导师账号或院系审批,排队优先级按项目等级划分。
- 部分平台对毕业论文课题有专项额度,需要提交申请说明用途和预计机时。
- 免费额度往往有限,超出后按内部价计费,申请前要读清楚机时结算规则。
实际操作路径是:先查学校信息化部门或校级高性能计算中心的官网通知,找到申请入口,准备导师签字的使用说明,注明课题名称、预计机时和软件环境需求,审批通过后通常需要参加一次使用培训才能开通账号,这类资源的优势是内网访问、数据不出校,劣势是排队周期不一定比实验室短多少。
把算力当成论文进度的一部分来管理
说到底,抢不到卡不是纯粹的运气问题,而是进度管理里缺了算力这一环,几个可以直接落地的习惯:
- 开题或确定选题方向时,就估算需要的训练轮次和单次时长,乘以排队系数,倒推出最晚开始跑实验的时间。
- 建立自己的实验清单,按“验证性实验”和“正式实验”分开,前者用云卡快速迭代,后者等本地卡空档。
- 每周固定时间检查组内卡的使用情况,提前预约而不是临时争抢。
- 论文写作和数据整理与训练并行推进,不要等实验结果全出来才动笔。
算力不够是常态,把有限算力用在最关键的实验上,比多抢一张卡更能加快论文进度。
关于抢GPU卡的常见疑问
研究生赶论文抢不到GPU卡怎么办?
先做任务分级,把非GPU环节全部挪到CPU节点;再用小数据在本地调通代码,减少占用GPU调bug的时间;长任务挂后台并设置检查点,被中断可续跑;短期缺口用云GPU按量补,只跑关键实验,核心原则是把GPU时间留给不可替代的训练步骤。
云GPU租用跑实验成本高不高?
成本取决于使用时长和卡型,按量计费下,零散使用每天几小时,月支出通常低于包月套餐;持续全天训练则成本上升明显,控制成本最有效的手段是本地调通再上云、用检查点避免重跑、按显存需求选型而不是一味选大卡,具体价格以各平台公开计费页为准。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/789835.html