GRE隧道在现代企业组网中依然占据重要位置,但运维层面的坑远比配置阶段多,核心思路是:把隧道当作一条真实链路来监控,而不是配完就忘。
GRE隧道运维,先搞懂它和物理链路的本质区别
很多运维兄弟对GRE隧道有个误区,觉得配置完了、ping通了就万事大吉,GRE隧道本质上是一个虚拟点对点链路,它承载在物理网络之上,但又不完全等同于物理链路,物理链路断了你能收到告警,GRE隧道断了,物理设备可能毫无感知。
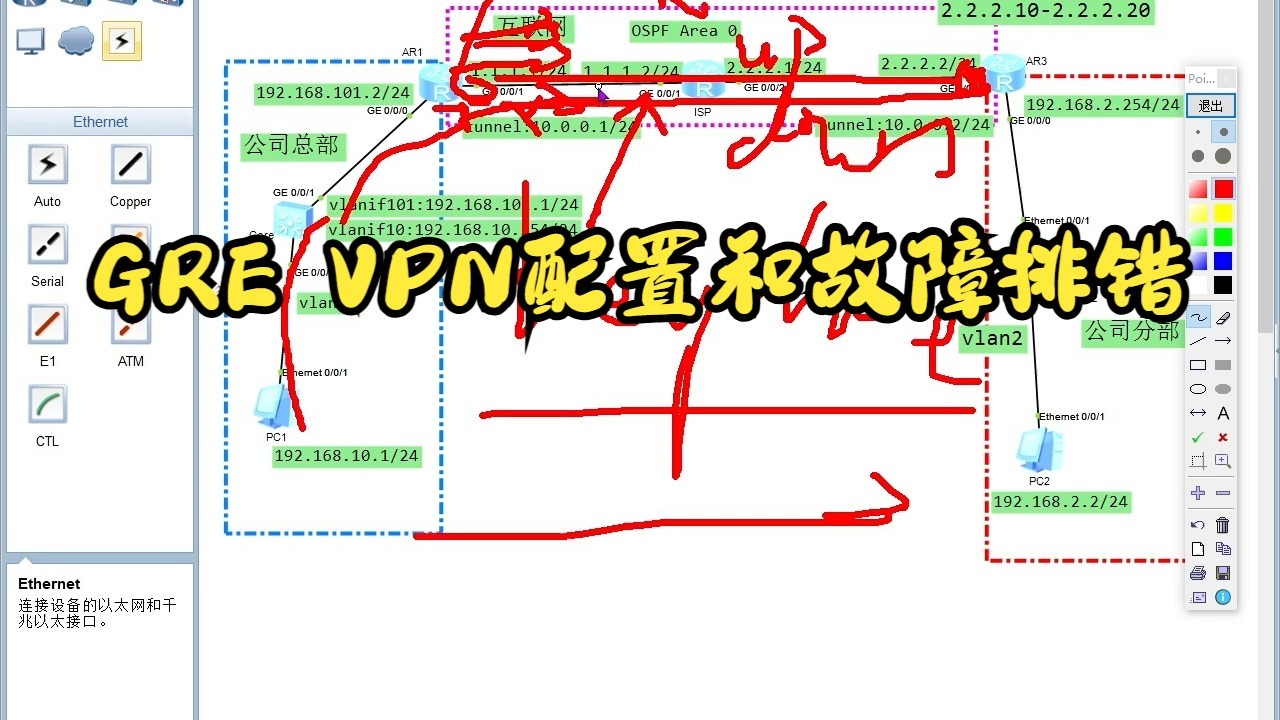
业内专家指出,GRE隧道运维中最容易翻车的场景,集中在链路震荡检测、MTU/MSS协商、路由环路规避这三块,下面逐个拆开说,按照运维权重从高到低排。
运维痛点一:隧道keepalive检测机制必须自建
GRE协议本身不带DDR拨号那种自愈机制,也不像OSPF那样自带Hello报文,隧道对端设备宕机或者中间链路质量恶化时,本端设备不会主动感知。
-
依赖路由协议联动:如果隧道两端跑OSPF或BGP,路由协议收敛时间就是你的故障感知时间,OSPF的Dead Interval默认40秒,这意味着对端挂了,你最快也要40秒后才知道。
-
配置IP SLA监控:思科设备用
ip sla icmp-echo指向对端隧道地址,华为设备用NQA,配置探测频率3-5秒,配合Track触发静态路由切换,这是目前最主流的隧道健康检查方案。 -
慎用Keepalive选项:部分厂商设备支持隧道接口下的Keepalive,但默认参数偏激进,在丢包率超过1%的链路上容易造成隧道接口反复Up/Down,触发路由抖动,比不配还难受。
运维痛点二:MTU/MSS不一致导致的应用层”假死”
这应该是GRE隧道运维中最隐蔽的问题,GRE头部至少增加24字节(标准GRE)+ 4字节(可选关键字),如果叠加IPsec,额外再增加几十字节,隧道两端的MTU设置不一致时,大包被静默丢弃,小包正常通行,表现出来的症状就是网页打不开、文件传输卡死,但ping一切正常。
具体排查路径:
- 在两端设备执行
ping <对端地址> size 1472 df-bit,逐级减小数值,找到实际能通的最大包长。 - 在隧道接口上设置合理的MTU值,比如物理接口MTU 1500的链路上,GRE隧道MTU建议设为
1400-1420。 - 在两端内网设备上配置TCP MSS Clamping,思科是
ip tcp adjust-mss,华为是tcp adjust-mss,建议值设为1360,给TCP头部和IP头部预留空间。
运维痛点三:递归路由导致的隧道环路
这个坑属于配置阶段埋下的,但通常在运维阶段才炸出来,当GRE隧道的目的地址经由隧道自身路由学习时,就形成了递归路由,比如你配置了去往对端内网的路由指向Tunnel0,而Tunnel0的目的地址又从Tunnel0学到了,数据包就进入无限循环。
运维排查技巧:
- 查看路由表
show ip route,确认隧道源目地址的可达性条目,源目地址的路由永远只能指向物理出口,不能指向隧道。 - 使用
traceroute观察数据包路径,如果发现TTL逐渐递减且始终在同一台设备打转,基本可以判定递归路由。 - 在边界设备上用策略路由控制隧道流量的走向,确保去往隧道目的地址的流量永远走物理链路。
GRE隧道日常巡检该看什么指标
很多运维团队对GRE隧道的巡检停留在”ping通就行”的层面,这远远不够,一套合格的巡检机制至少覆盖以下四个维度:
控制层面检查项
- 隧道接口状态:Up/Down状态是否稳定,是否存在频繁翻转
- 路由表条目:隧道相关的路由条目是否存在、下一跳是否正确
- 协议邻居状态:跑OSPF/BGP的话,邻居状态是否稳定
数据层面检查项
- 隧道接口的Input/Output速率:对比物理接口流量,识别异常占用
- CRC错误计数:物理接口的CRC错误增长说明底层链路质量恶化
- 丢弃计数:接口Discard快速增长时,优先排查MTU不一致问题
可用性指标
- 端到端延迟变化曲线:GRE隧道本身不引入明显延迟,但底层路径变化会直接反映在延迟上
- 丢包率趋势:通过持续ping或专门的拨测工具,记录丢包率的长期趋势
配置一致性检查
- 两端设备的隧道源目地址是否仍然匹配
- 两端设备的GRE Key(如果配置了)是否一致
- 两端设备的路由策略、ACL是否有被其他运维人员改动过
GRE隧道和IPsec隧道运维哪个更省心
这是一个经常被问到的问题,GRE隧道和IPsec隧道各有各的苦,但运维侧的重点完全不同。
| 对比维度 | GRE隧道 | IPsec隧道 |
|---|---|---|
| 组播支持 | 支持 | 不支持 |
| 配置复杂度 | 低 | 高 |
| 常见故障点 | MTU、递归路由 | IKE协商失败、加密卡资源耗尽 |
| 故障排查难度 | 中等 | 较高 |
| 监控手段 | 路由协议+IP SLA | 需额外监控SA生命周期 |
- 如果跑的是OSPF、组播、VRRP这类依赖组播的协议,只能选GRE,没得商量,运维重心放在路由收敛速度和MTU调优上。
- 如果只是站点间互访内网网段,IPsec在加密特性上有天然优势,但运维中要盯紧IKE SA的存活时间、加密引擎的CPU占用率。
行业共识认为,大多数企业最终选择的是GRE over IPsec的组合模式,用GRE解决组播承载,用IPsec解决加密需求,这种模式下,运维复杂度叠加,建议优先做好IPsec层面的监控,因为GRE层面的问题通常能通过IP层手段暴露出来。
GRE隧道不稳定,从哪几个方向动手排查
如果隧道出现间歇性中断或者丢包,按下面的优先级逐一排查,能省下大量时间:
底层物理链路的质量波动
- 登录两台设备,分别ping隧道对端地址的来源IP,如果物理IP之间也存在丢包,优先处理底层链路,隧道本身无辜背锅。
- 跨运营商场景(比如电信访问联通),中间经过的互联网出口拥堵是常态,可以在隧道两端各自做持续ping记录,对比两端看到的结果差异,定位是哪一侧的运营商网络质量差。
隧道协议参数不匹配
- 检查两端GRE的Protocol类型字段是否一致,比如一端跑的是GRE封装IP(0x0800),另一端配成了MPLS(0x8847),隧道能起来,但数据包封装失败。
- 检查两端是否配置了GRE Key,一端配了一端没配,隧道状态可能显示Up但流量不通。
中间设备的ACL或NAT干扰
- GRE协议号是47,很多企业出口防火墙默认放行ESP和UDP 500/4500,却漏掉GRE协议,检查所有中间设备的ACL,确认是否放行协议号47。
- 如果隧道源地址经过了NAT转换,需要确保NAT设备支持GRE的NAT-T,否则隧道建立后数据面会异常。
组播或广播流量的冲击
- GRE隧道承载组播协议时,带宽利用率会迅速攀升,检查隧道接口的速率统计,如果接近物理带宽上限,优先考虑把组播流量分离到独立隧道,或者减少不必要的组播报文。
隧道两端配置变更时,最容易踩中什么坑
运维工作中80%的隧道故障来自变更操作,不是初始配置错误,以下两类典型场景,建议直接写进变更操作手册:
对端设备替换
换设备后,新设备的隧道参数默认值和旧设备存在差异,比如思科设备的GRE默认开启路径MTU发现,华为设备默认关闭,这个差异会导致隧道在传输大文件时表现完全不一样,替换后必须逐项核对:隧道源目地址、GRE Key、隧道模式(GRE还是GRE over IPsec)、MTU策略。
底层链路割接
底层物理链路割接后,中间路径的MTU限制可能变化,原本1500的MTU走的是全以太网路径,割接后经过了一个MTU 1400的接入点,隧道立刻开始丢包,这类问题在割接后的一到两天内集中爆发,建议割接完成后立即在隧道两端做一次MTU全链路扫描,而不是只测通断。
隧道数量大了之后,如何降低运维负担
单个隧道配置很轻松,但几十条隧道时用手工敲命令的方式就完全不现实了,在脚本顶半边天的运维环境下,建议往自动化方向逐步靠拢。
- 基础设施即代码:把隧道配置从命令行迁移到
Ansible或Python + Netmiko脚本,通过模板渲染生成各端配置,确保两端参数严格匹配,从源头消除人为配置偏差。 - 监控告警统一收口:把隧道状态、流量数据、路由收敛时间统一接入Prometheus或Zabbix,设置分级告警,物理链路丢包超过3%时给P2告警,隧道接口Down给P1告警并触发抢修流程。
- 配置变更双人复核:对生产网络设备执行配置变更前,用
diff工具对比变更前后的配置文件,避免误删其他线路的配置。
Q&A:GRE隧道运维常见问题
GRE隧道延迟突然升高但没有丢包,是什么原因?
最优先排查物理链路的路径变化,GRE隧道只负责封装转发,不引入排队时延,延迟突增大概率是底层路由绕路,比如中间某台设备路由表更新后,流量走了更长路径,使用traceroute对比故障前后的路径节点,定位绕路点,再联系相关网络管理员处理,另外要排查是否触发了隧道两端设备的QoS策略,某些队列在拥塞时会主动增加缓冲时延。
隧道Flapping导致OSPF邻居反复震荡,如何快速止血并根治?
快速止血手段是临时加长OSPF的Dead Interval,从默认的40秒调整到90-120秒,给隧道短暂中断留出缓冲,根治方向分两步:先检查隧道Flapping的根因,通常是对端设备CPU负载过高导致Keepalive报文处理不及时,或底层链路存在间歇性丢包;再针对根因解决,比如调整隧道Keepalive的发送间隔、增加物理链路的冗余备份。
分支站点设备性能很差,跑GRE over IPsec会不会带不动?
取决于分支设备的具体型号和隧道流量,GRE封装本身耗费的CPU极少,瓶颈通常在IPsec加解密部分,老旧的入门级路由器(如单核CPU、无硬件加速)承载超过50Mbps的IPsec流量时,CPU占用率大概率超过80%,影响隧道稳定性,建议在低端设备上关闭IPsec的硬件卸载不可用时,把加密算法从AES-256降级为AES-128,并调低SA的软超时时间,强制更频繁地重新协商,避免长连接造成内存泄露。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/792047.html