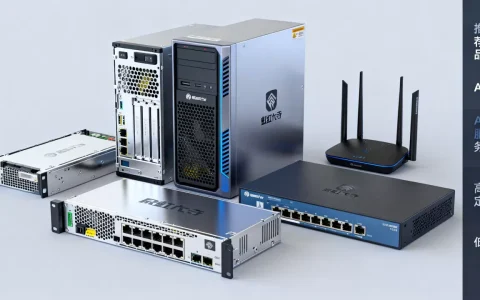
边缘训练服务器不是一张固定清单,主流形态包括边缘GPU服务器、AI边缘训练一体机、加固便携式边缘训练服务器、模块化边缘微数据中心和国产化边缘训练服务器;选型时先看模型规模、显存、功耗和现场网络,再看价格与交付。
很多朋友一搜“边缘训练服务器有哪些”,容易把它想成某个品牌的一款机器,实际不是,边缘训练服务器更像一个“按现场条件改造过的训练节点”,有的像短机箱服务器,有的像带GPU的加固工作站,有的干脆是装进机柜的边缘微数据中心,下面按形态、场景、价格和选型路径拆开说。
边缘训练服务器有哪些?先按形态和用途拆开看
边缘GPU服务器:最接近通用训练节点
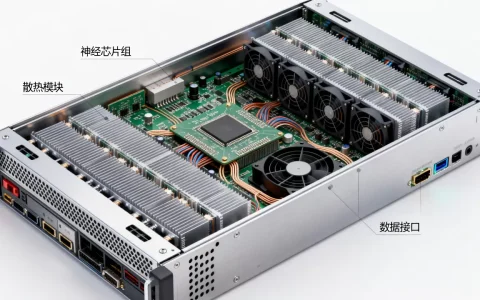
这类产品是边缘训练服务器里最常见的一类,机箱深度较短,支持单卡或双卡GPU,能放在工厂机房、园区弱电间或车载机柜里,公开产品线里,联想ThinkSystem SE350/SE450、戴尔PowerEdge XR系列、浪潮NE5260M5、HPE ProLiant DL20 Gen11等,都属于边缘服务器或短深度服务器范畴,具体能不能做训练,要看GPU配置、供电和散热。
它适合工业质检模型微调、园区视觉算法迭代、港口和矿区的小模型训练,采购时别只看“支持GPU”,要确认单卡显存、PCIe带宽、电源冗余和宽温范围,显存不够,模型连加载都困难。
AI边缘训练一体机:开箱即用但要看生态
一类是面向边缘AI的开发套件和一体机,比如NVIDIA Jetson AGX Orin开发者套件、NVIDIA IGX Orin平台,据NVIDIA官方文档,Jetson AGX Orin面向边缘AI,特点是统一内存和较低功耗,适合视觉算法验证、小模型训练和微调,它不是替代数据中心训练集群的机器,别拿它硬扛大模型全量训练。
这类设备的好处是软件栈相对完整,刷机、容器、推理工具链都有路径,缺点是统一内存和散热边界要提前算清楚,做LoRA微调、小样本视觉训练可以,做多卡并行大训练就不合适。
加固便携与模块化边缘服务器:现场训练和微调场景
加固便携式边缘训练服务器,通常把GPU、存储、交换和UPS装进加固机箱,适合野外、车载、应急场景,模块化边缘微数据中心则把GPU服务器、配电、消防和交换机装进小机柜,适合多节点边缘集群。
这两类机器卖的不只是算力,还有环境适应性和运维便利性,现场没有空调、灰尘大、电压不稳,普通机架服务器容易出问题,采购时要看防尘等级、震动指标、远程管理口和备件周期。
国产化边缘训练服务器:信创项目常见
国产化路线常见鲲鹏、飞腾、海光、昇腾等平台,它们适合有信创要求的园区、能源、交通项目,需要提醒的是,国产化边缘服务器里有些型号定位推理,不是训练,下单前要确认NPU/GPU是否支持训练框架、算子库是否覆盖你的模型。
| 形态 | 典型硬件特征 | 适合场景 | 采购提醒 |
|---|---|---|---|
| 边缘GPU服务器 | 单/双卡GPU、短机箱、宽温 | 工厂、园区小模型训练 | 看显存、功耗墙、散热 |
| AI边缘训练一体机 | Jetson AGX Orin、IGX等 | 视觉微调、算法验证 | 看统一内存和软件生态 |
| 加固便携式 | 加固机箱、GPU、UPS | 野外、车载、应急 | 看防尘、震动、远程运维 |
| 模块化微数据中心 | 机柜、GPU节点、配电 | 多节点边缘集群 | 看消防、承重、空调 |
| 国产化边缘训练服务器 | 昇腾、海光、飞腾等 | 信创项目 | 看框架适配和算子覆盖 |
边缘训练服务器和云端训练服务器有什么区别
训练位置与数据回路不同
云端训练服务器强在规模、并行和弹性,边缘训练服务器强在数据不出场、延迟低、现场闭环快,工业相机拍到的缺陷图片,没必要全传云端,在边缘先做小模型微调,能更快验证效果,行业共识认为,云边端协同会成为算力基础设施的常态,边缘训练不是替代云端,而是补位。
功耗、散热与运维边界不同
云端机房有标准机柜、空调和专职运维,边缘现场可能只有弱电间,温度波动大,供电也不稳定,边缘训练服务器的功耗通常从数百瓦到上千瓦,双卡机型更明显,部署前要算配电、散热和噪音,别把数据中心那套“先上架再说”的做法搬到现场。
成本结构不同
云端训练按需付费,前期投入低,长期高负载要算账,边缘训练服务器一次性采购明显,后续还有备件、巡检和现场运维,比较时别只看整机价格,要把三年电费、网络回传、故障停机算进去。
边缘训练服务器适合哪些应用场景
- 工业质检:在产线旁做缺陷样本微调,减少图片外传。
- 矿区、港口:自动驾驶和视频分析数据在本地做小模型训练。
- 变电站、风电场站:巡检图像在边缘侧做增量训练。
- 医疗影像:在院内完成脱敏后的小模型微调,降低数据流转风险。
- 零售视觉:门店端做陈列识别模型迭代,网络不稳定也能跑。
部署前先做一轮现场验证,登录节点后执行:
nvidia-smi --query-gpu=name,memory.total,power.limit --format=csv
lscpu
free -h
lsblk
nvme list
再跑容器验证:
docker run --gpus all nvidia/cuda:12.4.0-base-ubuntu22.04 nvidia-smi
如果是多节点边缘集群,检查:
kubectl get nodes -o wide
kubectl describe node <节点名> | grep -E 'Allocatable|Capacity'
这些命令能快速看出GPU是否识别、显存多大、功耗墙多少、存储和内存是否够用,比只看彩页靠谱。
边缘训练服务器价格大概多少钱
价格区间受哪些因素影响
边缘训练服务器价格大概多少钱,不能一句话报死,入门单卡边缘GPU服务器常见在几万元级,双卡、宽温、加固或国产化机型会到十几万到几十万元级,影响价格的主要是GPU型号和显存、机箱加固等级、电源冗余、宽温能力、存储容量、国产化适配和本地服务。
业内专家指出,边缘训练设备的预算不能只算硬件,软件适配和现场运维常常被低估,一个模型在实验室能跑,到现场可能卡在驱动、框架版本、散热降频或网络存储上。
采购时怎么算总拥有成本
- 硬件:整机、GPU、NVMe、交换机、UPS。
- 机房:配电、空调、机柜、消防。
- 软件:操作系统、容器平台、训练框架适配。
- 运维:巡检、备件、远程管理、现场支持。
- 电费:按功耗和当地电价估算,双卡机型要单独算。
深圳边缘训练服务器厂家有哪些?本地选型看什么
深圳边缘训练服务器厂家有哪些,这个问题要分两层看,一层是整机和工控厂商,另一层是品牌方案商和渠道集成商,深圳本地既有华为、浪潮、联想等品牌的方案与渠道体系,也有研华、凌华等工控方向的产品线,还有不少做加固机箱、边缘机柜和行业集成的公司,采购时别只问“有没有货”,要问本地能不能交付、有没有备件、能不能配合现场测试。
本地选型重点看四件事:
- 交付能力:样机能否到现场跑你的模型。
- 备件周期:GPU、电源、风扇有没有本地库存。
- 宽温与防护:现场温度、灰尘、震动是否匹配。
- 国产化适配:信创项目要确认框架和算子支持。
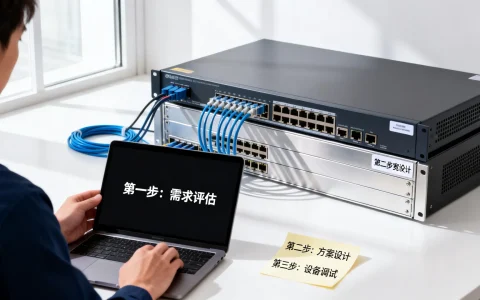
边缘训练服务器怎么选?按五步走
- 先定模型:参数量、输入分辨率、微调方式,全量训练和LoRA微调对显存要求完全不同。
- 再定显存:边缘训练建议单卡显存不低于24GB,做视觉微调更稳妥;大一点的分辨率或批量要往上加。
- 算功耗和散热:看电源功率、功耗墙、现场空调和噪音限制。
- 验证软件栈:PyTorch、TensorFlow、昇腾或海光适配版本,先在样机上跑通。
- 定运维方式:带外管理、远程开关机、日志回传、备件更换路径。
选型时可以用一条命令看功耗边界:
nvidia-smi -q -d POWER
需要限功耗时,在确认支持的前提下执行:
sudo nvidia-smi -pl 150
温度监控可以配合:
sensors
这些操作能帮你判断机器在边缘现场能不能稳住。
边缘训练服务器常见问题Q&A
边缘训练服务器能训练大模型吗?
不能按数据中心集群的标准做全量大模型训练,它更适合小模型训练、视觉模型微调和LoRA、QLoRA这类参数高效微调,模型规模受显存、带宽和散热限制,先做样机验证再定。
边缘训练服务器和推理服务器能混用吗?
可以混用,但要评估,训练更吃显存和带宽,推理更看延迟和能效,混用会让散热和功耗余量变紧,建议把训练任务放在固定时间窗,并监控降频。
深圳采购边缘训练服务器要注意什么?
看本地交付、备件库存、宽温能力和国产化适配,样机到现场跑通训练脚本、容器和远程管理,再谈批量采购,边缘训练服务器的核心不是品牌名单,而是你的模型在现场能不能稳定跑完一轮训练。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/793222.html