GPU显卡渲染服务器、CPU集群渲染节点、云渲染服务器,以及出厂预装好渲染环境的渲染一体机,选哪一类,取决于你的渲染器吃显卡还是吃处理器。
先把“专门”两个字拆开看
普通服务器追求的是低负载、长在线、IO均衡,渲染服务器干的活不一样,它是把一帧画面从零算出来,开机即满载,一跑几小时甚至几十小时,设计重心因此偏移:多卡GPU并行、大显存、大内存、高功率供电、强散热、高速共享存储,样样都要顶得住。
业内专家指出,渲染负载的典型特征是“长时满载、素材突发读取、成片批量写盘”,这类工况对电源余量和散热风道的要求,比常规业务服务器苛刻得多,一台配了四张旗舰显卡的机器,峰值功耗轻松越过两千瓦,普通机箱和普通电源根本扛不住。
渲染服务器和普通服务器有什么区别
| 维度 | 普通业务服务器 | 专门渲染服务器 |
|---|---|---|
| 算力核心 | CPU为主,核数适中 | 多卡GPU,或高核数CPU集群 |
| 内存容量 | 32GB至128GB常见 | 128GB起步,256GB不稀奇 |
| 供电设计 | 单电源或1+1冗余,功率中等 | 高功率,多卡机型普遍2000W以上 |
| 散热 | 风冷即可,对噪音不敏感 | 需要强风道或水冷,机架机型看风压 |
| 存储 | 本地SSD加集中存储 | 高速NAS或分布式存储,素材动辄TB级 |
| 运行特征 | 常驻低负载 | 长时间满载,跑完即停 |
差异落到采购上就是一句话:别拿通用业务服务器的配置单去套渲染场景,内存、电源、散热三项最容易踩坑。
市面上能买到的专门渲染服务器有哪几类
GPU渲染服务器:显卡渲染的主力
这是目前最主流的一类,按形态再分:
- 塔式多卡机:4卡以内,放工位旁边就能用,噪音偏大,适合中小团队和独立工作室。
- 机架式4U多卡机:8卡甚至10卡,进机柜,集中散热和供电,适合有一定规模的制作公司。
- 高密度GPU节点:面向渲染农场,讲究单位机柜的算力密度和统一管理。
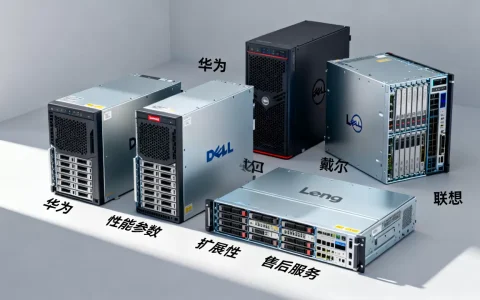
整机品牌上,戴尔PowerEdge、HPE ProLiant、联想ThinkSystem、超微、浪潮、宁畅都有对应的GPU机型,显卡侧常见RTX 4090、RTX 5090这类消费旗舰,也有RTX 6000 Ada、L40S、A100、H100这类专业卡和数据中心卡。
CPU集群渲染节点:渲染农场的骨架
以高核数处理器为主,单节点几十核,几十上百台节点组成集群,传统光线追踪渲染器和部分后期合成、解算任务仍然吃CPU,这类节点的单机价格不高,但规模和调度是门槛,采购时更看重统一镜像和批量部署能力。
云渲染服务器:按小时买算力
简米云、酷番云、华为云、火山引擎等都有GPU实例,渲染农场平台如瑞云、蓝海创意云、渲云提供打包好的渲染服务,优势是弹性,项目来了就开,项目走了就关;劣势是长期高频使用成本会反超自建。
渲染一体机:开箱即用
厂商预装好驱动、渲染器、授权管理和队列软件,插电就能提交任务,适合不想折腾环境、又没有专职运维的团队,价格通常比同配置自装机高一截,买的是省心。
影视动画渲染服务器配置推荐:按渲染器倒推硬件
先看渲染器,再看硬件,顺序反了容易白花钱。
| 渲染器 | 主导算力 | 显存敏感度 | 备注 |
|---|---|---|---|
| V-Ray | GPU/CPU均可 | 高 | GPU模式显存吃紧时自动回落CPU |
| Arnold | CPU为主,GPU版可用 | 中 | 大场景内存比显存更关键 |
| Redshift | GPU | 很高 | 显存不够直接报错,不回落 |
| Octane | GPU | 很高 | 对显存容量极其敏感 |
| Blender Cycles | GPU/CPU | 高 | 支持多卡与混合渲染 |
| Corona | CPU | 低 | 核数与内存优先 |
三个可验证的实操检查点
- 装完驱动先跑
nvidia-smi,确认所有卡都被识别、显存容量与型号无误、功耗上限没有被限死。 - 用
lspci | grep -i nvidia核对PCIe链路,多卡机器要确认每张卡跑在足够的通道数上,否则多卡加速会打折。 - 打开渲染器的设备设置,逐个勾选GPU,跑一张测试帧,看显存峰值占用,峰值贴着上限,就该考虑换更大显存的卡。
云渲染服务器怎么选:三种场景对照
项目制、短周期
片子集中在这几个月,做完就闲,按需开实例最划算,用完释放,操作路径大同小异:登录云控制台,进入弹性计算,选GPU实例规格,挑带渲染环境的镜像,挂载NAS,装渲染器,配置浮动授权,提交队列。
长期稳定产能
一年到头机器不停,自建或长租更合适,行业共识认为,当月均GPU使用时长超过某个临界点后,自建的总拥有成本会明显低于按量付费,具体临界点随卡型和电价浮动。
素材不能出内网
影视、建筑、军工类项目对数据合规要求高,云上跑不了,只能本地部署或选择支持私有化交付的渲染方案,这时候高密度机架节点加内网调度系统是标准答案。
渲染服务器多少钱一台:成本构成拆解
| 类型 | 大致投入 | 适合谁 |
|---|---|---|
| 单卡塔式渲染机 | 数万元级 | 独立创作者、小型工作室 |
| 4卡机架式 | 十万元级 | 中型制作团队 |
| 8卡高密度节点 | 数十万元级 | 渲染农场、大型公司 |
| 云渲染实例 | 按小时计费 | 项目波动大的团队 |
价格的大头在显卡,其次是内存和存储,同一个机箱,显卡从消费旗舰换成数据中心卡,整机预算可能翻几倍,另外别忽略授权成本:多数商业渲染器的浮动授权按节点或按核收费,几十台节点的授权费往往和硬件一个量级。
北京渲染服务器租用与本地部署怎么权衡
北京这类制作公司密集的城市,常见做法是机房托管而不是放办公室,原因很实在:多卡机器噪音大、发热高,办公区扛不住;托管机房有稳定电力和带宽,异地团队也能远程提交任务。
判断标准可以简化成三条:
- 素材体量以TB计、需要频繁回传,优先本地部署加专线。
- 团队分散在多地、需要统一调度,托管或混合部署更顺。
- 项目峰值明显、平时机器闲置,租用或云渲染更省钱。
租用谈价时问清楚三件事:带宽是独享还是共享、电费怎么计、故障响应时限写在合同哪一条。
机器到手,先跑通这几步
- 装驱动与CUDA:用官方仓库或厂商提供的脚本,版本和渲染器要求对齐,别盲目追新。
- 验证多卡:
nvidia-smi看设备列表,nvidia-smi topo -m看卡间互联拓扑。 - 配授权:浮动授权服务器地址写进渲染器配置,确认节点能借到License。
- 挂共享存储:
mount -t nfs 存储IP:/渲染工程 /mnt/project,路径权限要让所有渲染账号可读可写。 - 上队列:部署Deadline、OpenCue或Afanasy一类的调度系统,把节点加进池子,先提交一帧试跑。
- 压测与监控:连续跑两小时以上,盯温度和功耗墙,确认没有降频。
关于渲染服务器的常见问题
专门渲染服务器一定要用专业显卡吗
不一定,消费级旗舰卡在多数GPU渲染器里性价比很高,显存够、驱动稳就能干活,专业卡和数据中心卡的优势在于更大显存、更长保修、多卡互联和虚拟化支持,预算充足且节点密集时更省心。
云渲染服务器和自建渲染服务器哪个划算
看使用强度,项目零散、峰值明显,云上按小时付费更灵活;机器常年满载,自建的长期成本更低,折中方案是自建基线产能、云上补峰值,调度层统一管理。
渲染服务器显存要多大才够
取决于场景复杂度和渲染器,Redshift、Octane这类不回落CPU的渲染器,显存不足会直接中断任务,选卡时按测试帧的峰值占用留出余量是稳妥做法,大场景建筑动画和毛发特效,显存需求明显高于产品静帧。
专门渲染服务器没有“最好”的一种,只有和你的渲染器、项目节奏、数据合规要求对得上的那一种,先把渲染器吃卡还是吃U搞清楚,再谈品牌和价格,钱才花在刀刃上。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/795207.html