服务器检测不是跑个鲁大师那么简单,它是一场覆盖硬件、系统、网络、安全和性能的全面体检,核心目的是在故障发生前发现隐患。不管是自有机房的老机器,还是云上租的实例,检测思路都相通,但侧重点各有不同,下面按实际运维场景,拆开讲清楚每一步该做什么、怎么做。
先搞明白:服务器要做哪些检测,为什么不能只看表面
很多朋友觉得服务器能开机、能访问网页就万事大吉,这其实是个大误区,硬件老化是渐进过程,比如硬盘坏道是从零星几个开始扩散的,内存错误也是偶尔报一次然后越来越频繁,行业共识认为,超过70%的服务器宕机事件,在发生前两周都有迹可循,只是常规体检没做到位。
服务器检测的核心逻辑是“四层递进”:第一层看硬件健康,第二层看系统状态,第三层看安全防护,第四层看性能余量,这四层缺一不可,只盯着CPU使用率,就好比只查体温不查血压,隐患自然发现不了。
服务器硬件检测方法:揪出沉默的“硬伤”
硬件检测是地基,重点排查五个部件,每个都有对应的高性价比检测手段。
CPU与内存:用压力测试逼出隐性故障
CPU坏的概率低,但散热器积灰或硅脂干涸会导致高温降频,检测分两步:
- 查看当前负载和温度,用
top或htop看负载均值,用sensors看核心温度。 - 进行压力测试,跑
stress或Prime95,持续30分钟以上,如果过程中出现死机或报错,基本可以锁定CPU或主板供电问题。
内存检测更推荐用 MemTest86 制作U盘启动盘,开机引导后跑完整四遍,这里有个实操细节:不要只跑一遍,内存颗粒的坏块往往需要多次读写才能暴露,检测过程中如果出现红色报错,大概率需要更换内存条,云服务器用户跑不了这个,可以改用 memtester 命令在系统内测试,但覆盖度会打折扣。
硬盘:重点看SMART信息和坏道
机械硬盘和固态硬盘的检测方法差异很大。
- 机械硬盘:用
smartctl -a /dev/sda查看SMART信息,重点关注 Reallocated_Sector_Ct(重映射扇区数) 和 Current_Pending_Sector(待映射扇区数),这两个数值只要非零就说明盘体在恶化,再用badblocks做只读扫描,确认坏道分布。 - 固态硬盘:同样看SMART,但重点转向 Wear_Leveling_Count(磨损均衡计数) 和 Percentage_Lifetime_Remain,这两个指标直接反映闪存寿命剩余。
电源与散热:最容易被忽略的“隐形杀手”
电源老化不会报错,但会表现为机器随机重启或带不动高负载,检测方法是用 OCCT 的电源测试模式,把CPU和显卡拉到满载,观察电压波动,如果5V或12V电压偏移超过5%,建议直接更换。
散热检测更简单,开机进BIOS看风扇转速,再结合系统内温度对比,如果风扇转速异常低或温度异常高,打开机箱清灰,顺便检查导热硅脂是否干裂。
云服务器与物理服务器:检测项目的差异化对比
物理服务器和云服务器的检测方式差异巨大,云服务器本质是虚拟化环境下的一个“租户”,你测不到真实的CPU温度,也摸不到硬盘的SMART信息,两者的侧重点完全不同:
- 物理服务器:侧重硬件健康,包括硬盘SMART、内存检测、电源电压、机房温湿度,网卡固件和RAID卡电池状态也需要定期检查,RAID卡电池失效会导致写缓存失效,严重影响磁盘性能。
- 云服务器:侧重实例性能和宿主机稳定性,检测指标集中在 CPU steal(偷取时间) 和 网络丢包率,用
top查看%st字段,如果持续超过10%,说明宿主机资源争抢严重,需要考虑升级实例规格或迁移可用区。 - 价格差异:自购物理服务器一台2U机架式成本在2-4万元,加上机房托管费用每年大几千;云服务器按年付费用,4核8G实例大概一年几千到一万多元,预算有限且业务波动大,选云服务器更划算;对数据主权和硬件掌控要求高,物理机仍是刚需。
系统与软件层面:日志和文件系统是照妖镜
硬件没问题,不代表系统稳定,系统层面的检测主要关注三个方向。
系统日志:排查异常的“案发现场”
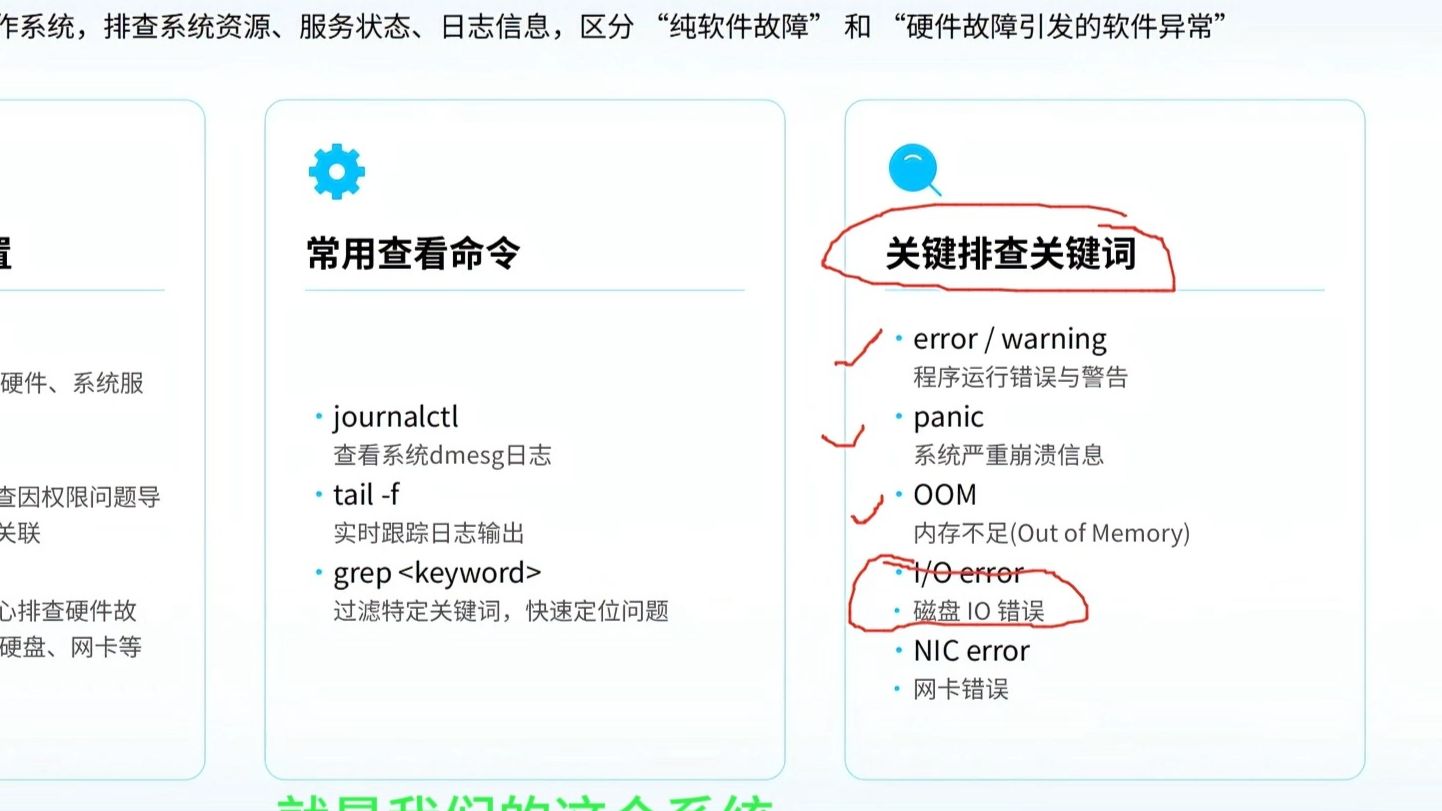
用 journalctl -xe 和 dmesg 查看内核日志,搜索关键字 error、fail、timeout 和 oom,特别要关注 OOM Killer 记录,这表示内存已经耗尽,系统开始强杀进程,如果频繁出现,说明内存容量已经到了临界点,需要扩容或者优化应用内存占用。
文件系统:检查inode和磁盘挂载状态
执行 df -h 看磁盘空间,执行 df -i 看inode数量,大部分运维新手只看空间不看inode,inode占满会导致无法创建新文件,即使空间还剩很多,文件系统只读错误也需要排查,检查 /etc/fstab 配置和实际挂载状态,用 mount -o remount,rw / 尝试恢复读写。
系统更新与内核漏洞
这个容易被漏掉,但很重要,在正式环境执行 yum update 或 apt upgrade 前,建议先在测试机验证兼容性,内核版本过低会带来已知CVE漏洞,比如Dirty Pipe这类提权漏洞,攻击者利用后可直接获取root权限,用 uname -r 查内核版本,再对照公开漏洞库确认是否存在风险。
安全检测方案:没有绝对安全,只有持续排查
安全检测是运维日常最花费精力的环节,重点检查账号、端口和后门这三个方向。
弱口令与账号异常
检查 /etc/passwd 文件中是否有异常UID为0的账号,用 last 查看登录记录,确认有没有陌生IP登录。root密码必须符合复杂度要求,SSH建议禁用密码登录,改用密钥认证,如果业务确实需要密码登录,建议安装 fail2ban 自动封禁暴力破解IP。
网络连接与监听端口
执行 netstat -antlp 或 ss -tulnp 检查所有监听端口,对比已知业务端口清单,如果发现有开放但未知的端口,立即用 lsof -i:端口号 定位对应进程,常见木马会伪装成系统进程名,crond 写成 cronrd,需要核对进程路径是否在 /usr/sbin 或 /bin 下。
Web环境专用检测
如果服务器运行网站,还要额外检查Web目录下的恶意文件,用 find /www/wwwroot -name ".php" -mtime -7 查找最近7天被修改的PHP文件,重点关注包含 eval、base64_decode、system 等危险函数的文件,这类一句话木马是入侵后门的重灾区。
服务器性能测试怎么做:用数据评估承载能力
性能检测分两个维度:容量评估 和 瓶颈定位,业务上线前做容量评估,运行中做瓶颈定位。
压测工具选择与操作方法
- CPU性能:用
sysbench cpu run跑素数计算,测试单核和多核性能。 - 内存性能:用
sysbench memory run测读写带宽。 - 磁盘性能:用
fio执行随机读写测试,命令参考fio -filename=/tmp/testfile -direct=1 -rw=randrw -bs=4k -size=1G -numjobs=4 -runtime=30 -group_reporting,重点关注IOPS和平均延迟。 - 网络带宽:用
iperf3在服务器和客户端之间互跑,测试TCP吞吐量。
分析维度与业务匹配
压测结果不能只看峰值,要看 P99延迟 和 错误率,比如数据库服务器跑混合读写测试,P99延迟超过100毫秒就说明磁盘性能跟不上业务需求,Web服务器压测时重点关注并发连接数超过阈值后,响应时间是否出现悬崖式增长。
如果是云服务器,建议整机压测时顺带用 sar -q 查看负载均值,配合云监控平台看宿主机侧的网络流量曲线,识别是否被限流。
服务器巡检多少钱一次:价格与价值如何权衡
很多中小企业纠结要不要找第三方做专业巡检,这里说下市场行情:单次全面巡检价格一般在 500到3000元 之间,差异取决于服务器数量、检测深度和是否包含安全渗透测试,基础巡检(硬件健康+系统日志+安全基线)大概500元左右,中大型机房的月度巡检套餐可能在2000元以上。
这笔钱花得值不值?大型互联网公司普遍有专职运维团队,自检成本极低,但中小企业没有专职运维,服务器扛着核心业务,一旦故障就是几小时的业务停摆,损失远超几千块巡检费。采购第三方巡检服务前,确认对方是否提供检测PDF报告,并且包含修复建议,这才是巡检的核心价值。
关键建议:建立检测频率和文档机制
检测做一次不够,要形成周期制度,建议采用如下频率:
- 每周:查看磁盘空间、 inode使用量、系统负载、登录日志。
- 每月:执行一次全面性能压测和硬件SMART健康检查。
- 每季度:进行一次漏洞扫描和Web后门排查。
- 每半年:机房物理巡检,检查硬件积灰情况和电源模块健康状态。
每次检测后把结果归档到运维文档,形成数据基线,下次检测时对比数值变化趋势,比如磁盘健康度下降的斜率,能提前预判硬件寿命,比单纯看当前值准得多。
Q&A:服务器要做哪些检测的相关高频疑问
Q1:服务器检测频率是多久一次才合理?
日常轻量检查建议每周一次,重点关注磁盘空间、负载、登录日志,深度压力测试和硬件扫描每月做一次,业务高峰期前加做一次全量检测,以上频率适用于大多数中小型业务场景,成本可控且能覆盖主要风险。
Q2:云服务器检测和物理服务器检测有什么区别?
云服务器的硬件抽象化,无法检测真实硬盘SMART和CPU温度,但可以检查宿主机层面的性能剥夺情况,比如CPU steal值,物理服务器重点在硬件健康,云服务器重点在实例性能和依赖的云产品健康,检测项目侧重不同。
Q3:服务器巡检的价格受哪些因素影响?贵不贵?
服务器巡检价格主要受操作系统类型、检测项数、是否需要业务高峰值守、以及是否包含安全扫描影响,Windows系统巡检通常比Linux稍贵,因为自动化工具相对少,一台机器千元上下的巡检费用,核心价值在于能提前发现硬件劣化和安全短板,避免宕机带来的更大损失。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/796932.html