临沂物流路径优化算法租GPU,先判算法是CPU启发式还是GPU张量计算,再用显存下限、精度需求、吞吐上限三步匹配档位;多数VRP启发式用中端卡甚至CPU集群更划算,深度强化学习和GNN训练才需要A100/H100级。 这句话听着反直觉,但能把租用预算花在刀刃上。
临沂物流路径优化算法GPU租用怎么选档位?先拆算法再谈卡
路径优化算法到底吃CPU还是吃GPU
临沂物流企业常见的路径优化,不是单纯“算一条最短路线”,它往往要同时处理多仓调拨、多车型、时间窗、装载率、实时交通和司机排班,落到算法上,多是CVRP、VRPTW、PDPTW这类车辆路径问题。
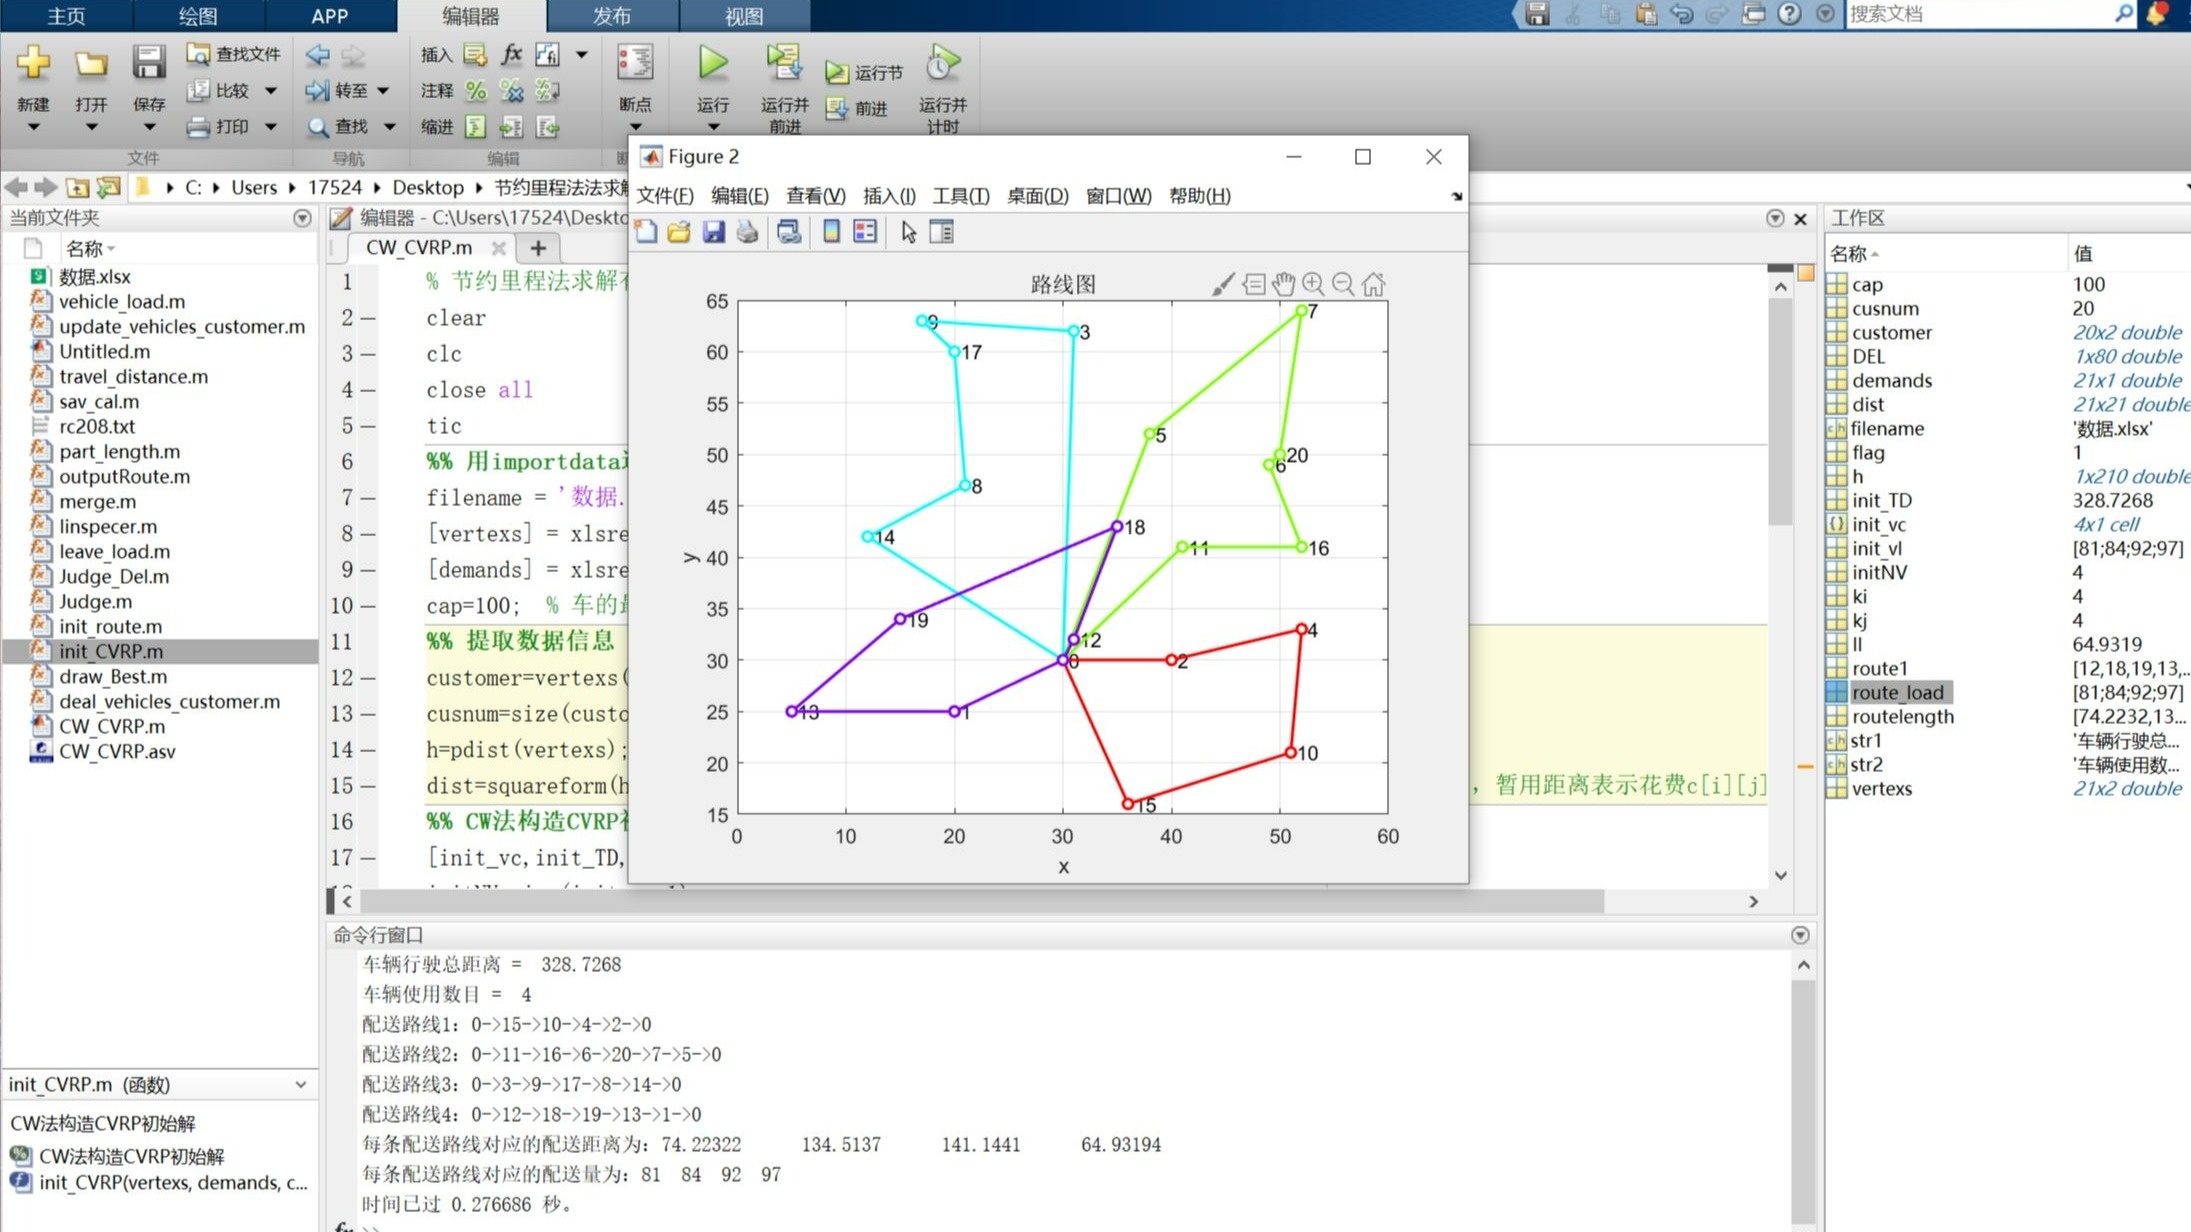
这类问题的主流求解方式分两派:
- CPU启发式派:遗传算法、蚁群算法、禁忌搜索、模拟退火,以及OR-Tools里的路径求解器,它们大量做邻域搜索、约束检查和分支定界,主要吃CPU单核性能、多核并行和内存带宽,GPU不是主角。
- GPU张量派:深度强化学习做路径决策、图神经网络学习路网和订单关系、大规模距离矩阵计算、实时批量推理,这些任务矩阵运算密集,GPU才有明显价值。
业内专家指出,路径优化里“上GPU就快”是常见误解,先把算法跑一遍profile,看看时间花在Python循环、约束检查还是矩阵乘法上,再决定租什么卡,操作路径不复杂:登录实例先跑nvidia-smi看驱动和显存,再跑python -m torch.utils.collect_env核对PyTorch与CUDA版本,最后用nvidia-smi dmon -s pucvmet观察GPU利用率和显存占用,如果GPU利用率长期很低,加钱换高档卡意义不大。
临沂物流场景的算力画像
据中国物流与采购联合会公开信息,临沂商贸物流的典型特征是货源品类多、干线支线交织,路径优化往往不是单点求解,而是多仓、多车型、多时间窗一起算,这带来两个算力特征:
- 求解频次高:城配和干线调拨可能每天多次滚动优化,推理延迟比单次训练更敏感。
- 数据规模跨度大:小到几十个网点,大到上千个客户点、几百台车,显存和内存需求差别很大。
所以匹配GPU档位时,别只看“卡皇”,先看你的算法是离线训练、批量求解,还是在线实时推理,离线训练可以包月租高卡,在线推理更适合按量租中端卡,忙时扩容。
三步匹配法:显存下限、精度、吞吐
我习惯用下面三步,把档位选择变成可验证的动作:
- 压测显存下限:从几十个点、几百个点、上千个点逐级跑,记录
nvidia-smi里的显存峰值,显存不够会直接OOM,这是硬门槛。 - 确认精度需求:路径优化里的距离矩阵、图嵌入训练常用FP32/TF32/FP16,若算法依赖FP64,消费级卡会被明显限制,A100/H100更稳。
- 再看吞吐上限:同样显存下,看每小时能跑多少轮训练、每天能出多少版路径方案,吞吐不够再考虑多卡,别一上来就堆卡。
多卡时还要看互联。nvidia-smi topo -m能看出是PCIe还是NVLink,路径优化里的GNN训练对卡间通信敏感,NVLink机型更适合多卡并行;只是批量推理,PCIe机型通常够用。
物流路径优化算法GPU服务器租用场景:按任务类型配档位
中小规模实验与推理:RTX 4090、L40S
如果你是临沂本地物流企业的算法小组,先做方案验证、小规模DRL推理、距离矩阵CUDA加速,RTX 4090 24GB这类卡性价比高,它适合单机调参、少量并发推理、把CuPy或cuDF跑起来。
当模型显存涨到二十多GB以上,或者要同时跑多个推理实例,L40S 48GB更从容,它的定位是均衡档:显存比4090宽,适合中等规模GNN训练、批量路径推理、多实例部署,租用方式上,验证期按量租,稳定后再包月。
大规模训练与多卡:A100、H100
路径优化一旦上到深度强化学习、图神经网络、多仓联合训练,显存和带宽会迅速吃紧。A100 80GB是训练主力档,适合大规模DRL/GNN训练、多卡并行、较大batch size。H100 80GB更适合超大规模训练和NVLink集群,预算充足且任务确实吃满时再上。
这里有个实操判断:先单卡跑通,再CUDA_VISIBLE_DEVICES=0 python train_vrp.py限定单卡压测,单卡显存和吞吐都摸清了,再决定是否多卡,容器环境可以用docker run --gpus all -it --rm pytorch/pytorch:2.x-cuda12.x快速验证,别在裸机上反复折腾驱动。
常见档位对比
| GPU档位 | 显存公开规格 | 适合的路径优化任务 | 租用定位 |
|---|---|---|---|
| T4 | 16GB | 轻量推理、教学验证 | 入门 |
| RTX 4090 | 24GB | 中小规模DRL推理、距离矩阵加速、单机调参 | 成本友好 |
| L40S | 48GB | 中等规模GNN训练、批量推理、多实例 | 均衡档 |
| A100 | 40GB/80GB | 大规模训练、多卡并行 | 训练主力 |
| H100 | 80GB HBM | 超大规模训练、NVLink集群 | 高预算 |
路径优化算法用A100还是RTX 4090:按求解规模和精度分档
这是临沂物流技术团队问得最多的一组对比,答案不在卡本身,在任务边界。
- 选RTX 4090的场景:算法以CPU启发式为主,GPU只做距离矩阵加速;DRL模型参数量不大,单卡24GB够用;团队处于方案验证期,租用周期短。
- 选A100的场景:GNN或DRL训练显存经常逼近上限;需要多卡并行缩短训练时间;算法涉及FP64或大batch训练;长期稳定训练,吞吐比单卡价格更重要。
- 选L40S的中间场景:显存需求超过24GB但没到80GB;推理并发量中等;希望一张卡兼顾训练和部署。
行业共识认为,GPU档位匹配要按显存和精度先卡下限,再按吞吐选上限,先跑nvidia-smi和gpustat看峰值,再决定是否升级,比看参数表靠谱。
临沂物流企业GPU算力租用一个月多少钱:按卡型和时长拆账
“一个月多少钱”不能只问单价,GPU算力租用通常按卡型、时长、存储、带宽和公网IP拆账,近年来,临沂本地及周边算力租用供给变多,按量、包月、竞价实例都有,价格随市场浮动。
询价时建议按这个路径问清楚:
- 计费粒度是按秒、按小时还是按天,停机是否继续计费。
- 显存和带宽是否独享,磁盘是本地盘还是网络盘。
- 镜像里是否含CUDA、PyTorch、OR-Tools,避免自己装环境耗时。
- 多卡机型是否真NVLink,还是PCIe拼接。
- 故障赔付和迁移窗口怎么算。
成本控制上,训练任务用包月或长期租用摊薄单价,推理和压测用按量实例,跑完即释放,把nvidia-smi dmon监控接进告警,GPU利用率长期偏低就降档,别让高卡空转。
说到底,临沂物流路径优化算法租GPU不是买峰值,而是买匹配,把算法瓶颈、显存下限和租用成本三件事对齐,档位自然就清楚了。
临沂物流路径优化算法算力租用GPU档位匹配Q&A
临沂物流路径优化算法一定要用GPU吗?
不一定,以OR-Tools、遗传算法、禁忌搜索为主的VRP求解,CPU多核加内存往往更划算,只有距离矩阵大规模并行、DRL训练、GNN训练和批量推理时,GPU才值得租,先profile再决定。
路径优化算法用A100还是RTX 4090,预算有限怎么选?
预算有限先租RTX 4090做验证,显存和吞吐摸清后再决定是否升A100,若模型频繁OOM、多卡训练是刚需、算法依赖FP64,就直接考虑A100档;否则4090加CPU集群的组合更务实。
临沂物流企业GPU算力租用一个月多少钱,怎么控制成本?
费用按卡型、时长、存储和带宽综合计费,具体以服务商报价为准,控制成本靠按量压测、包月跑稳定训练、监控利用率及时降档,按量租用按秒或按小时计费,包月按整月计费,账单周期以合同为准。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/797117.html