服务器连接数低,直接改三个地方:系统文件描述符上限、TCP内核参数、Web服务自身配置,多数情况下能解决八成问题。先别急着加机器,把这几层阈值捋一遍,很多“连接数上不去”其实是软件层面的限制没放开。
连接数低,先判断是“被动拒绝”还是“主动断开”
很多朋友一看到连接数低就慌,其实得先分清楚状态。被动拒绝是连接根本进不来,客户端直接报“连接超时”或“拒绝连接”。主动断开是连接建立起来了,但马上被服务端掐掉,日志里常见“connection reset by peer”。
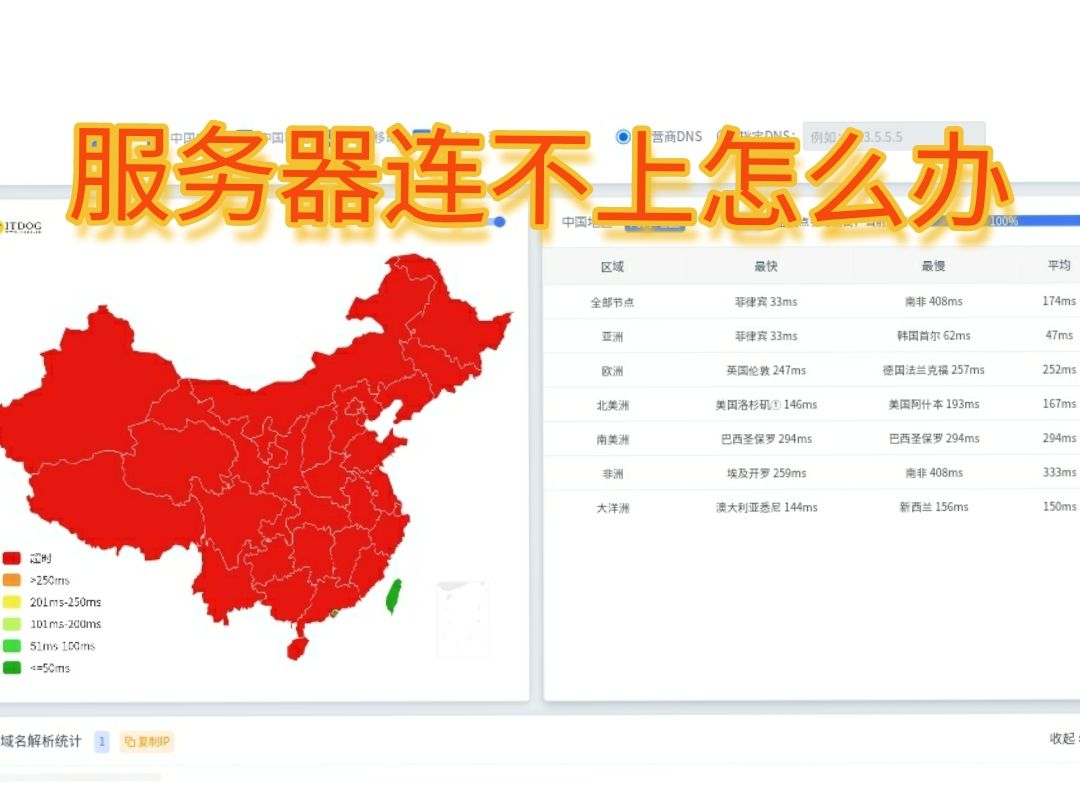
这两个方向排查路径完全不同,被动拒绝,重点看最大连接数配置和系统文件描述符(FD)限制,主动断开,重点看超时设置和并发处理能力,顺序乱了,效率极低。
用一条命令看清当前系统上限
先执行 ulimit -n,这个数字是单个进程能打开的最大文件描述符数量,进程每接收一个TCP连接,就要占用一个FD,如果这个值是1024,那并发连接数最多也就一千出头,算上日志、监听套接字、内部通信消耗,实际能用的也就八九百,这就是经常被忽略的“隐形天花板”。
- 查看当前用户限制:
ulimit -n - 查看全局硬限制:
sysctl fs.file-max - 查看当前已用连接数:
ss -s - 查看具体进程占用FD数:
ls /proc/你的进程PID/fd | wc -l
临时放开和永久生效的改法
先用 ulimit -n 65535 临时修改,验证一下当前配置是否有问题,如果改完连接数立刻上去了,说明问题就出在这,永久修改需要编辑 /etc/security/limits.conf,加上:
 soft nofile 65535
 hard nofile 65535
再加上 fs.file-max 的内核参数调整,修改 /etc/sysctl.conf:
fs.file-max = 100000执行 sysctl -p 生效,行业共识认为,多数云主机默认的可用FD数量,只有实际需求的三分之一左右,这一步改完,连接数往往能翻倍。
服务器连接数过低原因,重点排查TIME_WAIT和半连接队列
如果FD和文件限制都调大了,连接数还是上不去,那就是TCP协议栈层面的问题,连接数低的原因非常多,但实际运维中,TIME_WAIT过多和半连接队列溢出占了相当大的比例。
TIME_WAIT堆积是怎么把连接数拖垮的
TCP关闭连接后,主动关闭方要停留一段时间在TIME_WAIT状态,默认60秒,高并发短连接场景下,大量连接同时进入TIME_WAIT,这些连接虽然不占FD,但占端口和内存,端口耗尽之后,新连接自然建不起来。
用 netstat -ant | grep TIME_WAIT | wc -l 看看数量,如果这个数经常上万,说明短连接太多或者连接的复用没有生效。
调整内核参数 /etc/sysctl.conf:
net.ipv4.tcp_tw_reuse = 1
net.ipv4.tcp_fin_timeout = 30注意,tcp_tw_reuse 是让客户端可以复用TIME_WAIT状态的连接,只在客户端生效,服务端想解决这个问题,更好的办法是打开长连接,或者让下游主动断开,这是服务器连接数设置多少合适的关键判断点服务端别追求极端短超时,反而应该适当拉长keepalive时间。
半连接队列溢出时,症状很隐蔽
连接数低还有一种情况:客户端感觉响应慢,但服务端CPU和内存都很闲,这时候要查半连接队列是否溢出。
执行 netstat -ant | grep SYN_RECV | wc -l,如果数量持续增长且堆积,说明SYN洪水或者accept处理不过来。
关键参数是 net.ipv4.tcp_max_syn_backlog 和 net.ipv4.tcp_syncookies:
net.ipv4.tcp_syncookies = 1
net.ipv4.tcp_max_syn_backlog = 8192
net.ipv4.tcp_somaxconn = 1024
tcp_somaxconn 这个参数很多人只改内核不改应用层。Nginx和Tomcat都有自己的backlog配置,Nginx里叫 listen 80 backlog=1024;,Tomcat里叫 acceptCount,内核和应用层的backlog是取小值,只改一边等于没改。
服务器连接数满怎么排查?按应用层逐级拆解
系统层调完了,接着看应用层。服务器连接数满怎么排查,思路是从外到内一层层剥:防火墙限制 → 应用服务器连接池 → 数据库连接池。
防火墙和云安全组别忽略
很多情况是云厂商安全组限制了并发连接数,或者iptables规则里有 connlimit 模块在限流,查一下:
- 云控制台安全组规则是否限制了并发
iptables -L -n | grep connlimit- 服务器端口的连接状态是否被syncookie干扰
如果部署了DDoS高防或者Web应用防火墙,这些中间设备的连接数限制往往比服务器本身低得多。连接数上不去,先ping一下经过了多少层代理,每一层都可能成为瓶颈,这是服务器连接数低怎么办最容易被忽略的场景。
PHP-FPM和Java线程池的并发上限
以常见的PHP-FPM为例,配置在 php-fpm.d/www.conf 里:
pm.max_children = 50
pm.start_servers = 20
pm.max_spare_servers = 35
max_children 是PHP进程数,每个进程同时处理一个请求,设小了,连接进来后都在排队,表现为连接数上不去,设大了,内存吃紧,服务器直接OOM。行业共识认为,单机8GB内存的云服务器,PHP-FPM的max_children设置在100-200之间比较合理,具体看每个进程平均占用内存,用 ps -ylC php-fpm | awk '{print $8}' 算一下平均值。
Java应用同理,Tomcat的 maxThreads、acceptCount、maxConnections 三者要一起调,常见误区是只调大 maxThreads,但 acceptCount 太小,连接在accept队列就溢出了。
连接数上去了,数据库成了新瓶颈
应用层调完,连接数终于上去了,结果发现请求大量超时,这就要看数据库连接池了,以MySQL为例,max_connections 默认151,Pool大小和MySQL的 max_connections 不匹配,连接就堵在数据库层。
数据库端的排查和优化:
show variables like 'max_connections';查看当前上限show status like 'Threads_connected';查看当前连接数- 连接数接近上限时,优先看是否有慢查询拖住了连接
很多团队把数据库连接池设得很大,结果MySQL直接拒绝连接。连接数不是越大越好,数据库连接池设置成最大并发请求数加少量余量即可,比如应用最大并发500,数据库连接池设600就够了,设成2000反而会拖垮数据库。
服务器连接数限制与监控,建立长效手段
服务器连接数限制在哪看,这个问题没有统一的答案,因为限制分散在多层,系统层、网络层、应用层各有一道门槛,建议做一次完整的基线检查,记录以下数值:
- 系统FD限制:
ulimit -n和cat /proc/sys/fs/file-max - TCP参数:
tcp_max_syn_backlog、tcp_fin_timeout、tcp_tw_reuse - Web服务配置:Nginx的
worker_connections、Apache的MaxRequestWorkers - 数据库连接池:MySQL的
max_connections、Redis的maxclients
监控告警怎么设才不误报
连接数的监控不能只看绝对数值,要结合连接建立速率和处于活动状态的连接数来判断,很多情况下,连接数到达上限只是瞬时现象,持续几秒就回落了,建议配置三个级别的告警:
- 连接数达到上限的80%,触发预警,观察趋势
- 连接数达到上限持续5分钟,触发紧急告警
- 出现大量TIME_WAIT和非活动连接,触发资源泄漏排查
预防性优化的两个习惯
连接数问题的根源,很多时候不是配置不够,而是代码层面有连接泄漏,每次请求都新建连接、用完不关闭、连接池未释放,这些问题积累到一定量就会导致连接数持续走高。
排查连接泄漏的常用命令:
ss -ant | grep ESTABLISHED | wc -l注意数量是否持续增长- 查看进程FD数量增长趋势:
ls /proc/PID/fd | wc -l - 线上环境可以阶段性地抓取
jstack或strace分析
另一个习惯是给连接数监控设置每日基线,连续观察一周,就能掌握业务的真实并发波动,服务器连接数设置多少合适,不是拍脑袋定的,而是根据监控数据反推的。
常见问题解答
调整了ulimit和内核参数,连接数还是上不去,还有什么可能?
查一下Nginx的 worker_connections 和 worker_rlimit_nofile,Nginx作为反向代理时,每个请求会产生到后端的upstream连接,Nginx的worker进程数乘以worker_connections才是总连接数上限,另外检查是否开启了 keepalive(长连接),Nginx默认对客户端的连接是短连接,关闭后每个请求都要新建TCP连接,连接数自然高,配置 keepalive_timeout 65; 和 upstream里的 keepalive 32; 可以显著减少新建连接数。
连接数低和带宽有关系吗?
有一定关系,但不要混淆,带宽是传输速率,连接数是并发数量。大量连接同时建立,TCP三次握手本身要占用一些带宽,但这部分开销极小,更常见的情况是带宽跑满后,TCP握手包和ACK包延迟增大,客户端反复重试,表现为连接数上不去但带宽却打满了,可以查看云监控里的出入带宽使用率来确认。
云服务器和物理服务器在连接数处理上有区别吗?
有区别,云服务器通常有安全组和虚拟交换机层的连接数限流,有些云厂商默认单台云服务器对外TCP连接数上限是几万到十几万,超过后直接丢包,物理服务器没有这层限制,但受网卡中断和内存影响更大,购买云服务器时,可以咨询云厂商关于并发连接数的规格说明,不同套餐的差值很大。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/803501.html