徐州做装备故障预测,多数情况下租GPU服务器比自建划算,但并非所有场景都必须租数据量小、模型轻的时候,CPU或按需短租完全够用,关键看你处在“验证阶段”还是“规模化训练阶段”。
装备故障预测到底吃不吃GPU
故障预测模型在算什么
装备故障预测不是简单跑个阈值判断,徐州工程机械、矿山设备这类场景,常见做法是采集振动、温度、电流、油液等多路信号,做时域和频域特征提取,再喂给LSTM、CNN、Transformer或孤立森林一类模型,业内专家指出,振动信号采样率高、通道多,一条产线的历史数据动辄几十GB到上百GB,特征工程和模型训练阶段对并行计算的需求会明显上升。
具体到计算环节,吃算力的主要是三块:
- 特征提取与数据清洗:多传感器对齐、重采样、滑窗切分,CPU也能做,但大数据量下耗时长。
- 深度学习模型训练:LSTM、时序Transformer的反向传播,GPU能把训练时间从数天压到数小时。
- 超参数搜索与多模型对比:一次跑十几组配置,CPU排队会让人等到没脾气。
如果只是做规则阈值、传统机器学习(随机森林、SVM)的小模型,样本在几万条以内,普通服务器CPU完全撑得住,不必上GPU。
徐州本地算力供给的实际情况
徐州是工程机械产业集群地,徐工等主机厂和大量配套企业在故障预测、预测性维护上有真实需求,但本地能直接调用的高规格GPU资源并不算充裕,企业自建机房采购A100、H100这类卡,成本高、周期长,还要配运维,行业共识认为,对多数中小型装备企业和项目团队来说,把算力需求外包给GPU云服务,比一次性买卡更灵活。
这也是为什么“徐州装备故障预测需要租GPU服务器吗”这个问题,答案偏向“看阶段、看规模”,而不是一刀切。
装备故障预测GPU服务器租用还是自建怎么选
三条路径的真实成本对比
团队常纠结的是自建机房、租物理GPU服务器、还是用公有云按需实例,把差异摊开看更清楚:
| 对比维度 | 自建GPU服务器 | 租物理GPU服务器 | 公有云按需GPU |
|---|---|---|---|
| 前期投入 | 高,买卡加机房改造 | 低,按月/按年付 | 极低,按小时计费 |
| 适合阶段 | 长期稳定大规模训练 | 中长期项目、数据敏感 | 验证期、短期冲训练 |
| 运维负担 | 自己扛 | 供应商负责硬件 | 平台负责,自己管环境 |
| 弹性 | 差,扩容慢 | 中等 | 强,随时升降配 |
| 数据合规 | 完全可控 | 可控 | 需评估数据出域要求 |
装备故障预测GPU服务器租用还是自建,判断标准可以简化成一句话:训练任务是否连续三个月以上、是否每天都有稳定的大批量训练需求,是,考虑租物理机或自建;否,优先按需租云GPU。
什么规模的团队适合哪种
- 高校课题组、初创算法团队:样本量有限,项目周期几个月,按需租云GPU最稳,用完就停。
- 装备制造企业预测性维护项目组:数据不出厂区有硬要求,租本地托管物理GPU服务器更合适。
- 已有IDC机房、长期做多型号设备诊断:自建一批中端卡,配合调度平台,单位算力成本会摊薄。
徐州装备故障预测GPU服务器租用价格大概什么水平
计费方式和价格区间
徐州装备故障预测GPU服务器租用价格没有统一标价,受卡型、显存、带宽、租期影响,近年来公有云按需实例常见计费方式有三种:
- 按小时计费:适合调试和短训练,单卡每小时从几元到几十元不等,卡越新越贵。
- 包日/包周:适合连续跑实验,单价比按小时低一档。
- 包月/包年:适合稳定训练,折算下来单价最低,但要求任务持续。
物理GPU服务器托管在徐州本地或周边IDC,按月租用,价格通常落在数千元到万元级别,具体看卡型和机房等级,注意别只盯显卡单价,还要算存储和带宽。
容易被忽略的隐性成本
- 数据上传与存储:几十GB振动数据传到云端,走公网慢,用专线或硬盘寄送更实际。
- 环境调试时间:租来的机器要装驱动、配CUDA、拉数据,头一天往往跑不满,按小时计费时这部分也在烧钱。
- 闲置浪费:训练脚本跑完不关机,GPU空转照样计费,务必设自动关机策略。
从租卡到跑通故障预测模型的操作路径
环境准备的可验证步骤
租到机器后,先确认卡和驱动状态:
nvidia-smi
看到显卡型号和显存占用正常,再建隔离环境:
conda create -n fault python=3.10 -y
conda activate fault
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121
数据放到独立数据盘,别放系统盘,训练脚本用 nohup 后台跑,日志重定向到文件,方便断线后查看:
nohup python train_lstm.py --data /data/vibration --epochs 80 > train.log 2>&1 &
训练阶段的几个实操提醒
- 先小样本验证管线:拿几千条样本跑通数据加载、前向传播、保存模型,再上全量数据,避免租了卡才发现数据格式不对。
- 监控显存:
watch -n 2 nvidia-smi盯着显存增长,OOM 之前调小 batch size。 - 设自动关机:云平台上配置训练完成后关机,别让机器空转过夜。
- 模型导出留后路:训练完把权重和推理脚本一起打包,推理阶段很多场景用CPU或边缘盒子就能跑,不必长期占GPU。
这些情况其实可以不租GPU
不是所有故障预测项目都要GPU,下面几种场景,先别急着掏钱:
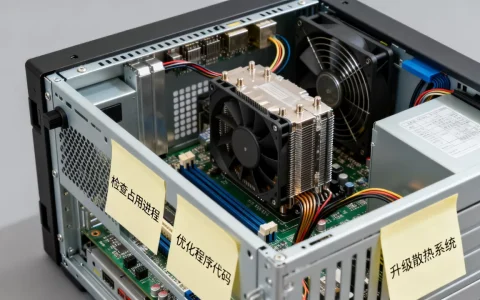
- 样本量在万级以内、用传统机器学习:随机森林、XGBoost 在CPU上跑得很快。
- 只做推理不做训练:模型已经训好,部署到产线边缘设备,CPU或低功耗加速卡够用。
- 规则和阈值为主的预警:振动超限报警、温度趋势判断,不需要深度学习。
- 短期验证想法:先用免费或低价的CPU实例跑通流程,确认方向再租GPU。
换句话说,GPU是加速器,不是入场券,先想清楚训练频率和数据规模,再决定租不租。
关于徐州装备故障预测租GPU服务器的常见问题
徐州装备故障预测租GPU服务器,选什么显卡比较合适
看模型和数据规模,时序模型训练常见用显存16GB到24GB的中端卡起步,样本特别大、模型特别深再上更高显存。徐州工程机械故障预测模型训练显卡选择上,不必盲目追最贵的卡,先拿按需实例试跑,看显存和算力瓶颈在哪,再决定长期租哪种。
租GPU和自建,哪个更适合装备制造企业
数据敏感、训练任务长期稳定、有现成机房运维能力的,自建或租物理机更合适;项目制、算法团队小、训练任务断续的,按需租云GPU更灵活。装备故障预测GPU云服务器配置上,优先选支持按时关机、带独立数据盘的实例,避免存储和计算绑死。
在徐州本地租GPU服务器,数据一定要传出去吗
不一定,可以选择本地IDC托管的物理GPU服务器,数据留在本地机房;也可以把脱敏后的特征数据传到云端训练,是否出域,取决于企业数据合规要求和项目保密级别,训练前先和负责数据的同事对齐这条线。
租不租GPU,本质是算一笔“训练频率×数据规模×数据合规”的账,徐州做装备故障预测,验证阶段按需短租、规模化阶段再考虑长期租用或自建,是更稳妥的路径。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/803684.html