系统日志里能帮我们识别攻击特征的核心字段是时间戳、源/目标IP、用户代理(User-Agent)和状态码,这四类信息组合起来,足以还原绝大多数攻击行为的前因后果。
日志是服务器留给运维人员的“黑匣子”,但很多人面对海量记录时不知从何看起,原因在于,没有带着攻击者的视角去审视这些字段,本文从实战角度拆解各个字段的侦查价值,帮助你从一条普通的登录失败记录中,看出是暴力破解还是撞库攻击。
时间戳与访问频率:识别自动化攻击的第一道筛子
攻击行为区别于正常访问的最大特征,是规律性与高频次,人工操作不可能在1秒内连续发起5次登录请求,但脚本可以。
秒级间隔与整点扫描模式
打开日志,先看日期字段的粒度,多数Web服务器默认记录到秒,但攻击特征往往隐藏在毫秒级的连续请求中,例如攻击者使用Hydra或Burp Suite跑字典,每条POST请求的间隔几乎恒定在100-300毫秒,当你发现同一IP在同一秒内产生多条不同用户名的登录记录,基本可以判断是撞库或密码喷洒。
攻击者还偏好整点扫描,尤其是凌晨2点至5点,此时运维人员警惕性最低,业务流量也处于低谷,日志中若出现固定每隔5分钟、10分钟尝试一次的请求,且目标路径集中在后台登录页或API接口,说明攻击者采用了定时任务驱动的慢速扫描策略。
跨时间段的多阶段特征
单日日志只能看到表象,拉长到72小时维度才能看出完整攻击链,典型流程是:第一天扫描端口和目录,第二天针对发现的中间件版本寻找漏洞利用脚本,第三天开始上传Webshell或植入后门,这类时间轴上的先后关系,单看某一条日志无法发现,但筛选时间字段并按小时聚合统计,攻击行为的前后节奏就会清晰浮现。
源IP与端口字段:追溯攻击者身份的指纹
IP地址是日志里最具直接指向性的字段,但单纯拦截IP意义有限,因为攻击者常使用代理池或Tor出口节点,真正的价值在于关联分析。
源端口号暴露的信息
默认情况下,客户端发起连接时的源端口是随机的,但如果日志中大量请求的源端口集中在特定区间,比如连续的30000-30050,说明攻击者使用了不成熟的扫描工具,或者本机防火墙策略过于宽松,没有做端口随机化,小鹏安全团队的日志分析指南中提到,这类“端口连续”现象在蠕虫病毒传播中极为常见,例如永恒之蓝变种。
地域与ASN的交叉验证
日志中记录的国家代码或城市信息,适合作为辅助判断,比如一个国内业务网站,突然出现大量乌克兰或巴西的IP尝试登录管理员账号,即便这些IP不在公开威胁情报库中,也值得警惕,更专业的做法是结合ASN号判断IP所属的IDC机房,如果发现请求来源多为知名廉价VPS商(如Contabo、Vultr),且历史解析记录中有恶意域名,则攻击概率大幅提升。
用户代理与请求方法:识别漏洞利用的利器
User-Agent(UA)字段是伪装和反伪装的博弈点,普通浏览器UA包含操作系统、浏览器版本、渲染引擎信息,格式相对固定,攻击者要么使用默认的curl或Python-requests UA,要么伪造得过分完美。
异常UA特征与绕过手法
常见的攻击UA特征包括:
- 包含sqlmap、Nmap、Masscan等扫描器标识
- UA字符串为空或长度异常(超过200字符)
- 缺少正常的Mozilla/5.0前缀,直接以HTTP库名称开头
- 版本号明显过旧或字段顺序不符合主流浏览器规律
不少攻击者会用“UA随机化”能力来规避检测,但这恰恰留下新特征:同一IP在短时间内请求同一路径,每条日志的UA都不同,人为痕迹重,攻击者对请求方法的选择也有规律,正常用户主要用GET和POST,而攻击者会频繁使用OPTIONS探测服务器支持的HTTP方法,或使用PUT、PATCH尝试上传恶意文件。
结合开发者工具的痕迹
从搜索引擎优化的角度看,蜘蛛的UA属于白名单,但有些攻击者会伪造蜘蛛UA来抓取敏感目录,一个有效的排查思路是:在数据分析工具中,对比访问量排名前100的UA列表,凡是UA头部标记为Baiduspider或Googlebot但来源IP不在官方公开IP段的请求,一律视为异常。
请求路径与状态码:拼接攻击行为的完整链条
状态码是服务器对请求的回应,200代表成功,404代表不存在,500代表服务器内部错误,攻击者特别关注500和403状态码,因为这意味着目标可能存在可被利用的参数注入点。
404扫描与403绕过的识别
大量404状态码集中出现在同一IP,且请求路径包含“.env”“config.php.bak”“web.config”等敏感文件名,说明攻击者在做目录爆破,此时观察路径的命名规律如果包含随机生成的16位十六进制字符,基本是自动化工具生成。
403状态码则需要结合请求方法看,攻击者经常利用HTTP/1.1与HTTP/2的差异绕过WAF规则,或者通过添加X-Forwarded-For、X-Original-URL头来篡改后端处理逻辑,日志中如果你看到同一IP先触发403,随后紧跟一条200状态的相同请求路径,几乎可以断定攻击者在测试访问控制的有效性。
响应时长与字节数大小的信号价值
状态码配合响应字节数,有时比IP更能说明问题,SQL注入攻击的响应体通常比正常请求大,因为数据库报错信息被回显,一个登录接口正常返回到前端约2KB,但某条请求返回了50KB且状态码还是200,大概率是攻击者触发了详细的数据库错误报告,这类日志用AWK处理时,直接按$10 > 20000过滤即可快速定位。
怎么从系统日志判断服务器是否被入侵:实用排查路径
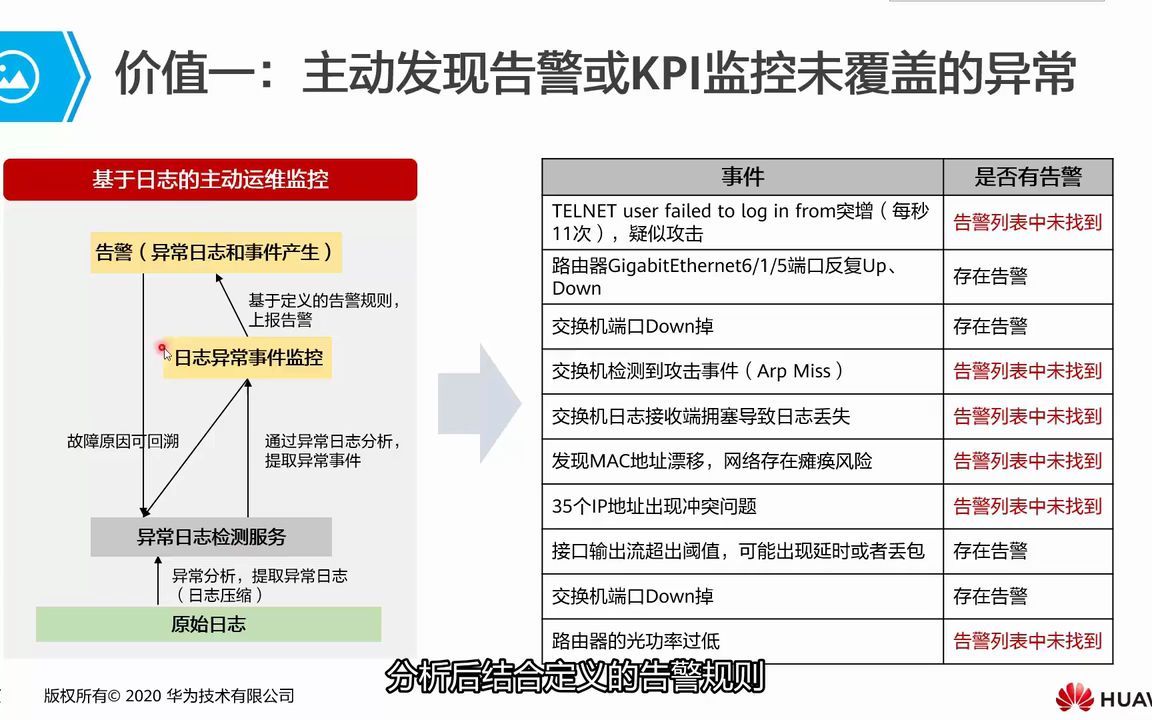
这个问题没有单一字段能回答,但可以遵从一套验证步骤,首先查询认证日志(如/var/log/secure或/var/log/auth.log),按时间倒序检查所有root登录记录,重点看是否有非正常时段的公网IP登录成功,如果发现可疑登录,则继续在/var/log/wtmp和/var/log/btmp中查看历史登录与失败记录。
核查Web日志中出现频率最高的前20个IP,用awk '{print $1}' access.log | sort | uniq -c | sort -nr | head -20列出排行,然后将TOP IP与威胁情报平台比对,如果某个IP访问过webshell路径且成功返回200,那么入侵概率极大,检查cron任务日志和系统启动项,攻击者常在提权后写入计划任务来维持持久化。
系统日志分析工具有哪些及如何选型
日志分析工具的选择直接影响排查效率,低成本方案是用Linux内置命令组合,例如grep、awk、sed做文本过滤,适合单台或少量服务器,中间方案是使用ELK(Elasticsearch、Logstash、Kibana)或Loki,适合日志量在GB级别的集群环境,商业方案如Splunk和奇安信NGSOC,则内置了大量攻击检测规则,上手简单,但成本较高。
不同工具擅长处理的日志类型也有差异,开源工具Fail2ban用于实时拦截暴力破解效果显著,它直接读取认证日志并调用防火墙规则封禁IP,对于Web日志的深度语义分析,GoAccess可以快速生成统计报表,但无法解析复杂的攻击payload,如果希望做到攻击特征自动提取,需要借助像Elastic X-Pack或SigNoz这类具备机器学习能力的平台。
行业共识认为,日志分析工具的选型需结合自身团队的技术储备,如果团队脚本能力强,初期使用文本工具组合已经能覆盖大部分需求,不必在工具上投入过重。
日志字段分析的常见误区
很多运维人员习惯性地把所有责任推给“日志太多”,但问题往往出在没有建立正确的字段关联视角,只关注拦截IP而忽略URI路径的关联,会出现“封了这个IP,攻击者换个代理照样进来”的被动局面,值得处理的顺序是:先按请求路径分组,再关联IP和UA,最后用时间排序还原攻击过程。
不要把日志分析做成一锤子买卖,攻击者的手法在迭代,日志字段的价值也会变化,定期复盘真实攻击案件的日志模式,会比单纯翻阅手册更有效。
总结来看,日志字段不是孤立存在的,时间戳、IP、UA、状态码、路径这五个要素组合成的行为序列,才是攻击特征的真实载体。 每一个字段都在讲述攻击者“做了什么、怎么做的、结果如何”的片段,连起来就是一张完整的攻击地图。
相关问答
系统日志分析工具有哪些适合小型团队使用?
对于日志量不大且预算有限的场景,组合使用grep与awk命令并配合GoAccess监控Nginx访问日志足够处理日常排查,若需集中管理三台以上服务器,开源版本的Loki配合Promtail可以搭建轻量级日志聚合,存储成本比ELK低约一半,多数情况下,小型团队使用文本工具加Intrusion Detection System(例如Snort)就能建立初步的报警能力。
为什么关键的攻击日志总是被忽略?
日志被忽略的原因有两种:一是没有建立基线流量概念,不了解正常模式就无法从海量数据中辨别偏差,攻击特征往往只会引起基线之上的轻微波动;二是没有做动态字段监控,只配置了静态规则报警,攻击者通过缓慢的扫描频率可以轻松绕过阈值,建立全量日志留存和按周为周期的趋势统计,是解决此问题的有效手段。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/803948.html