程序编程
-
数据库分片跨机房同步延迟怎么控制,跨机房同步延迟多少算正常
跨机房同步延迟的瓶颈在物理距离和同步机制本身,控制手段就三条路:缩短物理链路、优化同步策略、调整分片设计,光在光纤里绕一圈,北京到上海就要 15毫秒以上,这个底数摆在那里,任何优化都只能是接近它,不可能突破它,数据库分片跨机房同步延迟怎么解决先搞清楚延迟从哪来分片之后每个节点只存一部分数据,但业务上的关联数据往……
-
怎么查我的世界服务器IP地址是多少,我的世界服务器IP怎么查
查我的世界服务器IP地址,先判断服务器类型:租赁面板服在服务商后台直接复制“IP:端口”,自己电脑开服去浏览器搜“IP”查公网地址,手机版/网易版多数通过面板信息或房间码获取,先判断你的服务器属于哪一种,查询入口完全不同不同的开服方式,服务器IP地址存放的位置不一样,查不到往往不是操作错了,而是找错了地方,租赁……
-
时序数据写入峰值为何考验顺序写入,如何提升存储性能?
写峰值的本质是存储子系统顺序写入能力的一次大考,把随机小IO揉成批量大块顺序写,是扛住瞬时突刺的关键动作;当磁盘队列和落盘延迟出现悬崖式上涨时,先怀疑存储,而不是CPU,时序数据库写入峰值为什么卡在存储层?先看顺序写与随机写的差距工厂车间里,2000台传感器每隔五秒上报一次温度,平时数据流平缓,系统毫无压力,但……
-
实时流处理为何对端到端延迟敏感,边缘计算就近部署怎么做?
实时流处理作业想稳住端到端延迟,最直接的路子就是把计算推到数据产生的地方去,就近处理,别让数据来回折腾,流处理不是批处理,数据一到就得立刻反应,延迟每多一毫秒,结果就可能过期,这个行业里,延迟就是生命线,尤其是做交易风控、实时推荐、物联网监控这些业务的人,感受最深,为什么实时流处理对端到端延迟如此敏感端到端延迟……
-
低延迟消息队列消费为何更适合高主频实例,高主频云服务器怎么选?
低延迟消息队列消费场景的核心痛点不在网络带宽,而在单条消息的处理速度,因此高主频计算实例是更优选择,它能让消费端吞吐量直接拉升,避免消息积压,做过消息队列运维的朋友都有这种体会:Topic 里的消息堆积量明明不大,但消费速度就是上不来,很多人第一反应是加消费者数量,结果消费者越多,分区重平衡越频繁,延迟反而更高……
-
怎么在win7环境下下载服务器
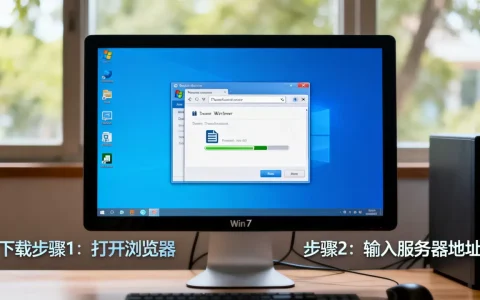
在Win7环境下下载服务器文件最直接的办法是使用FTP客户端或远程桌面连接,如果要搭建服务器则推荐安装HTTP服务组件,本文按需求场景分步说明具体操作,win7怎么下载服务器文件:先分清你要哪种下载很多人在网上搜索“win7怎么下载服务器文件”,其实背后藏着两类完全不同的需求,一类是想从远程服务器把文件拉到本地……
-
容灾数据库多副本一致性比恢复速度更关键吗,数据库容灾怎么选
容灾真正的命门不是恢复有多快,而是恢复起来的数据能不能信,多副本一致性一旦失控,恢复速度再快也只是把错误数据快速铺向所有节点,数据库多副本一致性怎么保证,比恢复速度更关键吗在容灾方案评审现场,很多人第一句问的是“RTO能到多少秒”,这个问题没错,但顺序错了,数据库多副本一致性怎么保证,才是决定容灾是否具备实际意……
-
大规模join查询为何总被数据倾斜拖慢,大数据join优化方案有哪些
大规模join查询的性能瓶颈,通常不是集群总算力不足,而是少数节点被倾斜数据压垮,导致整个作业在最后一个task上长时间卡死,大数据join数据倾斜怎么解决:先把节点间数据分布看清楚数据倾斜不是玄学,是分布式计算里最典型的“木桶效应”,某个join键在数据源中占比一旦明显高于其他键,相同键的记录就会被shuff……
-
高可用数据库架构选共享存储还是本地盘,哪个更适合生产环境?
高可用数据库架构依赖共享存储还是本地盘,不能一概而论:共享存储以更高成本换取强一致和简化切换,本地盘以更低延迟和硬件成本换取灵活,但高可用必须靠软件层补齐,高可用数据库架构选型:共享存储和本地盘哪个好共享存储和本地盘代表了两种完全不同的数据管理哲学,共享存储像个靠谱的老管家,所有数据库节点共用一份数据文件,切换……
-
内存计算型实例适合热点数据全驻留吗,内存计算型实例是什么?
内存计算型实例的核心价值就是把热点数据集全部驻留内存,让读请求绕开磁盘与网络存储,直接在内存里完成命中,如果你的业务存在高频访问、低延迟要求的少量热数据,选它基本不会错,内存计算型实例适合哪些场景?先看懂热点数据驻留内存的逻辑很多人一听到内存计算型实例,第一反应是“贵”,但贵有贵的道理,它把内存当成主存储,而不……