程序编程
-
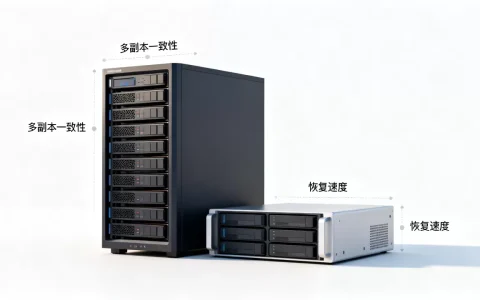
容灾数据库多副本一致性比恢复速度更关键吗,数据库容灾怎么选
容灾真正的命门不是恢复有多快,而是恢复起来的数据能不能信,多副本一致性一旦失控,恢复速度再快也只是把错误数据快速铺向所有节点,数据库多副本一致性怎么保证,比恢复速度更关键吗在容灾方案评审现场,很多人第一句问的是“RTO能到多少秒”,这个问题没错,但顺序错了,数据库多副本一致性怎么保证,才是决定容灾是否具备实际意……
-
大规模join查询为何总被数据倾斜拖慢,大数据join优化方案有哪些
大规模join查询的性能瓶颈,通常不是集群总算力不足,而是少数节点被倾斜数据压垮,导致整个作业在最后一个task上长时间卡死,大数据join数据倾斜怎么解决:先把节点间数据分布看清楚数据倾斜不是玄学,是分布式计算里最典型的“木桶效应”,某个join键在数据源中占比一旦明显高于其他键,相同键的记录就会被shuff……
-
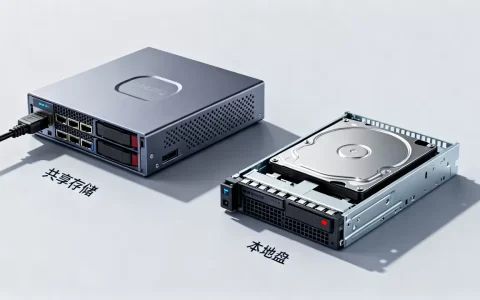
高可用数据库架构选共享存储还是本地盘,哪个更适合生产环境?
高可用数据库架构依赖共享存储还是本地盘,不能一概而论:共享存储以更高成本换取强一致和简化切换,本地盘以更低延迟和硬件成本换取灵活,但高可用必须靠软件层补齐,高可用数据库架构选型:共享存储和本地盘哪个好共享存储和本地盘代表了两种完全不同的数据管理哲学,共享存储像个靠谱的老管家,所有数据库节点共用一份数据文件,切换……
-
内存计算型实例适合热点数据全驻留吗,内存计算型实例是什么?
内存计算型实例的核心价值就是把热点数据集全部驻留内存,让读请求绕开磁盘与网络存储,直接在内存里完成命中,如果你的业务存在高频访问、低延迟要求的少量热数据,选它基本不会错,内存计算型实例适合哪些场景?先看懂热点数据驻留内存的逻辑很多人一听到内存计算型实例,第一反应是“贵”,但贵有贵的道理,它把内存当成主存储,而不……
-
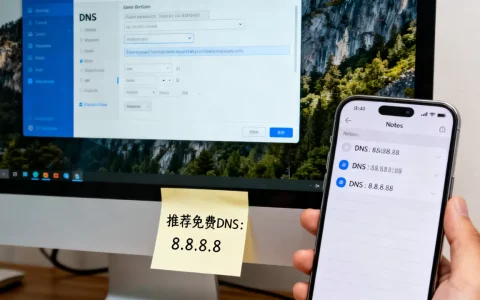
免费网络服务器DNS地址怎么找,哪个免费DNS服务器好用?
免费网络服务器DNS地址并非真正的解决方案,正确做法是使用云厂商提供的免费内网DNS服务,或自行搭建轻量级DNS转发器,很多站长和管理员在服务器配置阶段,习惯性地填入114.114.114或8.8.8这类公共DNS,这种做法在个人电脑上问题不大,但放在生产服务器上,往往会引发解析延迟、被污染甚至服务不可用的问题……
-
日志写入吞吐高但单条很小如何优化,日志数据写入优化方法?
日志小记录高吞吐写入的瓶颈大多不在磁盘本身,而在每条的固定开销被放大,先把单条写改成批量合并写,再上异步队列,多数场景吞吐能提升数倍,日志写入吞吐高但慢怎么解决:先定位小记录场景的三个隐形瓶颈小记录,比如一条只有几十到几百字节的请求日志、埋点日志或网关访问日志,写入吞吐要求每秒几万甚至几十万条,很多人第一反应是……
-
图数据库遍历查询更怕随机读延迟吗?,图数据库如何优化查询性能
图数据库遍历查询天生就是随机读密集型操作,其性能瓶颈几乎全部集中在随机I/O延迟上,对顺序读的依赖极低——理解这一点,就理解了图数据库调优的核心方向,图数据库的每一次遍历,都像在迷宫里边走边问路,系统找到A节点后,必须立刻去磁盘深处把跟它相连的B节点、C节点捞出来;捞完之后,又得基于B节点继续跳转到下一层邻居……
-
数据湖仓一体架构为何要求存储计算弹性解耦,什么是存算分离架构
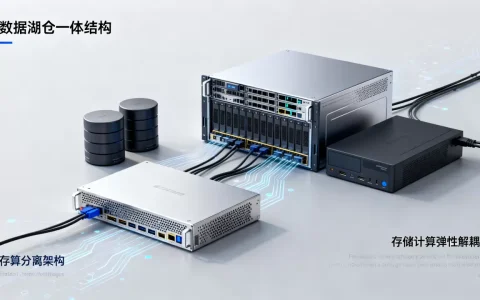
存储与计算必须彻底解耦,弹性才真正落地,只有把存储从计算节点里解放出来,湖仓一体才能在业务洪峰时秒级扩容计算,在闲时缩容省成本,同时让一份数据被多个引擎安全地共享分析,这套架构不是把旧数仓换个名字,而是从底座开始重新定义数据平台的伸缩方式,数据湖仓一体架构为什么必须做存算分离传统大数据平台把存储和计算绑在同一批……
-
列式存储压缩后解压计算开销怎么评估,有哪些方法?
评估解压计算开销要同时看解压吞吐、CPU占用、查询延迟三个指标,压缩比越高通常解压越慢,但列式存储的谓词下推和列裁剪能抵消相当一部分CPU消耗,列式存储压缩为什么会产生解压计算开销列式存储把同一列的数据连续存放在磁盘上,这种布局让相同类型的数据靠在一起,压缩算法更容易找到重复模式,压缩最大的好处是减少磁盘IO和……
-
H3C如何禁止IP访问内网服务器,H3C交换机ACL怎么配置
想在H3C设备上禁止某个IP访问内网服务器,核心做法是创建ACL规则匹配该源IP,再把规则应用到服务器所在VLAN或接口的入方向,最后执行save force保存配置, 这一套动作在H3C交换机、路由器、防火墙上都适用,只是ACL类型和应用位置略有不同,下面按设备类型拆开讲透,先分清场景:你要禁止的是外部IP还……