云计算
-
流量模型偏突发时容量冗余留多少,网络容量规划怎么做?
流量模型偏突发时,容量冗余留40%-50%是性价比最高的安全区,预算紧张的场景也不应低于30%,这里的冗余不是拍脑袋定的,而是基于你业务的峰值形态、持续时长、恢复速度三个变量算出来的,为什么偏突发模型不能照搬“3倍冗余”的旧经验很多运维朋友习惯用“平时均值的2-3倍”来规划容量,这在平稳流量下问题不大,但流量模……
-
需要细粒度限流时负载均衡与网关如何分工
负载均衡负责集群维度的粗粒度流量兜底,网关负责接口、用户、参数级别的细粒度精准控制,两者配合而非替代,负载均衡对连接和转发层面的信息最敏感,网关对业务语义最了解,细粒度限流只适合在网关层做,硬塞给负载均衡会拖垮转发性能,也拿不到业务需要的特征维度,网关限流和负载均衡限流区别在哪这是架构设计中最高频的纠结点,很多……
-
新版本上线如何通过灰度发布验证稳定性?,灰度发布流程是什么?
灰度发布是保障新版本稳定上线的有效手段,其核心逻辑是让少量真实用户先行验证,再逐步扩大流量范围,最终实现全量发布,这种方式将风险控制在最小范围内,是当前互联网行业应对版本迭代的标准做法,灰度发布怎么逐步验证服务稳定性,具体步骤是什么在实际操作中,灰度发布并非简单地将新旧版本同时运行,而是要经过一套严谨的流程,制……
-
选七层负载均衡前要确认证书管理成本吗,有哪些坑
在选七层负载均衡之前,如果没提前把证书管理成本算清楚,上线后大概率会被证书过期、配置混乱和续期加班反复折腾,很多团队选型时盯着转发性能、会话保持和健康检查,等真正把域名切到七层负载均衡上,才发现证书这件事远比想象中麻烦,本文把证书管理成本的构成、常见坑点和选型考察项一次说透,为什么证书管理成本被严重低估七层负载……
-
用户登录态依赖会话保持该如何配置负载均衡
负载均衡做得好,用户登录态却频繁掉线?核心解法在会话保持结论先行:用户登录态依赖会话保持,解决思路是在负载均衡层开启粘性会话,让同一用户的请求始终落到同一台后端服务器;如果业务改造允许,更推荐用集中式Session存储(Redis)或JWT无状态登录,彻底摆脱对会话保持的依赖,很多团队遇到过这种情况:部署了多台……
-
业务跨地域扩展时用全局调度就近接入用户
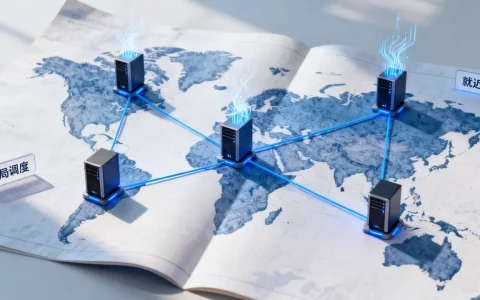
业务跨地域扩展时,用全局调度将用户请求精准路由至最近节点,是降低访问延迟、提升可用性的核心手段,其本质是让网络“主动适应”用户位置,而非让用户被动迁就网络,全球业务扩张带来的第一个技术痛点,往往不是服务器性能,而是“距离产生延迟”,当用户从纽约访问部署在新加坡的源站,每一次请求都要跨越大半个地球,物理距离带来的……
-
证书到期前如何把更新托管给负载均衡,省心吗?
证书即将到期前把更新托管给负载均衡,是保证业务不中断最省心的办法, 这个做法不是官方强制要求,而是让你从每次熬夜赶工换证书的循环里解脱出来的实操选择,把证书丢给负载均衡去管,到期前它会帮你统一处理,你不用再一台台服务器登录上去替换文件,也不用担心漏掉哪台机器导致访问报错,SSL证书到期前多久更新才算安全行业共识……
-
短连接风暴如何用四层转发扛住?,高并发请求怎么解决?
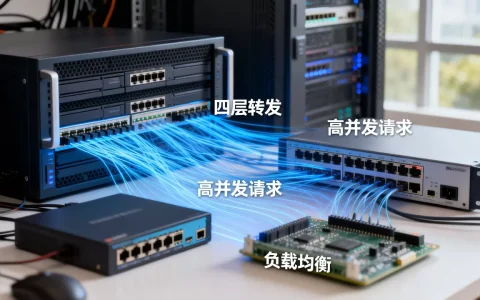
短连接风暴场景下,四层转发能扛住高并发的核心原因是它把数据包在内核态直接转发,不解析HTTP协议,CPU开销比七层代理低一个量级,握手风暴再猛也挤不爆应用层线程池,短连接风暴是什么感觉?就好比早高峰的地铁闸机,每秒钟涌进来几千个乘客,个个刷票进门就走,不带停顿,正常的闸机也许能处理,但如果每个乘客进门时都要安检……
-
后端某节点异常时健康检查自动摘掉是什么原因,怎么办?
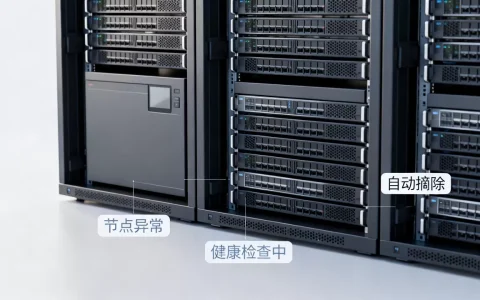
后端某节点异常时,健康检查自动把它摘掉是保障服务整体可用性的核心机制,核心逻辑就是通过定期探测节点状态,一旦发现异常立即将其从负载均衡池中移除,这套机制如果配置得当,能在大流量冲击或代码故障时保住整个集群的命,下面从原理、方案选型到实战配置,把这件事讲透,健康检查自动摘除节点的基本原理后端节点从“正常服务”到……
-
多团队共享集群如何靠转发规则隔离流量?,什么是流量隔离?
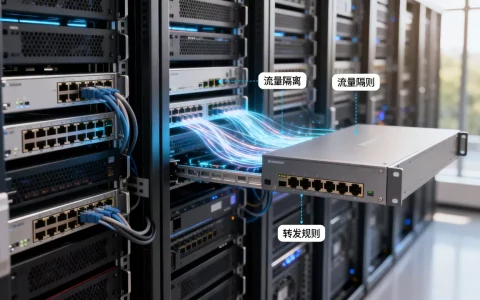
核心答案多团队共享集群时,靠转发规则(NetworkPolicy、路由表、安全组等)隔离彼此流量,是目前性价比最高、维护成本最低的隔离方案,不需要拆集群,也不需要重建网络,转发规则的本质是”在数据通路上设卡”,让不该通的流量在源头就被拦下,而不是把每个团队都关进单独的集群里,共享集群省资源,转发规则保安全,这两……