U8服务器老死机,核心原因通常集中在硬件资源耗尽、数据库死锁、操作系统配置不当或U8服务自身内存泄漏这四类,按“先看资源、再查数据库、后调服务”的顺序排查,多数情况下能在半小时内定位到根因。
U8服务器就像后厨里那口天天颠勺的大铁锅,平时不声不响,一旦火太猛、菜太多、下水道堵了,它就直接罢工,很多运维人员遇到U8服务器老死机,第一反应是重启,但重启只是把锅刷干净,灶台的火和堵住的管道没解决,过两天照样死,下面从诱因、排查、优化、硬件、数据恢复几个层面拆开讲。
u8服务器老死机是怎么回事?先搞懂这四个常见诱因
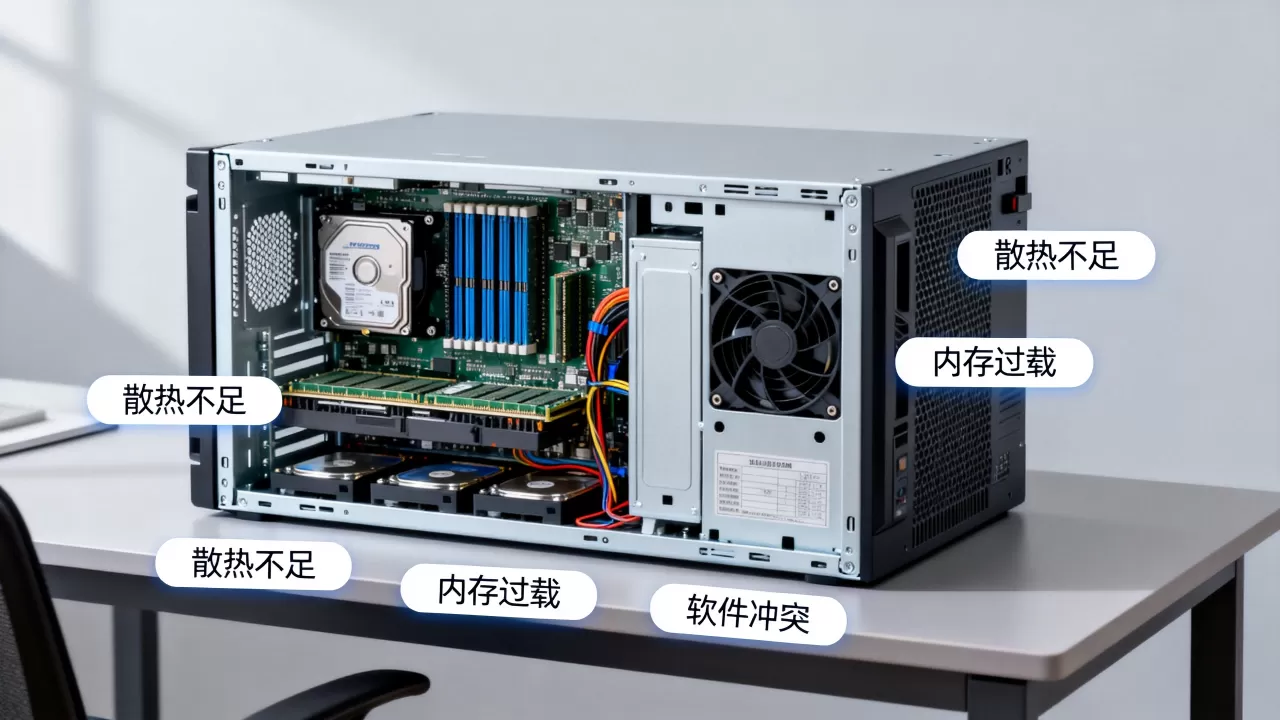
硬件资源不够:CPU、内存、磁盘IO谁先扛不住
U8是典型的IO密集和内存消耗型应用,SQL Server数据库、U8应用服务、IIS、中间件全挤在一台机器上,资源打架是常态。
- 内存不足:SQL Server默认会尽可能占用内存,如果没设上限,操作系统和其他服务只能抢残羹剩饭,表现是系统响应极慢,然后彻底无响应。
- 磁盘IO瓶颈:U8的临时表、日志文件、备份文件频繁读写,机械硬盘做RAID5,随机写入性能差,并发一上来磁盘队列长度飙升,服务器直接卡死。
- CPU过热或降频:散热不良导致CPU自动降频,处理能力骤降,这种情况在老旧塔式服务器上尤其常见。
- 电源功率不足:加了两块硬盘或换了高功耗CPU后,原装电源带不动,高负载时自动断电重启。
数据库死锁与阻塞:U8的“堵车”现场
U8的很多操作会长时间持有锁,比如成本计算、期末结账、批量审核,如果两个会话互相等对方释放锁,SQL Server会选一个当牺牲品,报错1205,但更多时候是阻塞一个慢查询卡住后面一串,客户端界面转圈,服务器CPU和内存被拖垮。
行业共识认为,U8服务器死机中相当一部分与数据库阻塞有关,而不是硬件彻底坏了,用sp_who2和DBCC OPENTRAN能快速看到阻塞源头。
操作系统与网络环境:被忽略的隐形杀手
- Windows更新或杀毒软件扫描:半夜自动更新、全盘杀毒,瞬间吃满IO和CPU。
- 网卡驱动不兼容:特别是Intel网卡在Server 2012/2016上的某些驱动版本,会导致网络中断,U8客户端全部掉线,服务器看似死机。
- 端口耗尽:大量客户端短连接,TIME_WAIT状态端口堆积,新连接进不来。
U8服务自身问题:内存泄漏与补丁缺失
U8的某些版本存在已知内存泄漏,比如生产订单整批下达、库存盘点单过账等模块,长时间不重启U8应用服务,内存占用从几百MB涨到几个GB,最终触发系统内存耗尽,没打最新补丁的U8,可能撞上SQL Server某个版本兼容性bug。
u8服务器频繁死机怎么排查?一套可落地的诊断流程
第一步:看Windows事件查看器和性能监视器
死机后重启,先打开“事件查看器 → Windows日志 → 系统”,按时间排序,找死机前5分钟的Error和Critical,重点看:
- 来源为Disk:磁盘有坏道或IO错误。
- 来源为Application Error:U8相关进程崩溃。
- 来源为Kernel-Power:非正常断电,检查电源和散热。
同时打开“性能监视器”,添加计数器:Processor(_Total)% Processor Time、MemoryAvailable MBytes、PhysicalDisk(_Total)Avg. Disk Queue Length,磁盘队列长度持续大于2,就是IO瓶颈。
第二步:用SQL命令抓数据库阻塞
在SSMS里执行:
-- 查看当前阻塞
SELECT blocking_session_id, wait_type, wait_time, wait_resource
FROM sys.dm_exec_requests
WHERE blocking_session_id <> 0;
-- 查看活动事务
DBCC OPENTRAN;
如果发现某个session_id长期阻塞,用KILL命令结束它(确认不是关键事务后),然后检查该语句是否缺索引,或者U8的临时表没清理。
第三步:检查U8日志和中间件
U8安装目录下U8SOFTLog有按日期生成的日志,搜关键词“OutOfMemory”“Timeout”“Deadlock”,同时看IIS的应用程序池是否频繁回收,回收原因如果是“内存限制”,说明U8站点内存超标。
第四步:复现与压力测试
如果死机没有规律,用perfmon开数据收集器集,记录到文件,下次死机后分析,或者用sysinternals的Process Explorer看U8进程的句柄数和线程数是否持续增长。
u8服务器内存不足导致死机?配置优化实操
SQL Server最大内存设置
这是最容易被忽略的一步,SSMS里右键服务器 → 属性 → 内存,把“最大服务器内存”设为物理内存的70%左右,比如32GB内存,设22528MB,留出余量给操作系统和U8应用服务。
虚拟内存与页面文件
页面文件放在SSD上,初始大小和最大值设为物理内存的1.5倍,不要交给系统管理,否则可能碎片化,路径:系统属性 → 高级 → 性能设置 → 高级 → 虚拟内存。
应用程序池与U8服务回收
IIS中U8的应用程序池,设置“回收 → 固定时间间隔”为凌晨3点,避免业务高峰,U8应用服务本身可以配置每天凌晨重启一次,通过任务计划执行net stop U8TaskService && net start U8TaskService。
u8服务器硬件配置要求与更换价格:升级还是换新
不同规模企业要求不同,下面表格供参考(价格因地域和服务商浮动,一线城市通常比二三线城市高20%-30%)。
| 场景 | CPU | 内存 | 存储 | 参考价格区间 |
|---|---|---|---|---|
| 5-10人并发 | 4核 | 16GB | 256GB SSD + 1TB HDD | 5000-8000元 |
| 10-30人并发 | 8核 | 32GB | 512GB SSD + 2TB HDD | 10000-18000元 |
| 30-50人并发 | 16核 | 64GB | 1TB SSD RAID1 + 4TB HDD | 20000-35000元 |
如果现有服务器是机械硬盘、内存低于16GB,建议直接换新平台,升级单件的性价比不高,二三线城市找本地服务商,可能报价低但备件慢;一线城市服务商响应快,价格也更高。
u8服务器死机重启后数据丢失怎么办?预防与恢复
备份策略
SQL Server数据库恢复模式设为“完整”,每天凌晨做完整备份,每小时做事务日志备份,备份文件放另一台机器或NAS,U8的附件目录也要定期同步。
数据库恢复模式
如果误设为“简单”,事务日志不保留,死机后只能恢复到上次完整备份,改回“完整”后需要做一次完整备份来启动日志链。
日志文件管理
U8的LDF日志文件可能涨到几十GB,收缩日志用:
USE UFDATA_001_2026;
DBCC SHRINKFILE (UFDATA_001_2026_Log, 1024);
但不要频繁收缩,最好设自动增长上限,定期备份日志来截断。
Q&A:u8服务器老死机常见问题解答
问:u8服务器每天定时死机,是什么原因?
答:优先查任务计划,很多客户设置了凌晨自动备份、杀毒扫描、Windows更新,这几个任务撞在一起,磁盘IO和CPU瞬间打满,把备份改到业务空闲且错开的时间,杀毒排除U8和SQL Server目录,另外检查SQL Server的维护计划是否在重建索引,大表重建索引会锁表并吃满IO。
问:u8服务器死机后重启,客户端连不上怎么办?
答:先确认SQL Server服务是否启动,然后检查U8应用服务(U8TaskService、U8DispatchService)是否运行,如果服务启动但客户端报错,看IIS的U8站点是否启动,应用程序池是否被禁用,最后检查防火墙端口:U8默认用80或8080,SQL Server用1433,用netstat -ano | findstr :1433确认监听。
问:云服务器上跑U8,还会老死机吗?
答:会,但原因不同,云服务器常见的是突发性能实例CPU积分耗尽,或者云磁盘IOPS达到上限,另外云主机默认没有页面文件或页面文件在系统盘,内存不足时直接崩,建议选通用型或计算型实例,挂载SSD云盘,并手动设置页面文件到数据盘,云服务器死机后,控制台查看监控图的CPU和磁盘指标,比本地服务器更容易定位。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/746643.html