AI大模型用卡怎么选择?2026年热门AI绘画软件推荐

2026年AI大模型用卡的核心在于平衡算力密度与显存带宽,推荐优先选择配备HBM3e内存的高性能GPU集群,并采用混合精度训练策略以优化成本效益。

随着人工智能从概念验证走向规模化落地,算力基础设施已成为制约模型迭代速度的关键瓶颈,对于开发者和企业而言,如何选择合适的硬件配置,不仅关乎训练效率,更直接影响最终的商业回报,业内专家指出,单纯的硬件堆砌已无法解决所有问题,系统级的协同优化才是提升性能的正解。
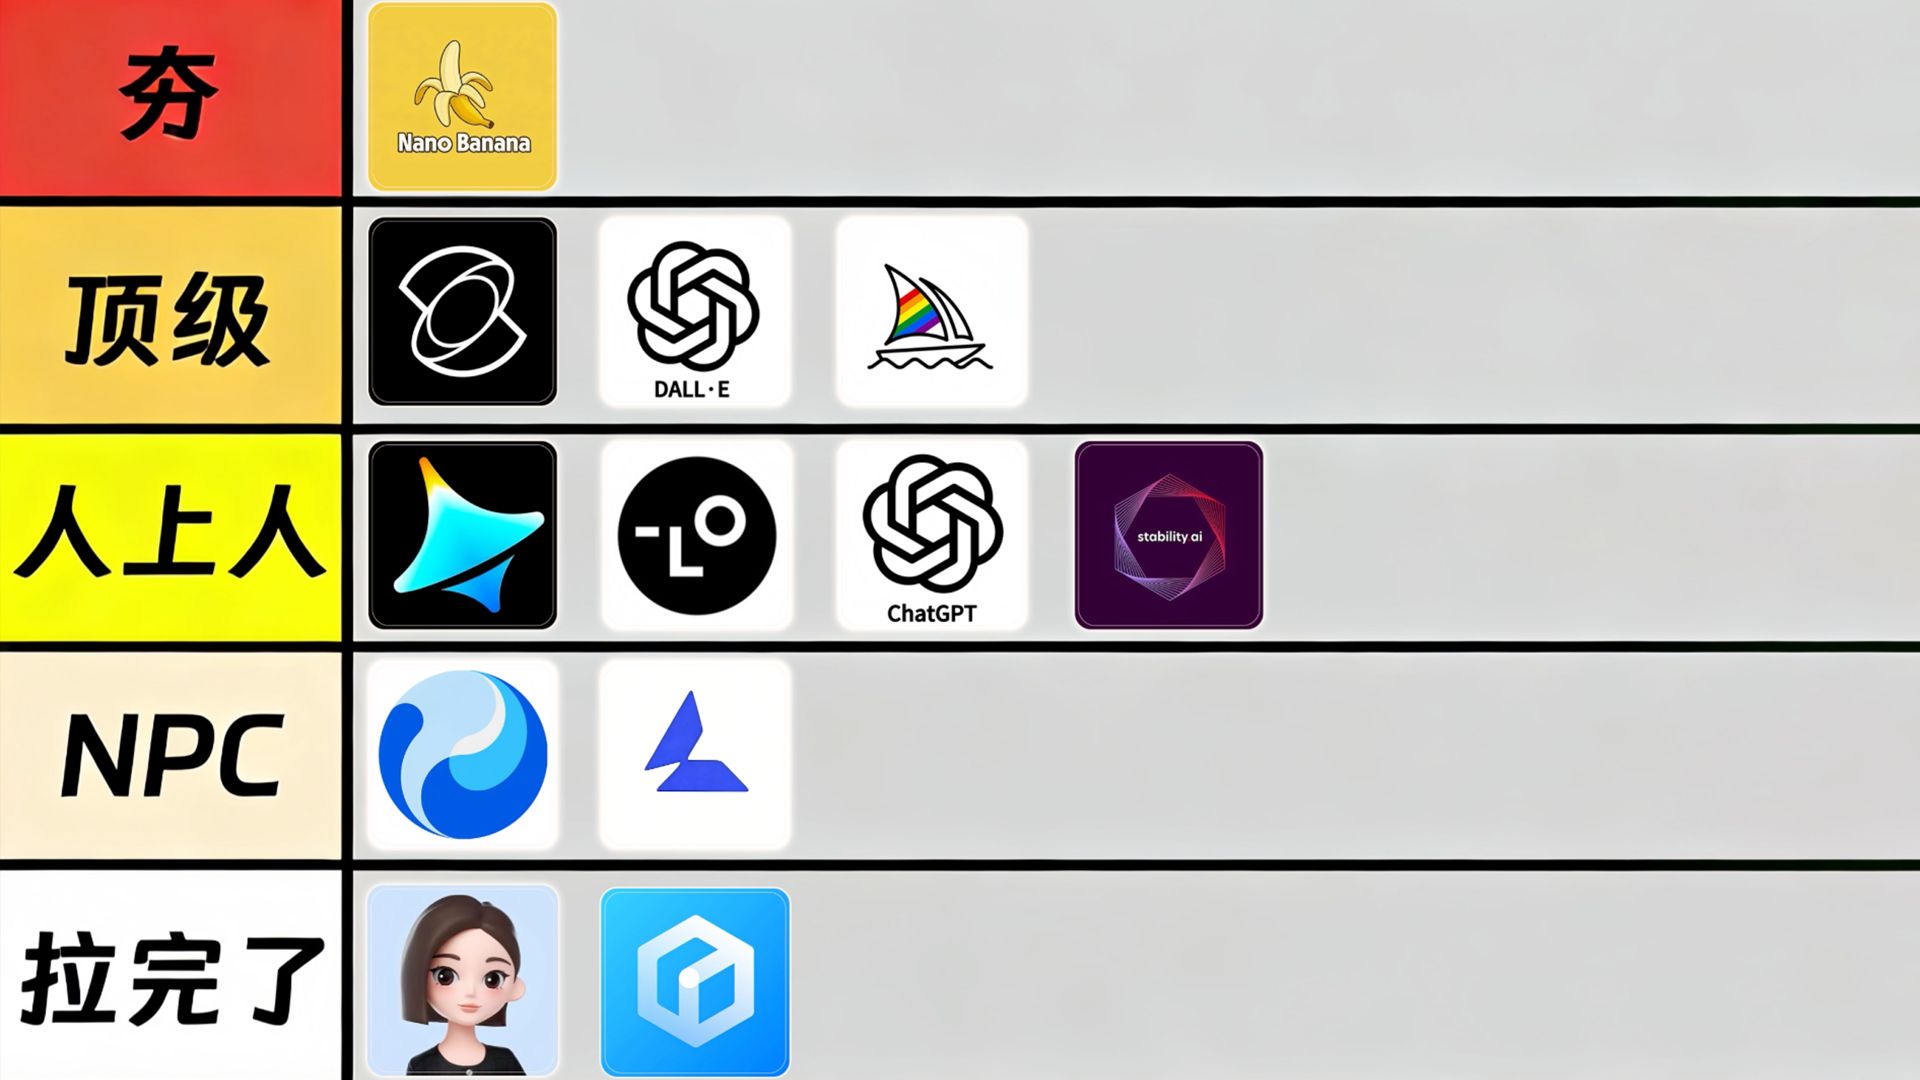
锐评2026年AI生图软件,从夯到拉依次排名!
加载中
锐评2026年AI生图软件,从夯到拉依次排名!

主流AI算力硬件选型指南

在2026年的市场环境中,GPU依然是绝对的主力,但NPU和ASIC专用芯片的份额正在快速上升,选择硬件时,不能仅看单卡性能,必须结合具体场景进行综合评估。

高性能训练场景下的GPU选择

对于大语言模型(LLM)的预训练和微调,显存容量和带宽是决定性因素,HBM(高带宽内存)技术已成为标配,其数据传输速度远超传统GDDR内存。

  • 显存容量:单卡显存需达到80GB以上,才能容纳百亿级参数的模型权重,若进行全量微调,建议单卡显存不低于128GB。
  • 互联带宽:卡间通信速度直接影响分布式训练效率,NVLink或同等高速互联技术是必须的,它能将多张GPU连接成一个逻辑上的超大显存池。
  • 算力精度:支持FP8和BF16混合精度计算,可在保持精度的同时大幅提升吞吐量。

推理部署场景的成本优化

推理场景对延迟敏感,但对绝对算力的要求低于训练,能效比成为核心指标。

  • 专用推理芯片:针对特定模型架构优化的ASIC芯片,在特定任务上的能效比通用GPU高出数倍。
  • AI大模型用卡怎么选择?2026年热门AI绘画软件推荐

  • 显存复用技术:利用KV Cache量化技术,可在有限显存下支持更长的上下文窗口,降低硬件门槛。
  • 集群规模:中小规模部署可采用单卡或多卡方案,大规模部署则需关注网络拓扑结构,避免通信瓶颈。
对比不同硬件的适用场景

硬件类型 主要优势 典型应用场景 成本特征
高端GPU 通用性强,生态完善 大模型预训练、复杂微调 高昂
推理专用NPU 能效比高,延迟低 在线推理、边缘计算 中等
云端算力实例 弹性伸缩,无需运维 短期项目、流量波动大 按需付费

算力租赁与自建集群的决策逻辑

企业面临的首要问题是:自建机房还是租用云端算力?这并非简单的二选一,而是基于业务阶段和资金状况的动态决策。

自建集群的长期价值

对于拥有稳定业务流的大型企业,自建集群在长期来看更具成本优势。

  • 数据隐私:核心数据不出域,满足金融、医疗等行业的合规要求。
  • AI大模型用卡怎么选择?2026年热门AI绘画软件推荐

  • 定制化优化:可根据自身模型特点调整硬件架构和软件栈,实现极致性能。
  • 资产沉淀:硬件作为固定资产,可计入资产负债表,优化税务结构。

自建集群的初始投入巨大,且需要专业的运维团队,据行业共识认为,只有当算力需求持续稳定在千卡级别以上时,自建才具备经济性。

云端算力的灵活优势

对于初创公司或业务波动较大的企业,云端算力是更优选择。

  • 零初始投入:无需购买硬件,按使用量付费,降低现金流压力。
  • 弹性扩容:在促销或热点事件期间,可迅速扩容应对流量高峰。
  • 技术跟随:云厂商会不断更新硬件,用户无需担心设备过时。

需要注意的是,长期高频使用云端算力,总成本可能远超自建,混合云架构成为趋势:核心模型在本地训练,推理任务在云端弹性调度。

2026年AI算力成本控制策略

算力成本是AI项目的主要支出之一,通过技术手段和管理策略优化成本,是提升竞争力的关键。

模型压缩与量化技术

通过减少模型参数精度,可在几乎不损失性能的前提下,显著降低显存占用和计算需求。

  • INT8量化:将32位浮点数转换为8位整数,计算速度提升2-4倍,显存占用减少75%。
  • 稀疏化训练:在训练过程中引入稀疏性,去除冗余连接,减少计算量。
  • 知识蒸馏:用大模型指导小模型训练,使小模型具备接近大模型的性能,从而降低推理硬件要求。
AI大模型用卡怎么选择?2026年热门AI绘画软件推荐

资源调度与利用率提升

硬件闲置是最大的浪费,提高资源利用率是降本的核心。

  • 超分技术:在单卡上运行多个轻量级任务,通过时间片轮转提高利用率。
  • 异步训练:将数据预处理、梯度计算等步骤异步化,避免GPU等待数据。
  • 监控与预警:建立实时监控体系,及时发现并解决资源泄漏或低效使用问题。

常见问题解答

AI大模型用卡怎么选择性价比高的方案

选择性价比高的方案需结合具体任务,对于训练任务,优先考虑显存带宽大的高端GPU集群,如配备HBM3e内存的型号,虽然单价高,但训练时间短,总成本可控,对于推理任务,可选择支持INT8量化的推理专用芯片或云端实例,按需付费,避免资源闲置,建议先进行小规模试点,评估实际性能与成本比,再决定大规模投入。

2026年AI算力租赁价格趋势如何

近年来,随着芯片产能提升和市场竞争加剧,AI算力租赁价格呈下降趋势,据统计,主流云端GPU实例的价格年均降幅在10%-15%左右,新型低功耗芯片的普及进一步拉低了单位算力的成本,建议企业关注云厂商的长期合约优惠,并在非高峰期使用预留实例,以获取更低价格。

中小企业如何低成本启动AI项目

中小企业可采用“云端轻量训练+本地推理”的模式,利用云端提供的预训练模型进行微调,避免从头训练的高昂成本,推理阶段,可使用消费级显卡或树莓派等边缘设备,通过模型量化技术降低硬件要求,积极参与开源社区,利用社区提供的优化代码和工具,可大幅降低开发成本。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/378580.html

赞 (0)
AI开放平台技术优势有哪些?开放平台接入流程详解
上一篇 2026年6月14日 01:06
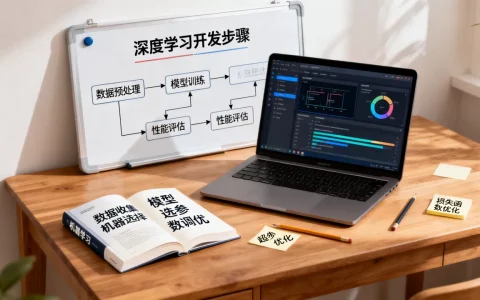
AI机器学习深度学习的关系是什么?开发深度学习模型需要哪些步骤
下一篇 2026年6月14日 01:10

相关推荐

  • 一个主体可以有几个ICP备案号和网站备案号,怎么查询?

    一个主体只能有一个主体备案号,但可以拥有多个网站备案号,每个网站对应一个独立的备案号,ICP主体备案号是什么?一个主体可以有几个备案号?在网站备案的实际操作中,很多人分不清主体备案号和网站备案号的关系,简单说,主体备案号是备案主体的唯一标识,好比你的身份证号;网站备案号是具体网站的备案标识,好比你的每张银行卡号……

    2026年8月14日
    1200
  • AI大模型工场是什么?如何快速入门AI大模型

    AI大模型工场并非单一的软件工具,而是一套集成了算力调度、模型微调、数据治理与业务场景落地的全链路工业化生产体系,旨在帮助企业以最低成本实现从通用大模型到垂直行业专用模型的定制化转型,什么是AI大模型工场:重新定义生产力过去我们谈论人工智能,往往停留在“聊天机器人”或“文案生成”的表层应用,但随着技术迭代,企业……

    2026年6月16日
    4000
  • 服务器参数怎么配置?服务器配置参数详解

    服务器参数配置的核心在于根据业务负载精准匹配CPU、内存与带宽资源,并通过内核优化与监控体系实现性能与成本的最佳平衡,而非盲目追求最高硬件规格,很多站长或运维新手在搭建网站或部署应用时,常陷入一个误区:认为服务器配置越高越好,不当的高配不仅造成资源浪费,还可能因参数默认值不合理导致系统不稳定,服务器参数配置并非……

    2026年7月7日
    13900
  • 大模型微调用Dive教程怎么用?大模型微调需要多少数据

    大模型微调的核心在于通过少量高质量数据让通用模型适配特定垂直场景,相比从头训练,它成本低、速度快且能显著降低幻觉率,是当前企业落地AI的最优解,很多人误以为微调就是“教”AI说话,其实更准确的说法是“引导”AI进入专业语境,2026年的技术环境下,微调不再是科研机构的专利,而是普通开发者也能掌握的标准工程流程……

    2026年6月17日
    2000
  • 服务器托管租赁怎么选?服务器托管租赁费用及注意事项

    服务器托管租赁并非简单的空间租用,而是企业通过物理隔离、独立带宽和专属硬件资源,以低于自建机房成本的方式,实现业务高可用性与数据安全的最佳技术架构方案,在数字化转型的深水区,企业IT基础设施的稳定性直接决定了业务的生死存亡,许多初创团队或中型企业往往陷入一个误区:认为购买云服务器(VPS)就能解决所有问题,当业……

    2026年7月12日
    12600
  • 大模型LoRA微调数据格式怎么准备?LoRA微调数据集怎么制作

    大模型LoRA微调数据的核心在于将原始语料转化为“指令-输入-输出”的标准化JSON或Markdown格式,确保数据质量优于数量,通常建议准备500至2000条高质量样本即可达到显著的效果提升,在2026年的AI应用开发语境下,微调不再是大厂的专利,而是中小团队甚至个人开发者定制垂直领域模型的必经之路,很多开发……

    2026年6月17日
    5300
  • IIS网站后台怎么设置?,后台权限设置有哪些步骤?

    IIS网站后台搭建和设置的核心是:通过Windows Server自带的IIS管理器,完成站点创建、绑定域名、配置权限和部署应用四个步骤,IIS网站后台怎么设置的完整流程很多站长第一次接触IIS时,面对满屏幕的英文菜单容易发懵,其实IIS的后台设置并没有想象中复杂,只要按照站点创建、绑定配置、权限分配、功能扩展……

    2026年8月19日
    300
  • IP雷达与服务器雷达图怎么用?,有什么作用

    IP雷达的服务器雷达图是衡量其节点性能的核心工具,通过多维度指标的可视化对比,能直观判断哪个节点最适合你的具体业务,如何看懂IP雷达服务器雷达图对于刚接触IP雷达的用户来说,雷达图看似复杂,但实际上它把多个关键指标浓缩在一个图形中,让你一眼就能看出节点的优劣,IP雷达服务商会在后台提供节点列表,点击节点名称即可……

    2026年8月5日
    600
  • 如何配置并开启IPv6双栈?,设置方法和注意事项是什么?

    IPv6双栈配置的核心是在路由器和终端设备上同时启用IPv4和IPv6协议栈,使网络能够同时接入两种协议,实现平滑过渡, 目前国内运营商已全面支持IPv6,你只需要在设备和路由器上开启对应功能,就能获得更充裕的地址空间和更低的网络延迟,为什么要开启IPv6双栈?核心好处与适用场景开启IPv6双栈有什么用?双栈能……

    2026年7月31日
    19000
  • vLLM并发数怎么调?vLLM并发参数设置详解

    vLLM的并发数调整核心在于平衡GPU显存利用率与请求延迟,通常通过调整max_num_seqs、max_batch_size及gpu_memory_utilization参数,结合业务对吞吐量和延迟的具体需求进行动态调优,在大规模部署大语言模型时,很多工程师容易陷入一个误区,认为并发数越高越好,或者盲目追求极……

    2026年6月19日
    2400

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

评论列表(1条)

  • 丁伟
    丁伟 2026年7月7日 17:41

    HBM3e是啥新式甜点吗?看得我口水直流……说到这个我饿了,博主你配张火锅图行不行,光看参数没食欲啊!