大模型AI应用已从概念验证走向规模化落地,企业通过构建私有知识库、接入智能客服及自动化工作流,可实现降本增效与业务创新的实质性突破。
大模型AI应用的核心价值与落地场景解析
过去两年,人工智能行业经历了从“炫技”到“实用”的剧烈转向,业内专家指出,单纯的语言生成能力已不再是竞争壁垒,真正的价值在于如何将大模型嵌入具体的业务流程中,对于大多数企业和开发者而言,核心痛点不再是“有没有模型”,而是“怎么用模型解决具体问题”。

智能客服与私域流量运营
传统客服系统依赖关键词匹配,往往答非所问,导致客户流失,大模型的引入彻底改变了这一局面,通过构建基于企业私有数据的知识库,AI能够理解复杂的上下文语境,提供拟人化且准确的解答。
- 多轮对话理解:系统能记住用户前几轮的提问意图,避免重复确认。
- 情感识别与安抚:在检测到用户情绪激动时,自动切换为更温和、更具同理心的话术。
- 无缝转接人工:当问题超出知识库范围或风险等级较高时,自动整理对话摘要并转接人工坐席,提升处理效率。
这种应用不仅降低了人力成本,更通过7×24小时的在线服务提升了用户满意度,据统计,采用大模型优化的智能客服系统,其首次解决率(FCR)有显著提升,且用户满意度评分普遍高于传统规则引擎。
企业知识管理与文档处理
大型企业内部堆积了海量的文档、邮件和项目记录,检索困难是普遍痛点,大模型结合检索增强生成(RAG)技术,能够充当超级搜索助手。
具体操作路径
- 数据清洗与向量化:将PDF、Word、Excel等非结构化数据转换为向量数据库可存储的格式。
- 构建索引:利用Embedding模型对文本片段进行语义编码,建立索引以便快速检索。
- 问答接口开发:用户提问时,系统先检索相关片段,再将片段与问题一同输入大模型,生成基于事实的回答。

这种方式避免了模型“幻觉”带来的风险,确保回答有据可依,对于法律、医疗等专业领域,这种基于事实的问答机制至关重要。
如何评估大模型AI应用的价格与选型策略
在考虑引入大模型技术时,预算和性能平衡是决策的关键,市场上存在多种方案,从直接使用云端API到自建私有化部署,不同路径的成本结构差异巨大。
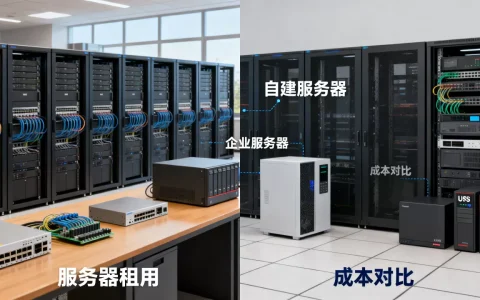
云端API调用与私有化部署对比
许多初创团队倾向于选择云端API,因为无需维护基础设施,按量付费模式灵活,随着数据量的增加,长期成本可能变得不可控,且数据隐私成为顾虑。
| 维度 | 云端API调用 | 私有化部署 |
|---|---|---|
| 初期投入 | 低,无需硬件采购 | 高,需GPU服务器及运维团队 |
| 数据隐私 | 数据需上传至云端,存在泄露风险 | 数据完全本地化,安全性高 |
| 定制化程度 | 受限于厂商提供的模型能力 | 可根据业务需求微调模型参数 |
| 适用场景 | 初创企业、非敏感数据场景 | 金融、政务、大型制造企业 |
对于涉及核心商业机密或受严格监管的行业,大模型AI应用私有化部署方案往往是必然选择,虽然初期投入较大,但长期来看,可控性强且能深度定制。
影响大模型AI应用价格的关键因素
除了部署方式,以下因素也直接决定最终支出:

- 模型参数量:千亿参数模型效果更佳,但推理成本远高于小参数模型。
- 并发请求量:高并发场景需要更多的GPU资源支持,导致算力成本上升。
- 微调数据量:如果需要针对特定领域进行微调,数据清洗和标注的成本不容忽视。
在规划预算时,建议先进行小规模POC(概念验证),测试实际效果与成本比,再决定大规模投入的方向。
大模型AI应用开发实操指南与避坑指南
落地大模型应用并非简单的代码拼接,而是一个系统工程,许多项目失败的原因在于忽视了数据质量、提示词工程以及评估体系的建设。
数据准备:质量优于数量
“垃圾进,垃圾出”在大模型领域尤为适用,构建高质量的知识库是成功的关键。
- 数据清洗:去除重复、乱码、无关广告等内容。
- 格式标准化:将不同来源的数据统一转换为Markdown或JSON等结构化格式,便于解析。
- 切片策略:合理的文本切片长度和重叠率会影响检索精度,通常建议切片长度在200-500字之间,重叠率10%-20%。
提示词工程(Prompt Engineering)优化
提示词是用户与模型沟通的桥梁,优秀的提示词能显著提升输出质量。
常用技巧
- 角色设定:明确告知模型其身份,如“你是一位资深数据分析师”。
- 上下文提供:提供必要的背景信息和参考数据。
- 分步思考:要求模型“一步步思考”,有助于处理复杂逻辑问题。
- 输出格式约束:指定输出为JSON、表格或特定Markdown格式,便于后续程序处理。
评估与迭代:建立闭环反馈机制
模型上线并非终点,而是起点,建立持续的评估和迭代机制,才能确保持续优化。
- 自动化评估:使用自动化测试集对模型输出进行打分,监测准确率、召回率等指标。
- 人工抽检:定期抽取模型回答进行人工审核,发现潜在问题。
- 用户反馈收集:在应用中设置“点赞/点踩”按钮,收集用户真实反馈,用于后续微调。

未来趋势:多模态与Agent智能体
随着技术的演进,大模型的应用边界正在不断拓展,多模态能力使得模型不仅能处理文本,还能理解和生成图像、音频甚至视频。
智能体(Agent)的崛起
传统的AI应用多为被动响应,而智能体具备自主规划、工具使用和执行任务的能力,一个旅行规划智能体可以自动搜索航班、预订酒店、生成行程单,并同步到用户的日历中。
这种从“对话”到“行动”的转变,将极大释放生产力,大模型将成为个人和企业的高效助手,渗透到我们工作的方方面面。
大模型AI应用常见问题解答
大模型AI应用开发需要多长时间?
开发周期取决于项目复杂度,简单的基于API的问答系统,若数据准备充分,可在1-2周内完成原型开发,涉及私有化部署、数据清洗、模型微调及复杂业务逻辑集成的项目,通常需要1-3个月甚至更长时间,关键在于前期数据治理的投入,数据质量直接决定开发进度和最终效果。
大模型AI应用是否适合中小企业?
适合,中小企业无需自建算力集群,可通过云端API或SaaS化服务快速接入大模型能力,重点应放在梳理自身业务场景和数据资产上,利用现有工具链低成本实现智能化升级,如智能客服、内容生成等场景,即可显著降低运营成本。
大模型AI应用的数据安全如何保障?
数据安全保障需采取多层策略,选择支持私有化部署或提供数据隔离服务的供应商,在应用层实施数据脱敏,避免敏感信息直接进入模型,建立严格的访问控制和审计日志,确保数据流转全程可追溯,据工信部相关指南建议,企业应定期进行安全评估,以应对潜在风险。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/386631.html