将大模型部署到GitHub Actions的核心在于利用GitHub提供的免费云资源运行轻量级推理服务,通过构建Docker镜像并配置CI/CD流水线,实现代码提交后自动触发模型加载与接口开放,从而以极低成本完成从开发到测试的闭环验证。
为什么选择GitHub Actions进行大模型部署
对于个人开发者、独立研究人员以及小型创业团队而言,搭建和维护一套完整的大模型推理服务器往往意味着高昂的硬件成本和时间投入,传统的本地部署需要购买高性能GPU显卡,而云端租用GPU实例则面临持续的费用支出,相比之下,GitHub Actions大模型部署提供了一种极具性价比的替代方案,它允许开发者利用GitHub平台内置的计算资源,在代码仓库中直接定义自动化工作流。
业内专家指出,这种模式特别适用于模型推理的轻量级测试、API接口的原型验证以及文档生成等对算力要求不高的场景,虽然它无法替代大规模训练或高并发生产环境,但在“验证想法”和“展示Demo”这两个环节,其效率远超传统方式。
成本对比与资源限制
在决定采用何种部署方案前,明确资源边界至关重要,GitHub Actions提供的免费额度对于大多数小型项目来说已经足够。
- 免费额度:个人账户每月享有2000分钟的免费运行时间,对于偶尔运行的测试任务完全覆盖。
- 计算资源:默认使用Ubuntu 22.04虚拟机,配备2核CPU和7GB内存,注意,这通常不包含GPU,因此需依赖CPU推理或量化后的轻量模型。
- 存储限制:工作流日志保留90天,构建产物缓存有助于加速重复部署。
与本地部署的优劣分析
| 维度 |
GitHub Actions部署 | 本地/云端GPU部署 |
|---|---|---|
| 初始成本 | 几乎为零(利用免费额度) | 高昂(硬件购买或按月付费) |
| 维护难度 | 低(无需管理服务器运维) | 高(需处理驱动、依赖、安全更新) |
| 推理速度 | 较慢(受限于CPU和内存带宽) | 极快(专用GPU加速) |
| 适用场景 | 原型验证、低并发API、自动化测试 | 生产环境、高并发、复杂训练 |
实战:构建自动化部署流水线
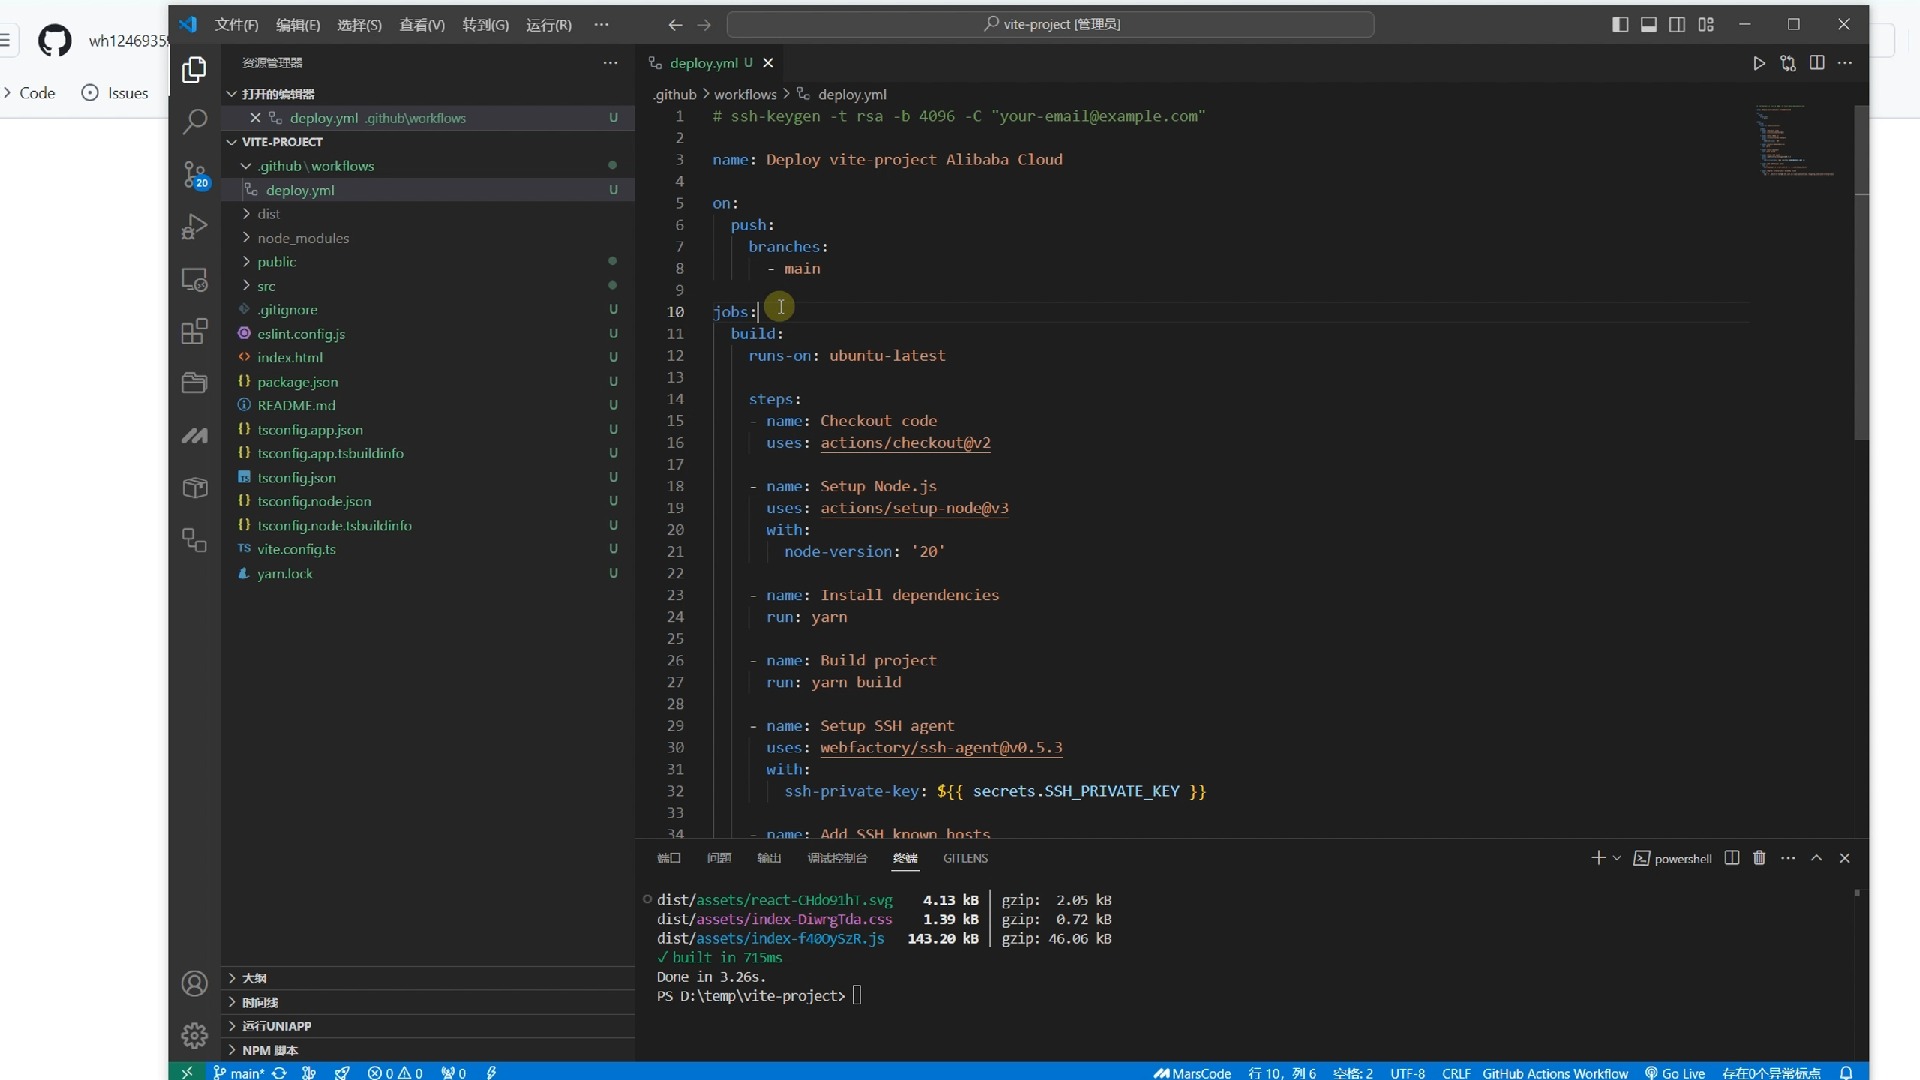
要实现这一流程,核心在于编写.github/workflows目录下的YAML配置文件,这一步骤将代码提交行为转化为具体的服务器操作。
第一步:准备模型与依赖
由于GitHub Actions默认环境不包含庞大的模型文件,直接下载会消耗大量时间,最佳实践是将模型文件上传至Hugging Face Hub或GitHub Releases,并在流水线中按需下载。
- 模型选择:推荐使用经过量化处理的模型,如Qwen2.5-1.5B-Instruct-Q4_K_M或Llama-3.2-3B,这些模型在CPU上运行流畅,且效果足以满足基础对话需求。
- 依赖管理:在`requirements.txt`中固定PyTorch、Transformers及FastAPI的版本,确保环境一致性。
第二步:编写Workflow配置
创建一个名为deploy-model.yml的文件,内容如下:
name: Deploy LLM API
on:
  push:
    branches: [ main ]
  workflow_dispatch: # 允许手动触发
jobs:
  deploy:
    runs-on: ubuntu-latest
    steps:
      - name: Checkout code
        uses: actions/checkout@v4
      - name: Set up Python
        uses: actions/setup-python@v5
        with:
          python-version: '3.11'
      - name: Install dependencies
        run: |
          python -m pip install --upgrade pip
          pip install -r requirements.txt
      - name: Download Model
        run: |
          pip install huggingface_hub
          huggingface-cli download Qwen/Qwen2.5-1.5B-Instruct --local-dir ./model
      - name: Start API Server
        run: |
          # 启动后台服务,监听8080端口
          python app.py --model-path ./model &
          sleep 30 # 等待模型加载完成
      - name: Test API
        run: |
          curl -X POST http://localhost:8080/generate
          -H "Content-Type: application/json"
          -d '{"prompt": "Hello"}'
第三步:代码实现与接口封装
app.py是连接模型与外部世界的桥梁,建议使用FastAPI框架,因为它轻量且自带文档生成能力。
关键代码逻辑
- 模型加载:使用`transformers`库的`AutoModelForCausalLM`和`AutoTokenizer`,设置`device_map=”auto”`以适配当前硬件。
- 推理优化:启用`load_in_4bit`或`load_in_8bit`参数,大幅降低内存占用。
- 超时控制:设置合理的`timeout`,防止因模型生成过长导致GitHub Action超时被强制终止。
常见问题与优化策略
在实际操作中,开发者常遇到模型加载慢、内存溢出等问题,针对GitHub Actions大模型部署失败的情况,以下是经过验证的解决方案。
解决内存不足问题
GitHub Actions的Runner内存有限,加载大模型极易触发OOM(Out Of Memory)。
- 量化技术:务必使用4bit或8bit量化模型,未经量化的FP16模型在7GB内存下几乎无法运行超过1B参数的模型。
- 流式输出:避免一次性生成大量文本,采用流式(Streaming)返回,减少单次请求的内存峰值。
加速模型下载
国内用户访问Hugging Face可能面临网络延迟。
- 镜像加速:在Workflow中配置环境变量`HF_ENDPOINT=https://hf-mirror.com`,利用国内镜像源加速下载。
- 缓存策略:利用GitHub Actions的`actions/cache`功能,缓存`.cache/huggingface`目录,避免每次构建都重新下载模型。
Q&A:GitHub Actions大模型部署常见问题
GitHub Actions大模型部署支持GPU吗?
目前GitHub Actions的免费Runner仅支持CPU环境,虽然GitHub推出了带有NVIDIA A10G GPU的专用Runner,但属于付费服务且资源紧张,对于大多数预算有限的开发者,建议优先优化CPU推理效率,如使用ONNX Runtime或llama.cpp进行推理,而非依赖GPU。
如何确保部署的模型接口安全?
GitHub Actions生成的临时服务器通常暴露在公网,存在安全风险,建议采取以下措施:一是使用API密钥验证,在请求头中添加自定义Token;二是设置IP白名单,仅允许特定来源访问;三是定期轮换密钥,并在任务结束后立即销毁实例,不留持久化存储。
GitHub Actions大模型部署适合生产环境吗?
不适合,GitHub Actions的设计初衷是CI/CD自动化测试,其实例是临时的、无状态的,且存在运行时长限制(通常最长6小时),生产环境需要高可用性、持久化存储和稳定的网络连接,此方案仅适用于原型验证、内部测试工具或轻量级演示项目。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/395890.html