Koboldcpp加载GGUF模型的核心方法是使用命令行参数指定模型路径,通常通过--model参数指向本地.gguf文件,并配合--ctx-size设置上下文窗口,即可在本地终端或GUI界面中快速启动推理服务。
在本地部署大语言模型(LLM)成为开发者和技术爱好者的常态后,如何高效、稳定地运行这些模型成为了首要挑战,Koboldcpp凭借其轻量级和对GGUF格式的原生支持,成为了许多用户的首选工具,它不需要复杂的GPU集群,甚至能在普通笔记本电脑上流畅运行,这极大地降低了AI应用的门槛,对于刚接触这一领域的用户来说,理解其加载机制和参数配置是避免报错、提升性能的关键。
Koboldcpp环境准备与GGUF模型获取
在开始加载模型之前,确保你的运行环境正确无误是基础,Koboldcpp是一个跨平台的二进制工具,支持Windows、macOS和Linux系统,对于大多数用户而言,直接从GitHub Releases页面下载最新版本的预编译二进制文件是最便捷的方式。
系统兼容性检查
不同操作系统对硬件加速的支持程度不同,在Windows环境下,建议优先使用带有CUDA或DirectML支持版本的Koboldcpp,以便充分利用NVIDIA显卡或AMD显卡的计算能力,而在macOS上,得益于Apple Silicon芯片的统一内存架构,Koboldcpp能自动调用Metal加速,无需额外配置驱动,Linux用户则通常依赖CUDA或ROCm库来实现GPU加速,业内专家指出,选择合适的构建版本能显著提升推理速度,尤其是在处理长文本时,GPU加速比纯CPU推理快数倍甚至数十倍。
GGUF模型文件的来源与选择
GGUF是目前主流的大模型量化格式,它取代了早期的GGML格式,提供了更高效的内存管理和更广泛的量化支持,获取模型文件通常有以下几个途径:Hugging Face Hub是主要的模型托管平台,许多开源社区会发布经过量化处理的GGUF版本,用户需要找到对应模型架构(如Llama 3、Mistral、Qwen等)的GGUF文件。
在选择模型时,量化等级是一个重要考量因素,常见的量化等级包括Q4_K_M、Q5_K_M和Q8_0等,Q4_K_M在体积和精度之间取得了较好的平衡,适合大多数消费级显卡;而Q8_0则保留了更高的模型精度,但占用显存更大,据统计,多数情况下,Q4_K_M量化模型在保持较高对话质量的同时,能将显存占用降低至原始FP16模型的三分之一左右,这使得在16GB显存的显卡上运行70亿参数(7B)甚至更大规模的模型成为可能。
命令行加载方式与核心参数解析
虽然Koboldcpp提供了图形用户界面(GUI),但掌握命令行加载方式能让你更灵活地控制模型行为,特别是在服务器部署或自动化脚本中,命令行加载的核心在于理解关键参数的含义及其对性能的影响。
基础加载命令结构
最简单的加载命令如下:
koboldcpp.exe --model ./path/to/model.gguf
这条命令告诉Koboldcpp去加载指定路径下的GGUF文件,如果路径中包含空格,务必使用引号将路径包裹起来,启动后,程序会初始化模型权重,并将其加载到内存或显存中,你可以通过浏览器访问http://localhost:5000来使用Web界面进行对话。
关键参数详解
为了优化加载效果和运行性能,你需要关注以下几个核心参数:
- –ctx-size:设置上下文窗口大小,默认值通常为2048,但对于长文档分析或长对话场景,建议设置为8192或更高,需要注意的是,增大上下文窗口会显著增加显存占用,需确保硬件资源充足。
- –n-gpu-layers:指定加载到GPU的层数,设置为-1表示尽可能将所有层加载到GPU,这是获得最佳性能的配置,如果显存不足,系统会自动回退到CPU推理,但速度会大幅下降。
- –threads:设置CPU线程数,在纯CPU推理或GPU显存溢出时,此参数尤为重要,通常建议设置为物理核心数,以避免线程竞争导致的性能下降。
- –flash-attn:启用Flash Attention技术,这能显著加速注意力机制的计算,特别是在长上下文场景下,但需要硬件和驱动支持。
内存管理与显存优化
当遇到“Out of Memory”错误时,通常是因为模型过大或上下文窗口设置过高,可以尝试减小--ctx-size的值,或者降低模型的量化等级(如从Q5改为Q4),关闭不必要的后台应用程序也能释放部分显存资源,行业共识认为,合理分配CPU和GPU的负载是平衡性能与稳定性的关键,特别是在使用集成显卡或显存较小的独立显卡时。
GUI界面操作与高级功能配置
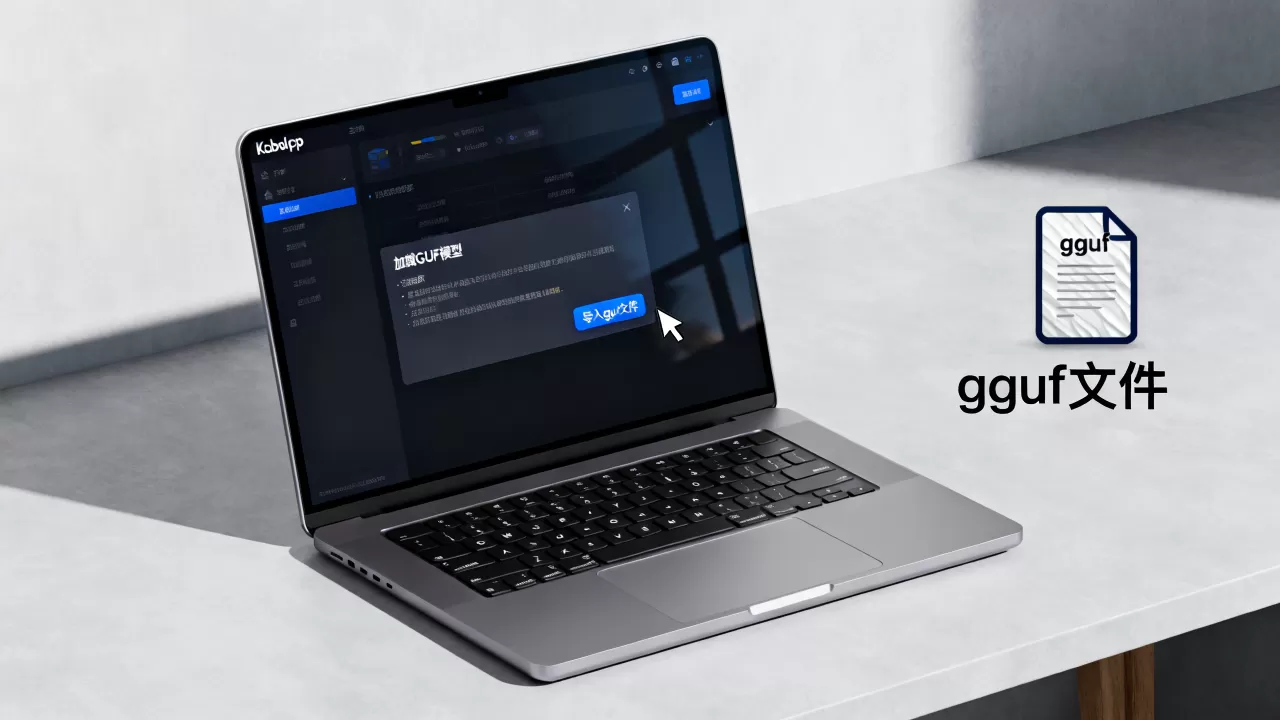
对于不喜欢命令行操作的用户,Koboldcpp自带的GUI界面提供了直观的操作体验,启动GUI后,用户可以在界面上直接选择模型文件,并调整各种参数。
模型选择与路径配置
在GUI的主界面中,点击“Model”标签页,点击“Browse”按钮选择本地的GGUF文件,Koboldcpp会自动识别模型架构,并预填充一些推荐的参数设置,用户可以根据实际情况微调这些设置,例如调整温度(Temperature)和重复惩罚(Repetition Penalty),以控制生成文本的创造性和连贯性。
预设配置与场景切换
Koboldcpp提供了多种预设配置,如“Chat”、“Story”、“Code”等,这些预设针对不同的应用场景优化了参数组合。“Code”预设通常会降低温度,以提高代码生成的准确性;而“Story”预设则可能提高温度,以增强叙事的创造性,用户可以根据自身需求选择或自定义预设,从而快速进入工作状态。
性能监控与日志查看
在运行过程中,用户可以在“Performance”标签页中实时查看GPU显存占用、CPU使用率以及生成速度(Tokens per second),这些信息对于评估模型性能和排查问题非常有帮助,如果生成速度异常缓慢,可以通过日志查看是否有显存交换或CPU瓶颈的迹象。
Koboldcpp与其他推理引擎的对比优势
在众多本地LLM推理工具中,Koboldcpp凭借其简洁性和高效性脱颖而出,与Ollama相比,Koboldcpp更侧重于提供底层的控制能力和灵活性,适合需要精细调整参数的进阶用户,与Text Generation WebUI(oobabooga)相比,Koboldcpp的资源占用更低,启动速度更快,且对GGUF格式的支持更为原生。
资源占用对比
Koboldcpp的二进制文件体积小,运行时内存开销低,在相同硬件条件下,Koboldcpp通常比基于Python的推理框架占用更少的系统资源,这使得它在配置较低的电脑上也能流畅运行。
兼容性优势
Koboldcpp支持多种量化格式,包括Q4_K_M、Q5_K_M、Q8_0等,并能自动检测模型架构,这种广泛的兼容性使得用户可以轻松迁移不同来源的模型,无需进行复杂的格式转换。
常见问题解答
Koboldcpp加载GGUF模型时出现显存不足怎么办?
当出现显存不足错误时,首先检查--n-gpu-layers参数,确保设置为-1以最大化GPU利用,如果仍不足,尝试减小--ctx-size的值,例如从8192降至4096,考虑更换量化等级较低的模型,如从Q8_0切换至Q4_K_M,关闭其他占用显存的应用程序,如浏览器标签页或视频播放器,以释放显存资源。
如何提升Koboldcpp的推理速度?
提升推理速度的关键在于充分利用硬件加速,确保已安装正确的显卡驱动,并在启动命令中启用--flash-attn参数(如果硬件支持),调整--threads参数以匹配CPU核心数,避免线程竞争,使用量化等级较低的模型(如Q4而非Q8)也能显著减少内存带宽压力,从而提升生成速度。
Koboldcpp支持哪些操作系统和硬件平台?
Koboldcpp支持Windows、macOS和Linux三大主流操作系统,在Windows上,支持NVIDIA CUDA和AMD DirectML加速;在macOS上,支持Apple Metal加速;在Linux上,支持NVIDIA CUDA和AMD ROCm加速,对于CPU推理,所有平台均支持OpenMP多线程加速。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/398374.html