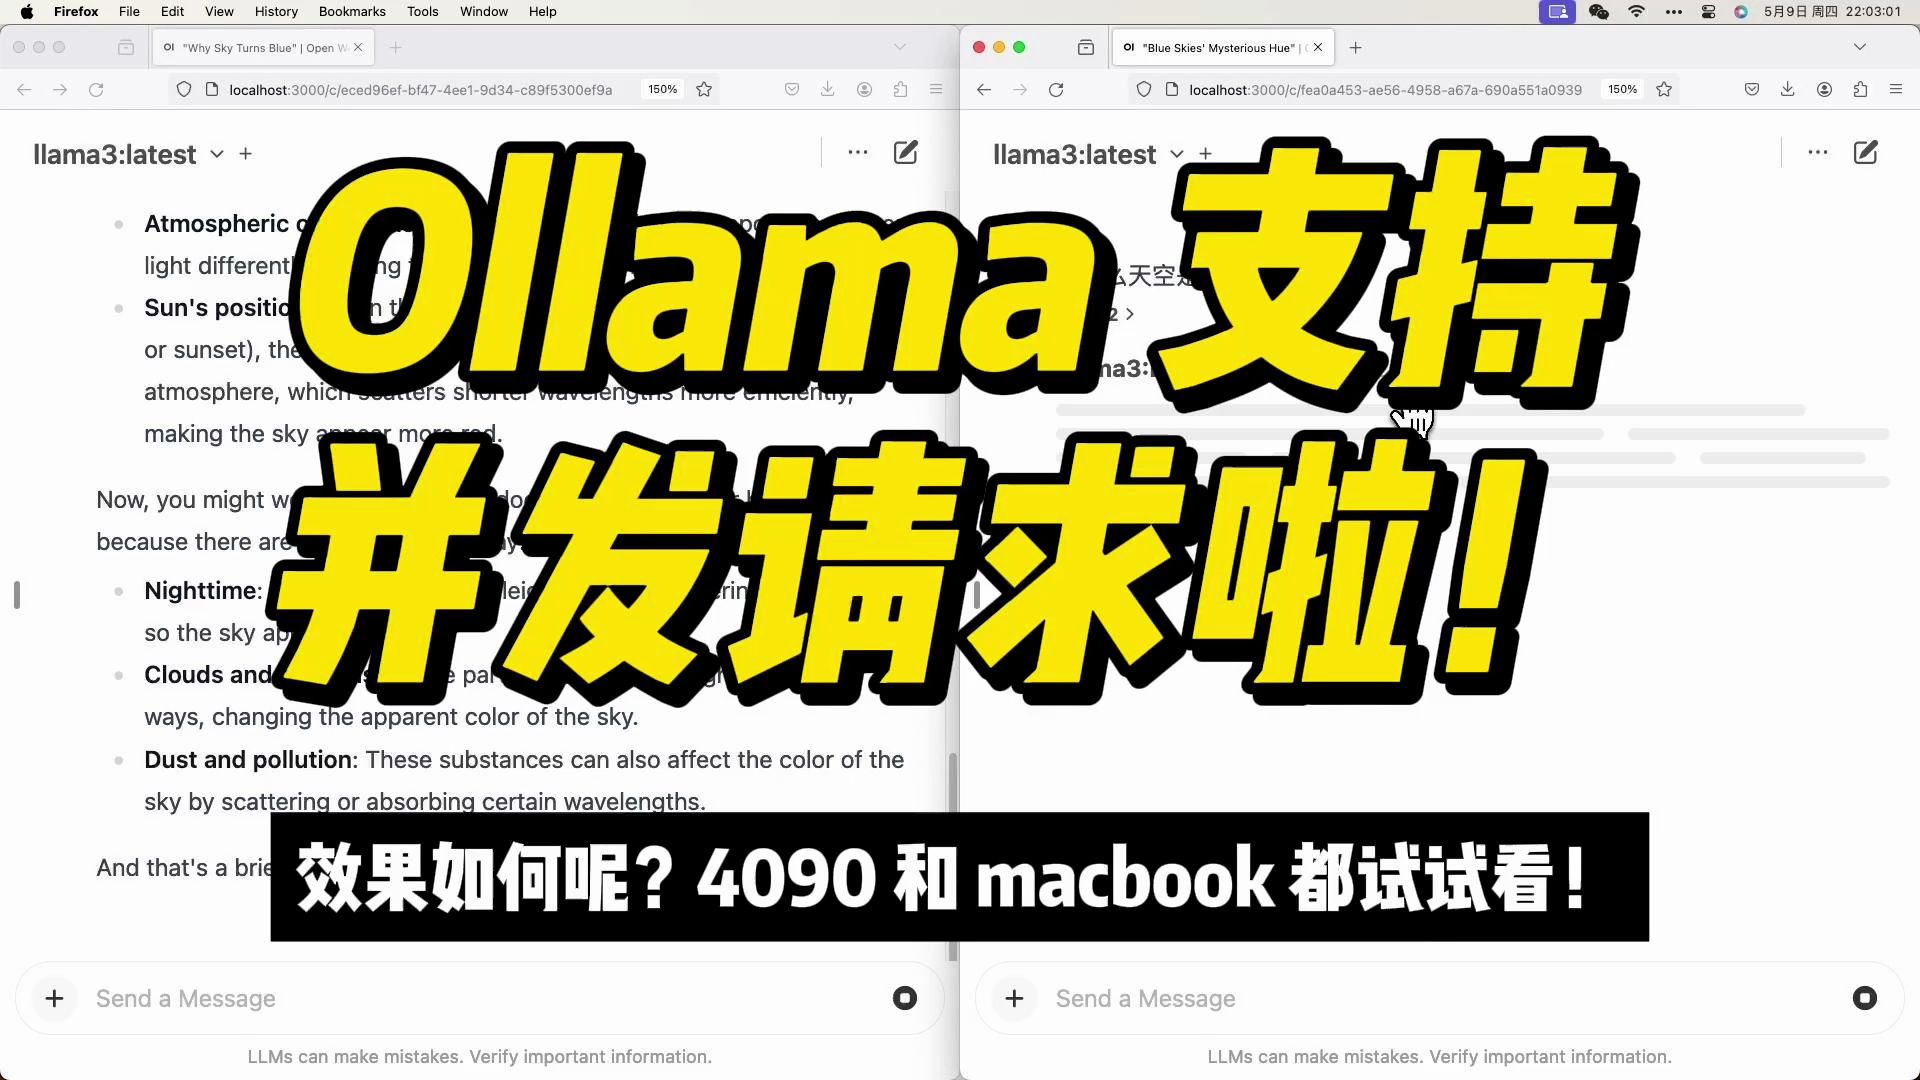
Ollama设置并发的核心在于调整系统环境变量OLLAMA_MAX_LOADED_MODELS和OLLAMA_NUM_PARALLEL,直接控制模型加载数量与并行请求处理数,无需修改代码即可生效。
在本地部署大语言模型时,很多开发者都会遇到“显存爆了”或者“请求排队太久”的困扰,这通常不是模型本身的问题,而是并发配置没有匹配你的硬件资源,Ollama作为一个轻量级的LLM运行框架,其并发机制设计得既灵活又直观,理解并配置好这些参数,能让你的本地AI服务从“单线程龟速”变成“多线程高效处理”。
理解Ollama并发控制的核心参数
要解决Ollama怎么设置并发的问题,首先得搞清楚它背后控制流量的两个关键阀门,这两个变量分别管着“内存里塞多少模型”和“同时处理多少个请求”。
OLLAMA_MAX_LOADED_MODELS:模型加载上限
这个参数决定了你的GPU或CPU能同时保留在显存/内存中的模型数量,默认情况下,Ollama通常设置为1,这意味着同一时间只能有一个模型处于活跃加载状态,当你切换模型时,旧的会被卸载,新的才会加载。
对于拥有大显存(如24GB以上)的NVIDIA显卡用户,将这个数字调高可以显著减少模型切换时的等待时间,如果你同时需要运行Llama 3和Mistral,将其设置为2或3,这两个模型就会常驻内存,切换几乎瞬间完成。
具体设置方法
在Linux或macOS系统中,你需要在启动Ollama服务前导出环境变量。
- Linux/Mac: 在终端执行
export OLLAMA_MAX_LOADED_MODELS=2 - Windows (PowerShell):
$env:OLLAMA_MAX_LOADED_MODELS = "2"
设置完成后,重启Ollama服务,配置即刻生效。

OLLAMA_NUM_PARALLEL:并行请求数
如果说上一个参数管的是“空间”,那么这个参数管的就是“时间”,它控制Ollama服务器同时处理多少个并发API请求,默认值通常也是1或2。
当你的应用后端有多个用户同时发起聊天请求时,如果这个值设为1,请求必须排队,前一个请求完全结束(包括生成所有Token)后,下一个才能开始,这对于高吞吐量的应用场景来说,延迟会非常可怕。
业内专家指出,适当增加并行请求数可以充分利用GPU的空闲算力,特别是在模型推理过程中存在大量I/O等待或计算间隙时。
Ollama并发设置实操指南与场景适配
知道了参数含义,接下来就是如何根据不同硬件和场景进行精准配置,这里没有放之四海而皆准的“最佳值”,只有最适合你当前环境的“平衡点”。
消费级显卡的优化策略
对于大多数使用RTX 3060、4060或4070的用户,显存是最大瓶颈。
- 场景描述:你运行一个7B或8B参数量的模型,显存占用约6-8GB。
- 配置建议:
OLLAMA_MAX_LOADED_MODELS:建议设为1或2,如果显存剩余充足,设为2可以流畅切换不同任务模型。OLLAMA_NUM_PARALLEL:建议设为2或4。
- 原因分析:小模型推理速度快,并行处理几个请求不会造成明显的显存溢出,但如果设得过高,可能导致显存碎片化或OOM(内存溢出),反而导致服务崩溃。
专业工作站与多卡环境的配置
如果你拥有RTX 4090(24GB显存)或多卡SLI/NVLink环境,配置逻辑则完全不同。

- 场景描述:运行13B、34B甚至70B量化模型,或者需要同时处理多个大型文档分析任务。
- 配置建议:
OLLAMA_MAX_LOADED_MODELS:可根据显存总量估算,24GB显存运行两个13B模型(各占约8-10GB),设为2是安全的。OLLAMA_NUM_PARALLEL:可以大胆尝试8、16甚至更高。
- 原因分析:大模型推理计算密集,GPU利用率容易饱和,提高并行数可以让多个请求的计算任务交错执行,填满GPU的计算单元,从而提升整体吞吐量。
常见误区与故障排查
在尝试Ollama并发调优时,开发者常陷入一些思维陷阱,导致配置后效果不佳。
并发数越高越好
这是一个典型的线性思维错误,并发数并非无限提升就能线性增加性能,当并发数超过硬件处理能力时,上下文切换开销会急剧增加,甚至导致显存交换到系统内存,造成性能断崖式下跌。
据统计,多数情况下,将并行数设置为GPU核心数的2-4倍是一个较为合理的起始点,随后需通过压测寻找拐点。
忽略批处理(Batching)的影响
Ollama底层依赖于llama.cpp等推理引擎,这些引擎支持动态批处理,当你设置较高的OLLAMA_NUM_PARALLEL时,Ollama会自动将多个请求合并为一个批次发送给推理引擎。
如果请求长度差异巨大,可能会导致某些短请求被长请求阻塞,在设置高并发时,建议监控请求的平均长度分布。
故障排查清单
如果设置并发后出现服务不稳定,请按以下步骤检查:
- 检查显存占用

:使用
nvidia-smi命令,观察显存是否持续高位运行,如果频繁出现OOM错误,说明OLLAMA_MAX_LOADED_MODELS设置过高。 - 检查CPU负载:如果并发请求数极高,且模型较小(如3B以下),CPU可能成为瓶颈,此时应适当降低
OLLAMA_NUM_PARALLEL。 - 验证环境变量:确保环境变量在Ollama服务启动前已正确加载,可以通过在终端运行
ollama serve并观察日志,或编写一个简单的Python脚本调用API来测试并发效果。

Q&A:Ollama并发设置常见问题
如何动态调整Ollama的并发参数而不重启服务?
Ollama目前不支持热加载环境变量,修改OLLAMA_MAX_LOADED_MODELS或OLLAMA_NUM_PARALLEL后,必须完全停止并重新启动Ollama服务才能生效,对于生产环境,建议使用systemd或docker-compose管理进程,以便快速重启。
OLLAMA_NUM_PARALLEL设置过高会导致什么具体后果?
主要后果包括显存溢出(OOM)、推理延迟增加以及系统资源争用,当并发请求过多时,GPU需要在多个上下文之间频繁切换,导致缓存命中率下降,实际吞吐量反而降低,过多的并发请求可能导致API响应超时,影响前端用户体验。
如何测试当前的并发配置是否合理?
可以使用简单的Python脚本结合requests库进行压力测试,编写一个循环,同时发起多个POST请求到/api/generate或/api/chat端点,记录每个请求的响应时间,观察随着并发数增加,平均响应时间的变化曲线,当响应时间开始显著非线性增长时,即为当前硬件的并发瓶颈点。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/400079.html