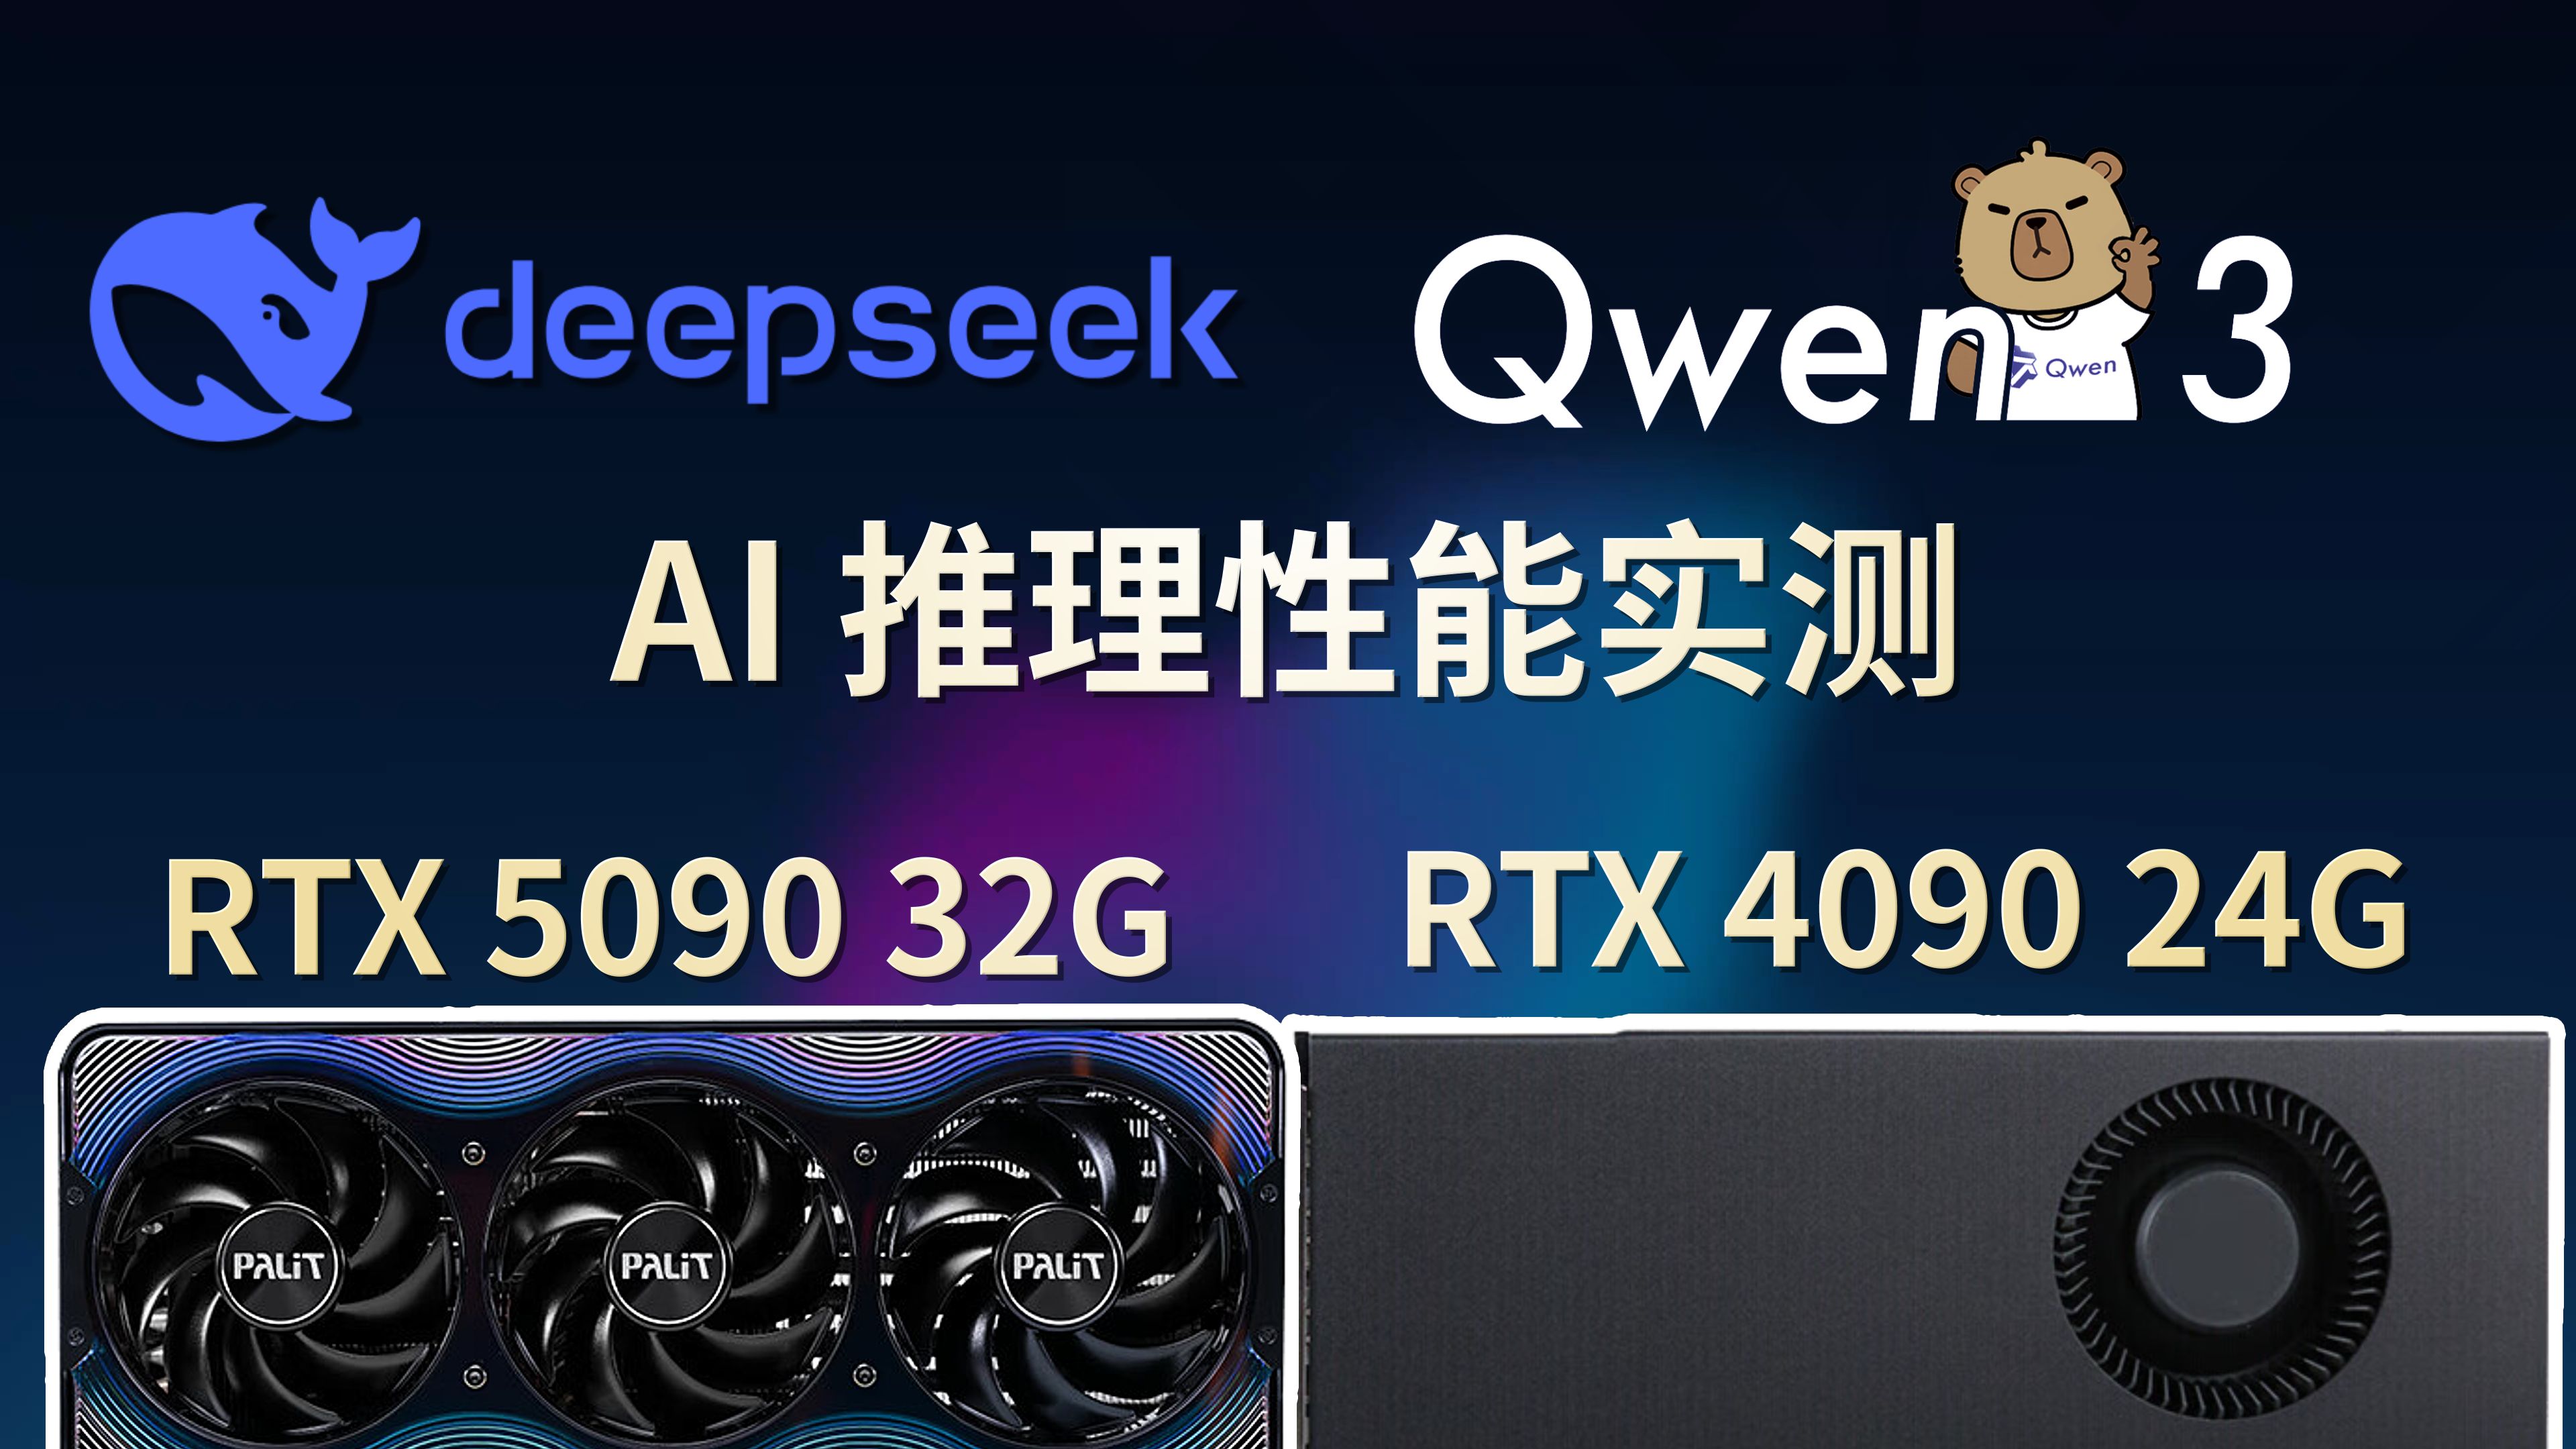
RTX 4090跑130亿参数大模型完全够用,但需接受量化压缩后的精度折损,且仅适合单卡本地推理,无法支撑高并发生产环境。
在2026年的当下,个人开发者或小型团队常面临硬件预算与模型能力之间的博弈,130亿参数(13B)处于大模型生态的甜蜜点:它比7B模型更聪明,又比70B模型轻量得多,RTX 4090凭借24GB显存,成为这个区间最热门的“平民神器”,是否真的“够”,取决于你对速度、精度和使用场景的具体定义。
RTX 4090跑130亿参数大模型显存够用吗
显存是本地部署大模型的硬约束,130亿参数模型在FP16(半精度)格式下,权重占用约26GB显存,这已经超过了RTX 4090的24GB物理上限,直接加载原始模型是不可行的,必须采用量化技术。
业内专家指出,量化是将高精度数据转换为低精度数据的过程,能在几乎不损失智能表现的前提下大幅降低显存需求,目前主流的INT8量化将13B模型压缩至约7-8GB显存,INT4量化则进一步降至4-5GB,这意味着,RTX 4090的24GB显存不仅“够用”,甚至显得“奢侈”。
不同量化级别的显存占用对比
为了更直观地理解资源分配,我们来看具体数据:
| 量化格式 | 显存占用估算 | 推理速度影响 | 智能水平折损 |
|---|---|---|---|
| FP16 (未量化) | ~26 GB | 极慢或OOM | 无 |
| INT8 (8位量化) | ~7-8 GB | 快 | 轻微 |
| INT4 (4位量化) | ~4-5 GB | 极快 | 中等 |
| Q4_K_M (GGUF) | ~5-6 GB | 极快 | 极低 |
注:以上数据基于常见开源模型架构估算,实际占用因上下文窗口长度而异。

RTX 4090在处理INT4或INT8量化后的13B模型时,剩余显存可全部用于KV Cache(键值缓存),这允许你设置更长的上下文窗口(Context Window),例如轻松支持32K甚至更长文本的输入,这是小显存显卡(如16GB或12GB型号)难以企及的优势。
RTX 4090推理13B模型速度与延迟表现
速度是本地部署的核心体验指标,RTX 4090拥有16384个CUDA核心和1008 GHz的加速频率,配合GDDR6X显存,在推理任务中表现强劲。
Token生成速度实测参考
在典型的大语言模型推理框架(如llama.cpp或vLLM)下,RTX 4090运行INT4量化的13B模型:
- 首Token延迟(TTFT):通常在0.5秒至1秒之间,取决于提示词长度。
- 后续Token生成速度:可达30-50 tokens/秒。
这个速度意味着什么?对于日常对话、代码辅助或文档摘要,这个速度是“即时”的,用户几乎感觉不到等待,相比云端API,本地推理消除了网络波动的影响,提供了更稳定的体验。
若追求极致速度,需关注量化格式的选择,INT4虽然速度快,但可能在复杂逻辑推理上略有下降;INT8则在速度和精度间取得更好平衡,对于大多数用户,INT8是RTX 4090上的最佳甜点设置。
影响速度的关键变量
- 上下文长度:随着输入文本变长,KV Cache占用增加,推理速度会线性下降。
- 批次大小:默认批次大小为1,若启用动态批次调度,吞吐量提升,但延迟增加。
- 模型架构:不同架构(如Llama、Mistral、Qwen)对CUDA核心的利用率不同,需针对性优化。
RTX 4090部署13B大模型实操指南
理论上的“够用”需转化为实际操作,以下是基于主流开源工具的部署路径,确保你能够顺利运行。
环境准备与工具选择
推荐使用Ollama或LM Studio,它们对新手友好,无需编写代码即可快速启动,对于高级用户,llama.cpp是性能优化的首选。
- 安装Ollama:访问官网下载Windows/Linux/macOS版本,一键安装。
- 拉取模型:在终端执行命令
ollama run qwen2.5:14b(注:14B与13B同属一类,社区常用14B作为代表)。 - 验证运行:启动后,尝试输入“解释量子计算”,观察响应速度和内容质量。

使用llama.cpp进行高级优化
若需更高控制力,可使用llama.cpp:
- 下载模型文件:从Hugging Face获取GGUF格式的模型,推荐选择Q4_K_M量化版本。
- 编译引擎:克隆llama.cpp仓库,执行
make编译,确保启用CUDA支持。 - 运行推理:使用命令
./main -m model.gguf -p "你的提示词" -ngl 35,其中-ngl 35指定加载层数,RTX 4090可轻松加载全部层。
常见问题排查
- 显存不足:若出现OOM错误,检查是否同时运行其他GPU密集型应用(如游戏、视频渲染)。
- 速度缓慢:确认模型是否完全加载至GPU,可通过任务管理器查看GPU利用率。
- 回答质量差:尝试切换至INT8量化,或调整温度参数(Temperature)至0.7以获得更平衡的输出。
RTX 4090跑130亿参数大模型性价比如何
在2026年,硬件价格波动较大,但RTX 4090的二手市场和新卡价格仍具吸引力,相比云端API按Token计费,本地部署是一次性投入,长期使用成本更低。
成本效益分析
- 电力成本:RTX 4090满载功耗约450W,但推理时功耗通常低于200W,假设每天使用2小时,每月电费约10-15元,远低于API调用费用。
- 隐私安全:数据完全本地处理,无泄露风险,适合处理敏感商业文档或个人隐私数据。
- 离线可用:无需网络连接,适合网络不稳定或离线环境。
与其他方案对比
| 方案 | 初始成本 | 长期成本 | 隐私性 | 灵活性 |
|---|---|---|---|---|
| RTX 4090本地部署 | 高 | 低 | 高 |
高 |
| 云端API调用 | 低 | 高 | 低 | 中 |
| 多卡集群 | 极高 | 中 | 高 | 极高 |

对于个人开发者和小型团队,RTX 4090提供了最佳的平衡点,若需更高并发,可考虑多卡互联,但复杂度显著增加。
RTX 4090跑130亿参数大模型未来升级建议
技术迭代迅速,13B模型可能在几年后显得过时,RTX 4090的24GB显存虽当前充裕,但面对未来更大模型时可能捉襟见肘。
软件优化优先
在硬件升级前,充分挖掘现有潜力:
- 启用Flash Attention 2:显著提升长文本处理速度,降低显存占用。
- 使用AWQ或GPTQ量化:这些技术比传统INT4更高效,精度损失更小。
- 模型蒸馏:将大模型知识蒸馏至更小模型,提升推理效率。
硬件升级路径
若未来需运行70B+模型,RTX 4090将不再适用,此时可考虑:
- 双卡方案:利用PCIe带宽实现模型并行,但需主板支持。
- 专业卡升级:如NVIDIA A100或H100,但成本极高,适合企业级应用。
- 云租赁:按需使用云端高性能实例,避免硬件沉没成本。
Q&A:RTX 4090跑130亿参数大模型常见疑问
RTX 4090能同时运行多个13B模型吗?
可以,但需量化至INT4或更低精度,每个INT4模型占用约5GB显存,24GB显存理论上可容纳3-4个实例,但推理速度会因显存带宽竞争而下降。
13B模型与7B模型在RTX 4090上有何区别?
7B模型在RTX 4090上可轻松实现FP16精度,速度更快,但智能水平有限,13B模型需量化,智能水平更高,适合复杂任务,是性能与能力的平衡选择。
RTX 4090适合训练13B模型吗?
不适合,RTX 4090仅适合推理,训练13B模型需数百GB显存或分布式集群,本地单卡无法完成全参数训练,仅支持轻量级微调(LoRA)。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/402055.html