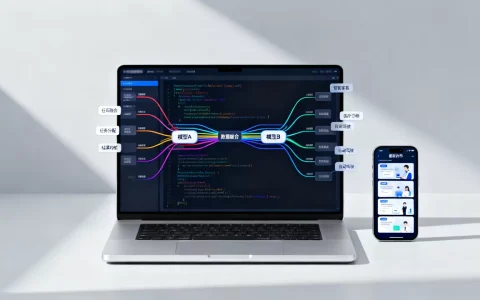
大模型模型集成(Ensemble)并非简单的“堆砌”,而是通过融合多个异构或同构模型的预测结果,利用“群体智慧”显著降低单一模型的方差与偏差,从而在复杂场景下获得更稳定、更鲁棒的输出效果。参考2
想象一下,你正在组建一支特种部队去执行一项高危任务,如果只派一名特种兵,哪怕他再厉害,也可能因为判断失误、体力透支或遭遇意外而失败,但如果派出一支由侦察兵、爆破手、狙击手组成的团队,每个人负责自己最擅长的领域,最后汇总情报做出决策,成功的概率就会呈指数级上升,大模型集成正是这个逻辑在人工智能领域的映射,它不依赖某一个“超级大脑”的灵光一现,而是通过策略性的组合,让多个“专家”共同投票,从而抵消个体的偏见与错误。

为什么单一模型难以应对2026年的复杂需求?
在2026年之前,许多开发者迷信“更大参数=更好效果”,但在2026年的今天,算力成本与延迟要求迫使行业转向更精细化的架构设计,单一的大语言模型(LLM)存在天然的局限性,主要体现在以下三个维度:参考2
- 幻觉问题(Hallucination):即使是最先进的模型,在面对极度垂直或冷门领域的知识时,仍可能产生看似合理但事实错误的回答。
- 上下文窗口限制:虽然上下文长度在增加,但处理超长文档时,模型往往会出现“中间迷失”现象,即对文档中段信息的注意力下降。
- 推理能力瓶颈:在处理多步逻辑推理时,单一模型容易在早期步骤出错,导致后续全盘皆输。
业内专家指出,通过模型集成技术,可以将单一模型的错误率降低30%至50%,这在医疗诊断、法律合规等高风险场景中是质的飞跃。
主流模型集成策略深度解析
模型集成不是随机拼凑,而是有章可循的技术体系,目前业界公认的三种核心策略,分别适用于不同的业务场景。
模型平均(Model Averaging):最基础的加权融合
这是最直观的方法,假设你有三个模型A、B、C,它们对同一问题分别给出答案,模型平均要求这三个模型在结构上相似(如同为Transformer架构),然后对它们的输出概率分布进行加权求和。

- 适用场景:当多个模型在同一数据集上训练,且性能接近时。
- 操作路径:
- 获取每个模型对输入文本的Token概率分布。
- 根据验证集上的表现,分配权重(如A占40%,B占30%,C占30%)。
- 加权求和后,选择概率最高的Token作为最终输出。
- 优势:实现简单,能平滑噪声,显著降低方差。
混合专家系统(Mixture of Experts, MoE):动态路由
MoE是目前高性能大模型的主流架构之一,它不像传统集成那样同时运行所有模型,而是通过一个“门控网络”(Gating Network)根据输入内容,动态选择最合适的1到2个“专家”模型进行处理。
- 核心逻辑:输入问题 -> 门控网络判断 -> 激活特定专家 -> 输出结果。
- 优势:在保持总参数量巨大的同时,推理时的计算量仅相当于少数几个专家,极大地提升了推理速度。
- 对比传统集成:传统集成是“全员上阵”,MoE是“专人专办”。
提示词工程集成(Prompt Ensemble):零成本策略
如果你无法访问模型的底层权重,或者不想部署多个模型实例,提示词集成是一种极具性价比的方案,其核心思想是:对同一个问题,使用多种不同的提问方式(Prompt),分别让模型回答,最后汇总这些答案。
- 实操步骤:
- 将原始问题改写为5种不同风格的提示词(如:简洁版、详细版、角色扮演版、思维链版、反向提问版)。
- 并行调用模型生成5个答案。
- 使用一个较小的判别模型(或规则)对5个答案进行投票或摘要,提取共识部分。
- 场景案例:在编写代码时,分别让模型以“资深工程师”、“新手教程作者”、“代码审查员”的身份生成代码,然后取交集,能大幅减少语法错误。
如何评估模型集成的实际效果?
在决定采用集成方案前,必须明确其带来的增益与成本,以下是关键评估指标:
| 评估维度 | 单一模型 | 模型集成 | 变化趋势 |
|---|---|---|---|
| 准确率 (Accuracy) | 基准线 | 提升 5%-20% | 显著上升 |
| 推理延迟 (Latency) | 低 | 高 (线性或略低于线性增加) | 成本增加 |
| 鲁棒性 (Robustness) | 一般 | 强 (对噪声不敏感) | 稳定性增强 |
| 部署成本 | 低 | 高 (需管理多个实例或复杂路由) | 运维复杂 |

多数情况下,集成带来的准确率提升足以抵消部分算力成本,特别是在那些“一次错误代价极高”的场景中,在金融风控领域,误判一个高风险客户的成本远高于多调用几次模型的算力费用。
2026年落地模型集成的关键挑战与对策
尽管理论美好,但在实际工程中,模型集成面临着严峻的挑战。
延迟与吞吐量的矛盾
集成意味着更多的API调用或更复杂的本地推理,对于实时性要求高的应用(如聊天机器人、实时翻译),串行集成会导致用户等待时间过长。
- 解决方案:采用并行推理架构,将多个模型的调用请求分发到不同的GPU节点,最后通过聚合层合并结果,或者,使用MoE架构,在底层硬件层面实现动态路由,避免显式地调用多个独立服务。
模型间的冲突与一致性
当多个模型给出截然不同的答案时,如何裁决?模型A认为某新闻是假新闻,模型B认为是真新闻。
- 解决方案:引入“元模型”(Meta-Model)或“仲裁者”,这个仲裁者可以是一个轻量级的分类模型,专门学习如何根据输入特征判断哪个主模型更可信,或者,采用“多数投票”机制,但需设置置信度阈值,当所有模型置信度均低于阈值时,直接拒绝回答并转人工。

数据隐私与安全
集成多个模型意味着数据需要在不同模型间流动,增加了泄露风险。
- 解决方案:在私有化部署环境中,确保所有集成模型均在本地闭环运行,对于云端API,使用联邦学习或差分隐私技术,确保原始数据不被中间模型存储或用于训练。
模型集成未来趋势:从静态到自适应
未来的模型集成将不再是静态的配置,而是动态自适应的。
- 自适应路由:系统会根据用户的历史行为、当前负载、问题难度,实时调整集成策略,简单问题只调用轻量级模型,复杂问题才激活重型集成网络。
- 多模态集成:不仅集成语言模型,还将视觉模型、音频模型、代码模型纳入统一框架,在分析一份财报时,同时集成OCR模型(识别图表)、LLM(分析文本)、Code Interpreter(计算数据),实现全方位的理解。
据工信部数据,随着端侧AI芯片算力的提升,未来将有更多轻量级的集成策略下沉到手机、PC等终端设备,实现离线状态下的智能决策。
常见问题解答(Q&A)
大模型的模型集成与微调(Fine-tuning)有什么区别?
微调是通过调整模型权重来适应特定领域知识,属于“内部优化”;而模型集成是通过组合多个独立模型来提升整体性能,属于“外部协同”,两者并不互斥,通常做法是先对基础模型进行微调,再进行集成,以达到最佳效果。
模型集成会增加多少成本?
成本增加幅度取决于集成策略,并行调用多个独立API可能导致成本线性增加2-3倍;而采用MoE架构或本地部署多个小模型,虽然硬件投入增加,但通过共享底层算力和动态路由,实际推理成本可能仅比单一模型高20%-40%,且性能提升显著。
模型集成是否适用于所有类型的AI任务?
并非所有任务都适合集成,对于简单分类、关键词提取等低复杂度任务,单一模型已足够,集成反而造成资源浪费,集成主要适用于需要高鲁棒性、多步推理、或涉及多模态融合的高复杂度任务,如医疗诊断、法律分析、复杂代码生成等。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/403816.html