


大模型的可解释性是指通过技术手段揭示模型内部决策逻辑、特征权重及推理路径的能力,其核心在于打破“黑盒”状态,让AI的每一次输出都变得透明、可信且可追溯。
在2026年的今天,人工智能已经深入医疗、金融、法律等高风险领域,当医生依赖AI诊断病情,或银行使用算法审批贷款时,仅仅知道“结果是好的”已经远远不够,用户和监管机构更关心的是“为什么是这个结果”,可解释性(Interpretability)不再是锦上添花的技术点缀,而是大模型落地的准入门槛,它解决了信任危机,满足了合规要求,并为模型优化提供了明确方向。
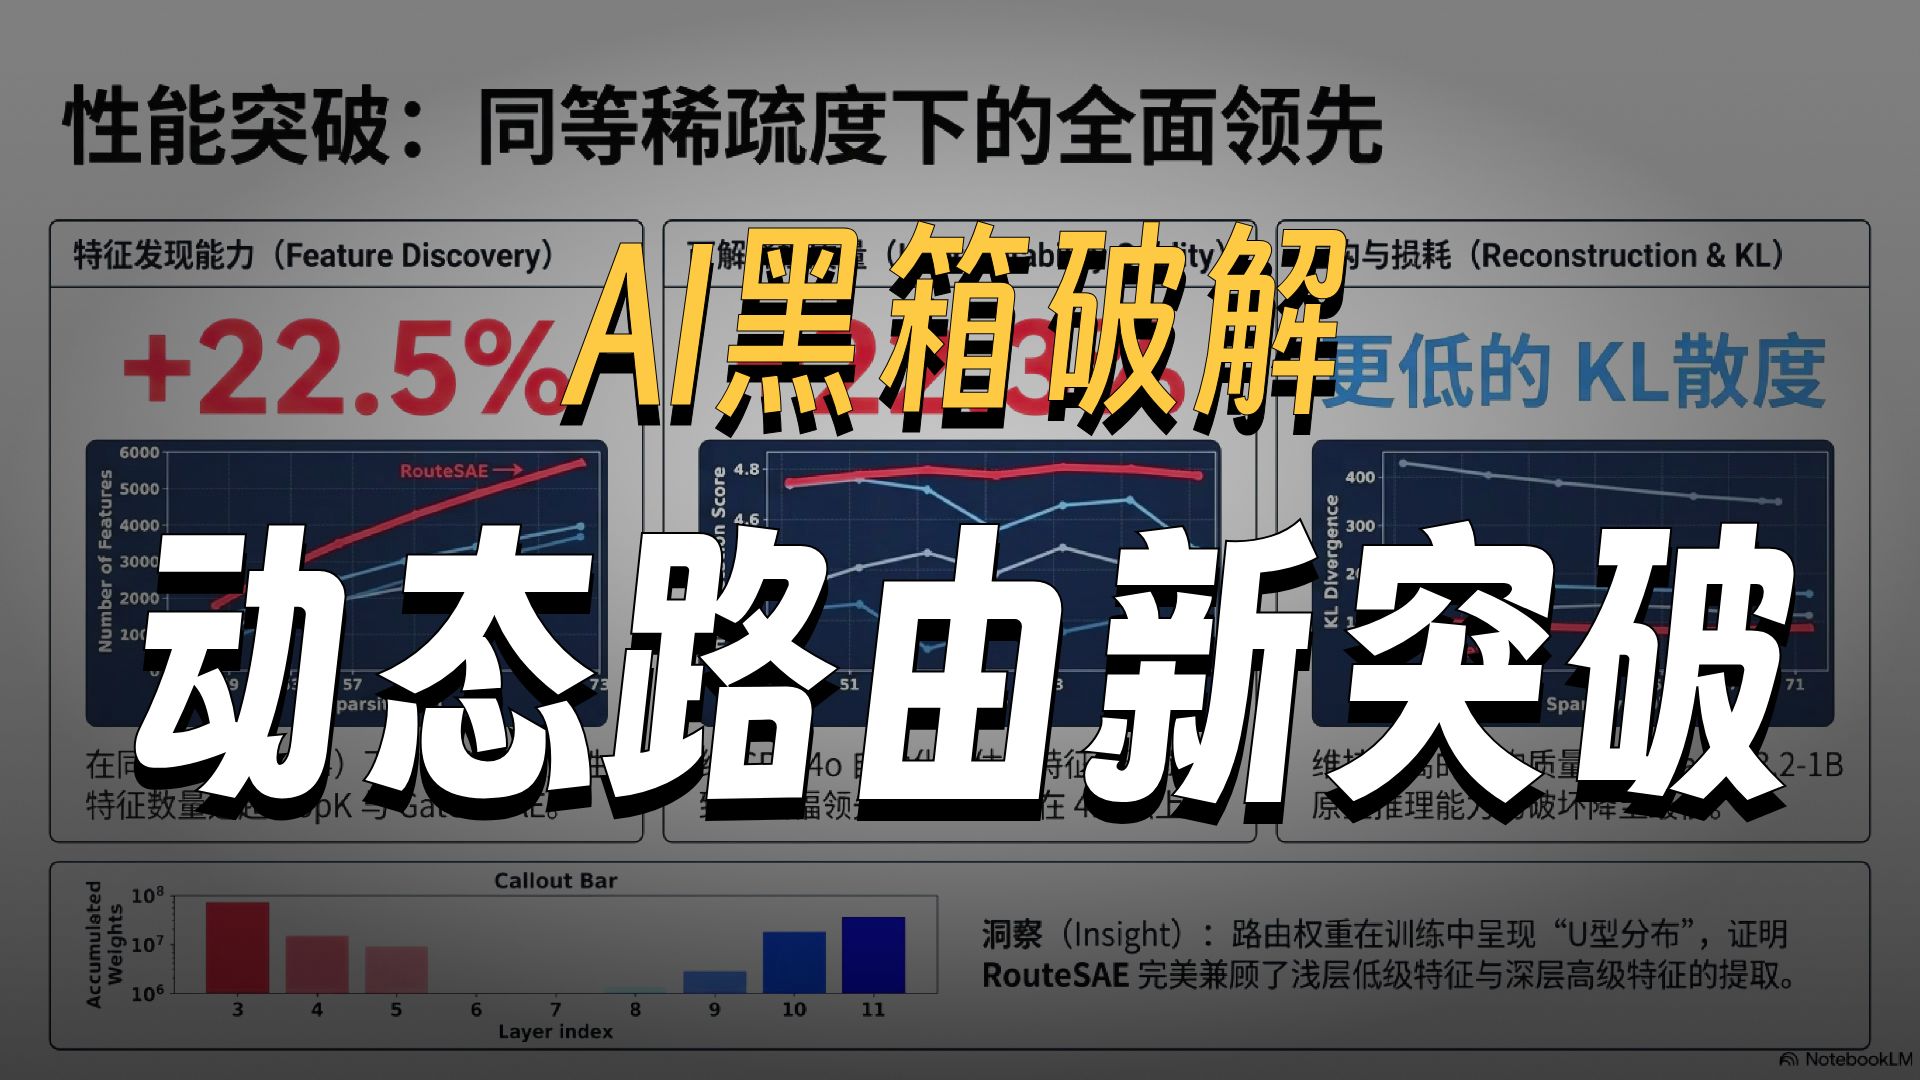

为什么大模型需要“透明化”?核心驱动力解析
大模型参数量动辄万亿级别,传统的代码逻辑无法直接映射其内部运作,业内专家指出,缺乏可解释性会导致“幻觉”频发且难以定位,这在关键任务中是致命的。
信任构建与风险控制
在自动驾驶或医疗辅助场景中,错误的决策成本极高,如果模型给出一个错误诊断,却无法指出是基于哪个症状或影像特征做出的判断,人类专家就无法验证其合理性,可解释性工具能够高亮显示输入数据中的关键部分,例如在文本中圈出导致负面情感判断的关键词,或在医学影像中标记出疑似病灶区域,这种可视化反馈让专业人士能够快速复核,建立对系统的信任。
合规监管与法律责任
随着《人工智能法案》等全球性法规的推进,算法透明度成为法律强制要求,特别是在欧盟和中国,涉及个人权益的自动化决策必须提供有意义的解释,企业若无法证明其模型决策的公平性和逻辑性,将面临巨额罚款和业务停摆风险,可解释性技术提供了审计轨迹,确保模型没有基于种族、性别等敏感属性进行歧视性决策。
主流可解释性技术路线对比
目前业界主要采用事后解释(Post-hoc)和内在可解释(Intrinsic)两条路径,不同场景下,技术选型差异巨大。
事后解释:黑盒之外的透视眼

这类方法不改变模型结构,而是通过外部分析来推测模型行为。
- SHAP值分析:基于博弈论,计算每个特征对最终预测的贡献度,它能准确回答“哪个因素对结果影响最大”,适合结构化数据场景。
- LIME局部近似:通过在输入点附近构建简单的线性模型来近似复杂模型的行为,它擅长解释单个样本的决策原因,但在高维文本数据上可能存在偏差。
- 注意力机制可视化:针对Transformer架构,直接展示模型在生成输出时关注的输入token权重,这是大语言模型最直观的解释方式,能清晰看到模型“看”到了哪些词。
内在可解释:设计之初的透明基因
这类模型从架构上就限制了复杂度,追求逻辑清晰。
- 稀疏线性模型:虽然表达能力有限,但权重直接对应特征重要性,完全透明。
- 决策树集成:如XGBoost,虽然树结构复杂,但路径清晰,可追溯。
- 概念激活向量(TCAV):将人类可理解的概念(如“条纹”、“轮子”)与模型神经元激活关联,解释模型是否真的理解了“斑马”这一概念。
| 技术类型 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| SHAP/LIME | 通用性强,无需修改模型 | 计算成本高,近似可能失真 | 金融风控、结构化数据分析 |
| 注意力可视化 | 直观,原生支持 | 高注意力不等于高重要性 | 文本生成、机器翻译 |
| 内在可解释模型 |
完全透明,推理快 | 精度通常低于黑盒模型 | 资源受限边缘设备、简单分类 |

如何落地可解释性?实操步骤与工具链
对于开发者而言,将可解释性融入工作流需要具体的操作路径,以下是一套标准的实施框架。
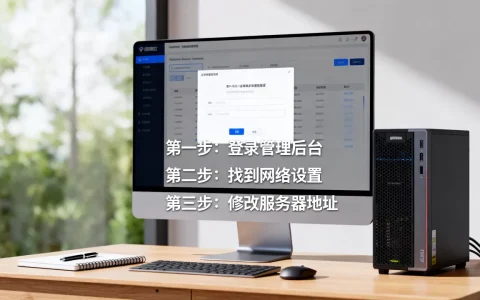
第一步:定义解释粒度与目标
在动手之前,必须明确“向谁解释”以及“解释什么”。
- 面向开发者:需要特征重要性排序、梯度分析,用于调试模型偏差。
- 面向最终用户:需要自然语言摘要、高亮标记,用于建立信任。
- 面向监管者:需要完整的决策日志、公平性指标报告,用于合规审计。
第二步:选择并集成解释工具
推荐使用开源生态中的成熟库,如SHAP、LIME、Captum(PyTorch)或Alibi(TensorFlow)。
- 安装依赖:通过pip安装对应库,确保版本与深度学习框架兼容。
- 加载模型:加载训练好的大模型权重。
- 生成解释:输入测试样本,调用解释器生成特征贡献度或注意力权重。
- 可视化输出:使用Matplotlib或Dash等工具绘制力导向图、热力图或条形图。
第三步:验证解释的稳定性与真实性
解释结果必须可靠,常用的验证方法包括:
- 扰动测试:轻微修改输入特征,观察解释是否发生剧烈变化,稳定的解释更可信。
- 人工评估:邀请领域专家判断解释是否符合业务逻辑,在贷款审批中,如果模型将“居住地”作为主要负面因素,专家应能识别出这是否构成歧视。
未来趋势:从“事后解释”走向“因果推理”
当前的可解释性技术大多停留在相关性层面,即指出哪些特征与结果相关,但无法证明因果关系,2026年后的研究热点正转向因果可解释性(Causal Interpretability)。

因果干预与反事实解释
未来的模型将能够回答“…会怎样”的问题,模型不仅能指出“申请人收入低导致拒贷”,还能生成反事实解释:“如果申请人收入增加20%,贷款将被批准”,这种解释更具行动指导意义,帮助用户理解如何改变结果。
自然语言解释生成
随着多模态大模型的发展,解释形式将从图表转向自然语言,模型将自动生成类似这样的解释:“我判断这张图片是猫,因为识别到了尖耳朵、胡须和条纹图案,这些特征与训练数据中的猫类样本高度匹配。”这种拟人化的解释方式将极大降低用户理解门槛。
常见问题解答
大模型的可解释性Interpretability与模型精度如何平衡?
通常存在权衡关系,高精度模型往往更复杂、更不透明,但在实际应用中,可以通过“知识蒸馏”技术,将大模型的复杂决策逻辑压缩到小模型中,小模型既保持了较高精度,又具备更好的可解释性,对于核心业务,可采用“黑盒模型预测+白盒模型校验”的双轨制,用可解释模型监控黑盒模型的异常输出。
企业如何评估大模型的可解释性Interpretability效果?
评估应结合定量指标和定性反馈,定量方面,可测量解释的稳定性(Stability)和忠实度(Fidelity),即解释是否准确反映了模型的真实行为,定性方面,需进行用户满意度调查,询问领域专家是否认为解释内容有助于其决策,据工信部数据,多数成功落地的AI项目都将专家对解释内容的认可度作为核心验收指标。
小公司预算有限,如何低成本实现可解释性Interpretability?
不必从头开发复杂算法,建议优先使用开源工具如SHAP和LIME,它们对主流框架支持良好,对于文本数据,直接利用Transformer自带的注意力权重进行可视化,无需额外训练,可借助云厂商提供的AI治理平台,这些平台通常内置了基础的可解释性模块,按使用量付费,降低了初期投入成本。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/404138.html

评论列表(1条)
笑死,2026年了还谈“可解释性”?——我司去年那个信贷模型,输出“拒绝理由:风控阈值”直接把客户气笑,懂的都懂,阈值是