面对海量数据,分库分表不是“要不要做”的选择题,而是“何时做、怎么做”的必答题,核心在于平衡读写性能与系统复杂度。
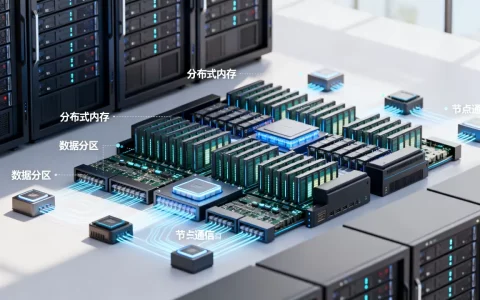
当业务量级突破单机数据库瓶颈,传统的单库架构开始显露疲态,连接数激增、锁竞争加剧、备份恢复时间过长,这些问题像定时炸弹一样潜伏在生产环境中,业内专家指出,随着数据量的指数级增长,单一数据库实例的物理极限已成为制约业务发展的最大阻碍,引入分库分表策略,将数据分散存储到多个物理节点,成为提升系统吞吐量和可用性的关键手段,但这并非银弹,它引入了分布式事务、跨库查询、数据迁移等复杂问题,制定科学的策略,比盲目追求技术先进性更为重要。

分库分表的核心场景与判断标准
并非所有系统都需要分库分表,过早优化是万恶之源,过度设计则是资源浪费,我们需要明确哪些场景真正需要这种重型武器。
何时触发分库分表?
以下指标达到阈值时,应重新评估架构:
- 单表数据量超过500万至1000万行:此时索引效率显著下降,全表扫描成本急剧上升。
- 单库QPS持续超过2000:CPU使用率长期高于70%,且通过垂直拆分无法缓解。
- 存储容量接近磁盘上限:例如单库数据量超过2TB,导致备份窗口过长,影响业务连续性。
对比:垂直拆分 vs 水平拆分
在决定方案前,需厘清两种拆分维度的区别:
垂直拆分(按业务模块)
将不同业务表拆分到不同数据库,将用户表、订单表、商品表分别存入三个库,优点是隔离性强,故障域小;缺点是关联查询依然困难,且无法解决单表数据量过大的问题。
水平拆分(按数据行)
将同一张表的数据分散到多个库或表中,将订单表按用户ID哈希,分散到10个库中,优点是彻底解决单表数据量瓶颈;缺点是跨库JOIN查询复杂,事务一致性难以保证。

多数情况下,建议先进行垂直拆分,待单表数据量达到瓶颈时,再对热点表进行水平拆分。
主流分片策略与算法选择
分片键(Sharding Key)的选择是策略的核心,它决定了数据分布的均匀性和查询效率。
常见分片算法对比
- 取模哈希(Modulo Hash):根据分片键取余数定位库/表,优点是分布均匀;缺点是扩容时需重新迁移大部分数据,运维成本极高。
- 一致性哈希(Consistent Hashing):通过虚拟节点映射,扩容时仅迁移少量数据,优点是扩容友好;缺点是节点少时分布不均,实现复杂。
- 范围分片(Range Partitioning):按ID范围或时间范围划分,优点是范围查询高效;缺点是热点数据易倾斜,导致“数据热点”问题。
如何选择适合的分片键?
选择分片键需遵循“高内聚、低耦合”原则。
- 查询频率最高:确保80%以上的查询能直接定位到分片,避免广播查询。
- 数据分布均匀:避免某些分片数据量过大,形成“数据倾斜”。
- 业务关联性:如电商场景,以`user_id`为分片键,可将同一用户的所有订单集中在同一库,便于后续查询。
- 柔性事务方案:采用TCC(Try-Confirm-Cancel)或Saga模式,通过补偿机制保证数据最终一致。
- 消息队列解耦:利用RocketMQ或Kafka的事务消息,确保本地操作与下游更新的一致性。
- 最大努力通知:对于非强一致性场景,通过重试机制确保最终成功。
- 数据冗余:在订单表中冗余用户姓名、手机号等信息,避免JOIN用户表。
- 异步同步:通过Canal监听MySQL Binlog,将关联数据同步到ES或Redis,供查询使用。
- 应用层组装:先查询主表ID,再批量查询关联表数据,在代码层组装结果。
- 雪花算法(Snowflake):生成时间有序的全局唯一ID,性能高,无中心节点依赖。
- 数据库号段模式:批量获取ID段,减少数据库访问频率,适合对ID有序性有要求的场景。
- ZooKeeper/Redis生成:通过中心节点生成,实现简单,但存在单点故障风险。
- 老库双写:应用层同时写入老库和新库,新库作为备用。
- 历史数据迁移:后台任务将老库历史数据分批迁移至新库,确保数据一致。
- 校验与切换:比对新老库数据,确认无误后,将读流量切换至新库。
- 停止双写:确认新库稳定运行后,关闭双写逻辑,下线老库。
- 分片维度监控:监控每个分片的CPU、内存、连接数,及时发现热点分片。
- 慢查询分析:重点监控跨库查询和全表扫描SQL,及时优化索引或重构查询逻辑。
- 数据一致性校验:定期运行校验任务,发现数据不一致及时修复。
若业务查询模式复杂,无法单一分片键满足,可考虑“双写”或“冗余字段”策略,但这会增加存储成本和一致性维护难度。
实施中的关键挑战与解决方案
分库分表后,系统复杂度呈指数级上升,以下是三大核心挑战及应对策略。
分布式事务一致性
跨库操作不再支持本地ACID事务,业内共识认为,最终一致性是分布式系统的常态。

跨库查询与JOIN难题
分布式环境下,JOIN操作性能极差,应避免跨库JOIN。
解决方案
全局ID生成
分库后,自增ID不再全局唯一,需采用分布式ID生成策略。
平滑迁移与运维最佳实践
线上系统不能停机,数据迁移必须平滑。
双写迁移方案
这是业界标准的平滑迁移路径:
监控与告警

分库分表后,监控粒度需细化。
常见疑问解答
分库分表后如何支持模糊查询?
分库分表后,LIKE ‘%keyword%’无法路由到特定分片,会导致全库扫描,解决方案包括:1. 避免使用模糊查询,改用精确匹配;2. 将数据同步至Elasticsearch,利用其倒排索引支持全文检索;3. 在应用层先获取ID列表,再分批查询,但这仅适用于小数据量场景。
分库分表对数据库选型有影响吗?
有影响,MySQL是主流选择,因其生态成熟、社区支持好,对于写密集型场景,可考虑TiDB等分布式数据库,其原生支持水平扩展,无需应用层改造,对于读多写少场景,结合Redis缓存可有效缓解压力,据工信部数据,国内头部互联网公司普遍采用MySQL配合中间件的模式,兼顾性能与可控性。
分库分表后,数据扩容是否困难?
相比传统架构,分库分表扩容确实更复杂,但并非不可行,关键在于前期设计,若采用一致性哈希或预留足够分片空间,可大幅降低扩容难度,若前期未预留空间,需使用ShardingSphere等中间件进行在线重平衡,虽然耗时较长,但可实现不停机扩容。
分库分表是应对数据增长的有力武器,但绝非万能药,它要求开发团队在架构设计、代码实现、运维监控各环节保持高度协同,只有在明确业务痛点、选择合适策略、做好平滑迁移的前提下,才能发挥其最大价值,架构演进应服务于业务,而非为了技术而技术。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/440042.html