Hadoop存储的核心原理是利用分布式文件系统HDFS,将大文件切分为固定大小的Block,并采用多副本机制存储在不同节点上,从而在廉价硬件上实现高容错、高吞吐的海量数据存储。
HDFS架构与数据块切分机制
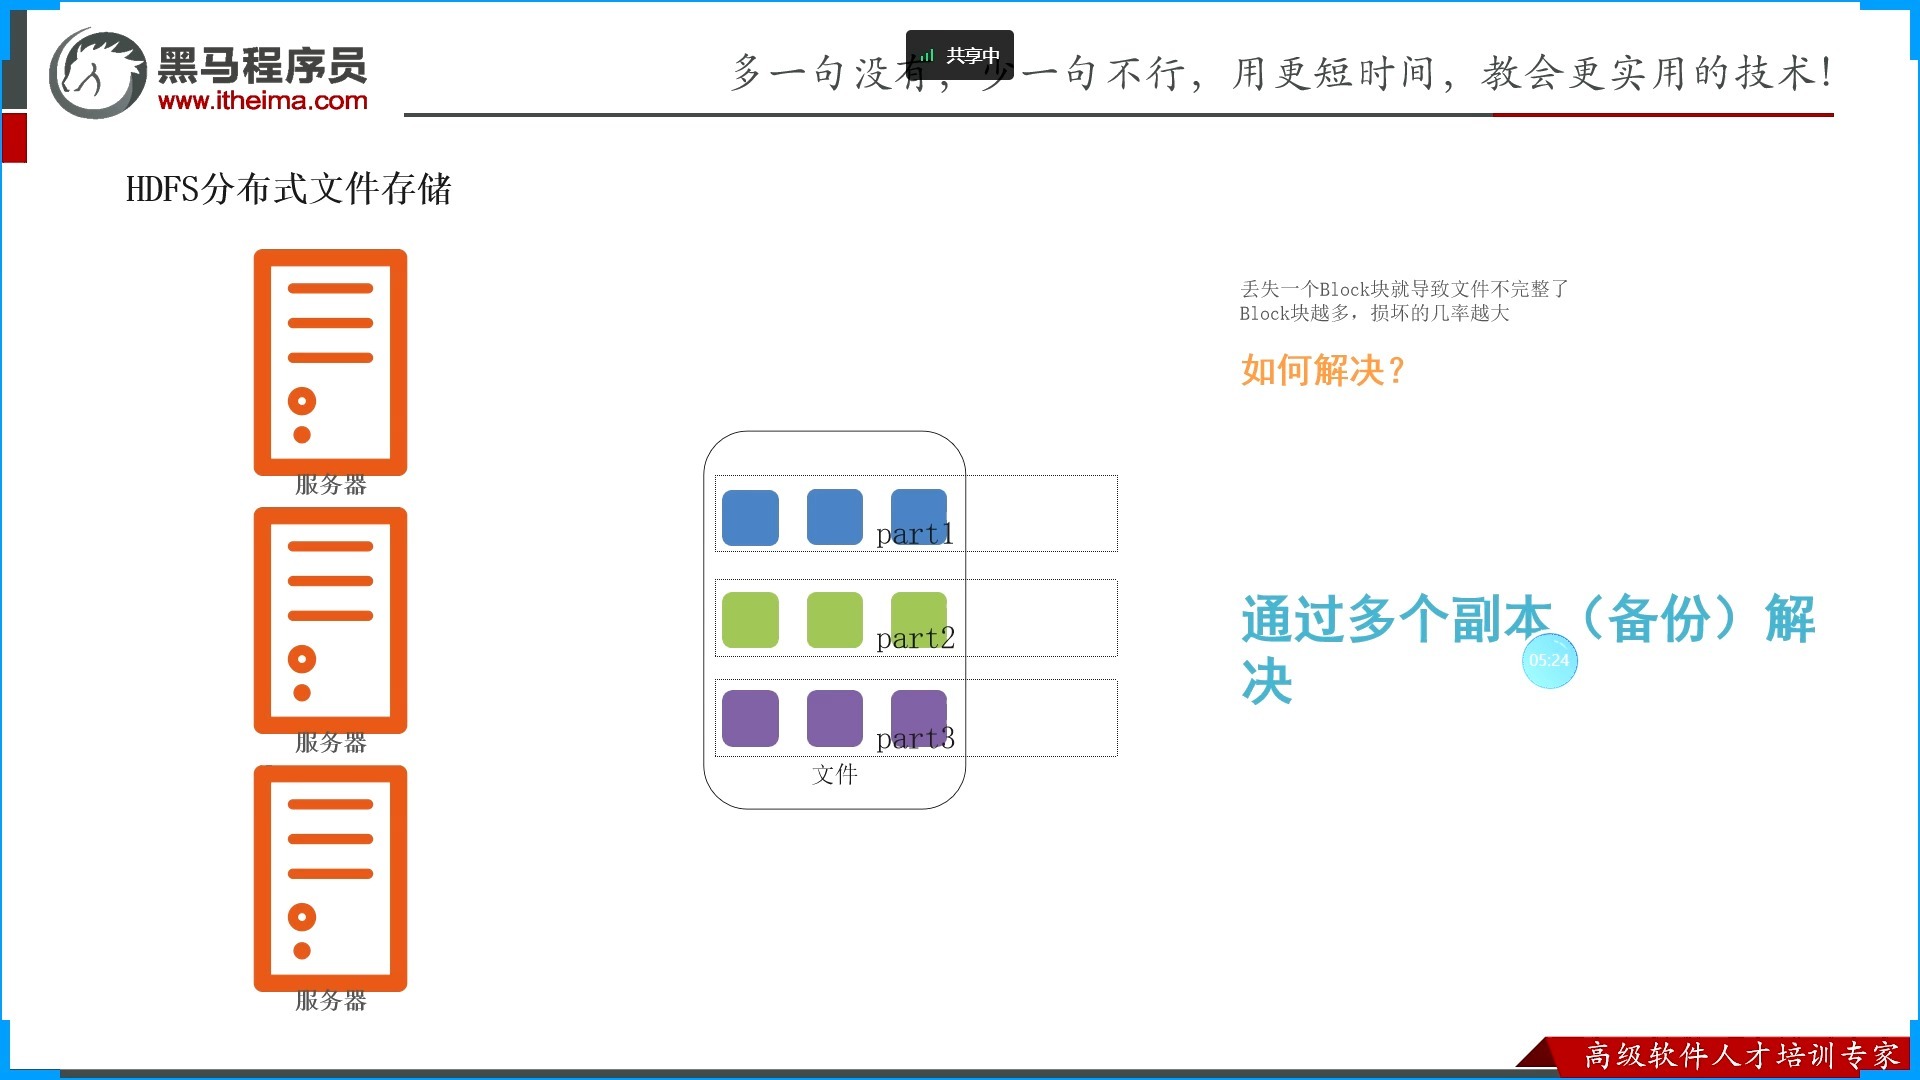
在海量数据处理场景中,单机存储早已触及物理瓶颈,Hadoop分布式文件系统(HDFS)通过“分而治之”的策略解决了这一难题,它并不把整个文件看作一个整体,而是将其切割成更小的单元。

Block大小设定的逻辑
HDFS中最小的存储单元被称为Block,默认情况下,Hadoop 3.x版本的Block大小被设定为128MB,这个数字并非随意设定,而是经过深思熟虑的工程妥协。
业内专家指出,Block大小的选择需要在“寻址时间”和“传输时间”之间找到平衡点,如果Block太小,元数据管理开销会急剧增加,NameNode内存压力巨大;如果Block太大,数据移动的时间可能超过磁盘寻址时间,导致效率低下,128MB这个数值,使得在常规磁盘转速下,读取一个Block所需的时间远大于磁盘寻址时间,从而最大化了磁盘吞吐率。
具体切分过程演示
当用户上传一个1GB的文件时,HDFS并不会将其作为一个整体存储,系统会自动将其切分为8个128MB的Block和1个剩余大小的Block,每个Block独立存储,互不干扰,这种设计使得Hadoop能够并行处理数据,多个DataNode同时读取不同Block,极大提升了I/O效率。
多副本策略与容错机制
在分布式环境中,硬件故障是常态而非例外,Hadoop通过“多副本”机制来对抗硬件失效,确保数据永不丢失。
副本放置策略
默认情况下,每个Block会有3个副本

,但这3个副本并非随机放置,而是遵循严格的拓扑结构,以平衡数据安全性与读写性能。
- 第一个副本:存储在上传客户端所在的节点上(如果客户端在集群内),这利用了本地存储的高带宽,加速第一次写入。
- 第二个副本:存储在同一个机架(Rack)内的另一个节点上,这保证了即使某个节点故障,数据仍在同一机架内,便于快速恢复。
- 第三个副本:存储在不同机架的节点上,这是为了应对机架级故障(如交换机断电、机房火灾)。
这种“一本地、同机架、跨机架”的策略,既保证了数据的高可用性,又优化了网络带宽的使用,据统计,这种策略能有效应对大多数常见的硬件故障场景。
心跳机制与数据恢复
DataNode(数据节点)会定期向NameNode(名称节点)发送心跳包,报告自身状态和已存储的Block列表,如果NameNode在一段时间内未收到某个DataNode的心跳,会判定该节点失效。
系统会自动触发数据恢复流程:
- NameNode标记失效节点上的副本为“不可用”。
- 检查该Block的其他副本数量是否满足要求。
- 如果副本数少于3个,NameNode会从健康的副本中复制数据,重新构建3个副本,分布到其他健康节点上。
这个过程对用户通常是透明的,业务系统无需感知底层的故障与恢复。
读写流程与性能优化
理解Hadoop的读写流程,有助于在实际操作中优化数据访问效率。
写入流程详解
写入数据时,客户端首先与NameNode通信,请求创建文件,NameNode检查权限和文件是否存在,若通过,则返回可用的DataNode列表。

客户端随后与第一个DataNode建立管道(Pipeline),数据被分成Packet(数据包,默认64KB)进行传输。
- 客户端将Packet发送给第一个DataNode。
- 第一个DataNode接收后,同时转发给第二个DataNode。
- 第二个DataNode接收后,转发给第三个DataNode。
- 第三个DataNode确认接收后,层层向上返回ACK(确认信号)。
- NameNode收到所有副本写入成功的消息,文件创建完成。
这种流水线式的写入方式,充分利用了网络带宽,避免了多次往返通信带来的延迟。
读取流程优化
读取数据时,客户端同样先联系NameNode获取文件元数据,得到Block的位置信息。
- 就近原则:客户端会选择距离自己最近的DataNode进行读取,如果客户端在集群内,则读取本地副本;如果在集群外,则读取延迟最低的副本。
- 校验和检查:每个Block在写入时都会生成校验和(Checksum),读取时,客户端会重新计算校验和并与存储的校验和对比,确保数据完整性。
常见问题与实操建议
hadoop存储原理与nas对比优势在哪
许多企业在构建数据仓库时,常在HDFS与NAS(网络附属存储)之间犹豫,NAS适合小文件频繁读写和共享,但扩展性差,成本高,HDFS则专为大文件、高吞吐设计,通过横向扩展(Scale-out)降低成本,对于PB级日志分析、离线数仓场景,HDFS的性价比远高于传统SAN或NAS架构。
hadoop存储原理在实际应用中如何优化
在实际生产环境中,优化存储性能至关重要:
- 小文件治理:避免上传大量KB级小文件,它们会占用NameNode大量内存,建议使用HAR(Hadoop Archive)或SequenceFile将小文件合并。
- 副本数调整:对于非关键性临时数据,可将副本数降至1或2,节省存储空间;对于核心交易数据,保持3副本甚至更高。
- 机架感知配置:确保集群拓扑配置正确,避免所有副本集中在同一机架,否则机架故障将导致数据不可用。

Hadoop存储原理的本质,是通过软件定义的方式,在不可靠的硬件上构建可靠的大数据存储层,其核心在于Block切分、多副本容错和流水线传输,掌握这些原理,不仅能帮助技术人员排查故障,更能指导企业根据业务场景选择合适的存储策略,实现成本与性能的最佳平衡。
hadoop存储原理常见问题解答
hadoop存储原理中block大小可以修改吗
可以修改,在hdfs-site.xml配置文件中,通过修改dfs.block.size参数即可,但需注意,修改后新建的文件会采用新大小,已存在的文件Block大小不变,通常不建议频繁修改,因为涉及集群整体性能调优。
hadoop存储原理如何实现高可用性
主要通过NameNode高可用(HA)和多副本机制实现,HA模式部署两个NameNode,一个Active,一个Standby,通过Zookeeper实现故障自动切换,配合DataNode的多副本策略,即使NameNode或DataNode发生故障,数据和服务仍可继续运行。
hadoop存储原理适合处理多大规模的数据
Hadoop适用于TB至PB级别的海量数据存储,对于GB以下的小数据量,传统数据库或文件系统更为高效,随着云原生技术的发展,Hadoop生态已扩展至EB级集群,成为大数据基础设施的主流选择。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/441108.html