在Hive中建立数据库表的核心步骤是先创建数据库,再使用CREATE TABLE语句定义字段、分隔符及存储格式,最后通过LOAD DATA或INSERT语句加载数据,整个过程需严格匹配底层HDFS路径与数据编码。参考2
Hive作为大数据生态中的核心数据仓库工具,其本质是将SQL查询转换为MapReduce或Tez任务,很多初学者容易混淆“数据库”与“表”的概念,在Hive语境下,Database更像是一个命名空间或文件夹容器,而Table则是实际存储数据的逻辑结构,理解这一层级关系,是避免后续数据混乱的关键。
Hive建库建表的标准操作流程
在实际生产环境中,规范的建表流程能显著降低后期维护成本,业内专家指出,遵循“先库后表、先定义后加载”的原则,可以有效避免元数据冲突。
第一步:创建数据库实例
Hive默认存在一个default数据库,但为了隔离不同业务线的数据,建议为每个项目或部门建立独立的数据库。
基础建库命令
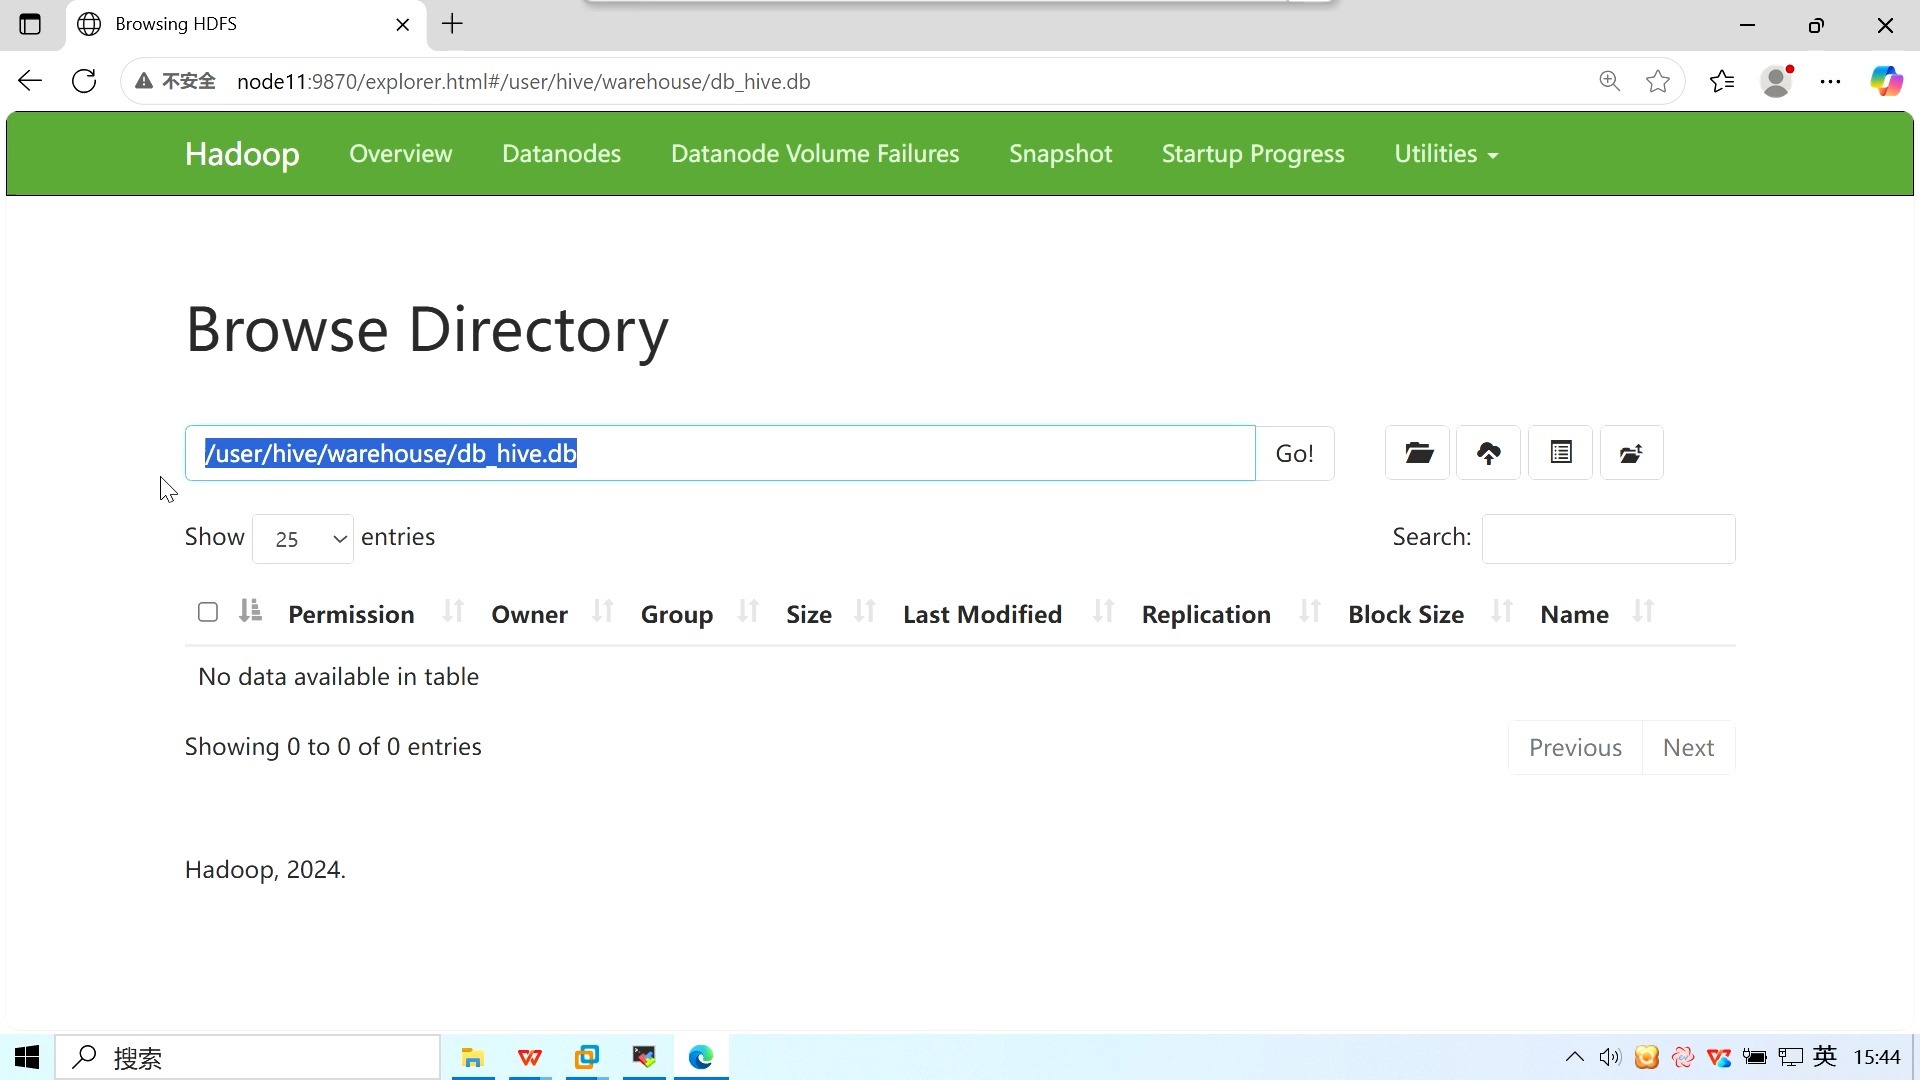
使用以下命令创建一个名为sales_db的数据库,并指定其存储路径,这一步并非必须,但推荐在大型集群中实施,以便通过HDFS权限控制数据访问。
CREATE DATABASE IF NOT EXISTS sales_db
COMMENT 'Sales Data Warehouse Database'
LOCATION '/user/hive/warehouse/sales_db.db';
这里的关键在于LOCATION参数,如果不指定,Hive会将其默认放置在/user/hive/warehouse/目录下,指定独立路径有助于后续通过Hadoop命令直接管理文件权限,或者在迁移数据时快速定位物理文件。参考2
第二步:定义表结构
建表是Hive操作中最复杂也最核心的环节,表结构的定义直接决定了数据如何被解析、存储以及后续查询的效率。
内部表与外部表的选择
在Hive中,表分为内部表(Managed Table)和外部表(External Table),这是一个经典的Hive内部表与外部表区别问题,直接影响了数据删除时的行为。
-

内部表
:Hive完全管理数据,当你执行DROP TABLE时,Hive不仅删除元数据,还会同时删除HDFS上的物理数据文件,适用于临时数据或完全由Hive生命周期管理的数据。 - 外部表:Hive仅管理元数据,执行
DROP TABLE时,仅删除元数据映射,HDFS上的物理文件保留,适用于原始数据层(ODS),防止误删导致数据丢失。

具体建表语句解析
假设我们要建立一张用户行为日志表user_behavior,语句如下:
CREATE EXTERNAL TABLE IF NOT EXISTS user_behavior (
    user_id STRING,
    item_id STRING,
    behavior_type STRING,
    ts BIGINT
)
PARTITIONED BY (dt STRING)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY 't'
LINES TERMINATED BY 'n'
STORED AS TEXTFILE
LOCATION '/user/hive/warehouse/user_behavior';
在这个语句中,有几个关键参数需要特别注意:
- ROW FORMAT DELIMITED:指定字段分隔符,这里使用制表符
t,这是CSV或TSV文件的标准分隔方式,如果数据源是JSON,则需要使用SERDE(序列化/反序列化)库,如org.openx.data.jsonserde.JsonSerDe。 - PARTITIONED BY:分区字段
dt(日期),分区是Hive优化查询性能的重要手段,通过指定分区,查询时可以跳过无关目录,大幅减少扫描数据量。 - STORED AS:指定存储格式。
TEXTFILE是默认格式,可读性强但占用空间大、压缩效率低,对于大规模数据,建议改为PARQUET或ORC格式,它们支持列式存储,能显著提升聚合查询速度并节省存储空间。
数据加载与验证技巧
建好表后,数据如何进入Hive是另一个痛点,常见的误区是直接复制文件到HDFS而不更新Hive元数据,这会导致“有数据无表”或“有表无数据”的尴尬局面。
本地数据加载
当数据文件位于Hive服务器本地磁盘时,使用LOAD DATA LOCAL INPATH

命令。
LOAD DATA LOCAL INPATH '/home/data/behavior.log'
OVERWRITE INTO TABLE user_behavior
PARTITION (dt='2026-05-20');
注意OVERWRITE关键字,它会清空目标分区现有的数据,如果希望追加数据,请去掉该关键字。PARTITION (dt='2026-05-20')指定了数据所属的分区,如果表未分区,则无需此步骤。
HDFS数据加载
如果数据已经在HDFS上,使用LOAD DATA INPATH。
LOAD DATA INPATH '/input/behavior/2026-05-20.log'
OVERWRITE INTO TABLE user_behavior
PARTITION (dt='2026-05-20');
此操作本质上是HDFS的文件移动(Move),速度极快,因为它不涉及数据复制,仅修改元数据指针。
验证数据完整性
加载完成后,务必进行验证,执行SELECT COUNT() FROM user_behavior WHERE dt='2026-05-20';,如果返回行数与源文件行数一致,则加载成功,若行数不符,检查源文件是否包含空行或格式错误。
常见坑点与优化建议
在实际操作中,Hive建表字段类型选择不当会导致严重的性能问题或数据截断。
字段类型选择
- STRING vs VARCHAR:Hive早期版本不支持VARCHAR,推荐使用STRING,虽然STRING占用空间略大,但兼容性最好。
- TIMESTAMP vs BIGINT:对于时间戳,建议使用BIGINT存储毫秒级时间戳,而非TIMESTAMP类型,TIMESTAMP在跨时区处理上较为复杂,且在某些旧版本Hive中支持不佳,BIGINT更灵活,便于后续转换为具体日期。
- NULL值处理:Hive中NULL值在排序时会被视为最小值(ASC)或最大值(DESC),这与MySQL等关系型数据库不同,在编写查询时需注意此差异。
小文件问题
频繁的数据加载会产生大量小文件,导致NameNode压力过大,Map任务启动开销增加,据统计,当小文件数量超过阈值时,查询性能会急剧下降,建议通过set hive.merge.mapfiles=true;和

set hive.merge.mapredfiles=true;开启合并功能,或在数据加载后使用CONCATENATE命令合并分区文件。
分区裁剪与动态分区
静态分区虽然简单,但维护成本高,动态分区允许Hive根据数据内容自动创建分区。
SET hive.exec.dynamic.partition=true;
SET hive.exec.dynamic.partition.mode=nonstrict;
INSERT OVERWRITE TABLE user_behavior PARTITION (dt)SELECT user_id, item_id, behavior_type, ts, dtFROM temp_behavior_data;
使用动态分区时,务必将分区字段放在SELECT列表的最后,否则可能报错,设置nonstrict模式允许所有分区都是动态的,这在处理海量历史数据迁移时非常有用。
Hive库建立数据库表常见问题解答
如何修改已存在Hive表的存储格式?
Hive不支持直接修改表的存储格式,正确做法是创建一张新表,指定新的存储格式(如ORC),然后将旧表数据插入新表。
CREATE TABLE user_behavior_orc LIKE user_behavior
STORED AS ORC;
INSERT INTO TABLE user_behavior_orcSELECT  FROM user_behavior;
DROP TABLE user_behavior;ALTER TABLE user_behavior_orc RENAME TO user_behavior;
此过程会触发全表扫描和写入,耗时较长,建议在业务低峰期执行。
Hive建表时分区字段能否作为普通字段查询?
可以,分区字段在Hive表结构中既是分区键,也是普通列,你可以在SELECT语句中直接查询dt字段,也可以在WHERE子句中过滤,但需注意,如果分区字段未包含在SELECT列表中,Hive可能不会将其加载到内存,具体取决于查询优化器的行为。
如何处理Hive表中的特殊字符分隔符?
如果数据文件中包含自定义分隔符(如或^),需在ROW FORMAT DELIMITED中指定FIELDS TERMINATED BY,若分隔符是控制字符(如ASCII 1),可使用01表示,对于复杂嵌套数据,建议使用JSON或Avro格式,并配置相应的SerDe库,以避免解析错误。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/445466.html