开发深度学习模型的核心在于将业务问题转化为数据驱动的工程流程,关键在于理解数据质量、模型架构选择与迭代优化的闭环关系,而非单纯追求算法复杂度。
很多人误以为深度学习是黑魔法,只要跑通代码就能出结果,它更像是一门精密的手艺,你需要像工匠一样打磨数据,像建筑师一样搭建结构,像教练一样调整参数,2026年的开发环境已经高度自动化,但底层逻辑并未改变:数据决定上限,模型逼近上限,工程决定落地。
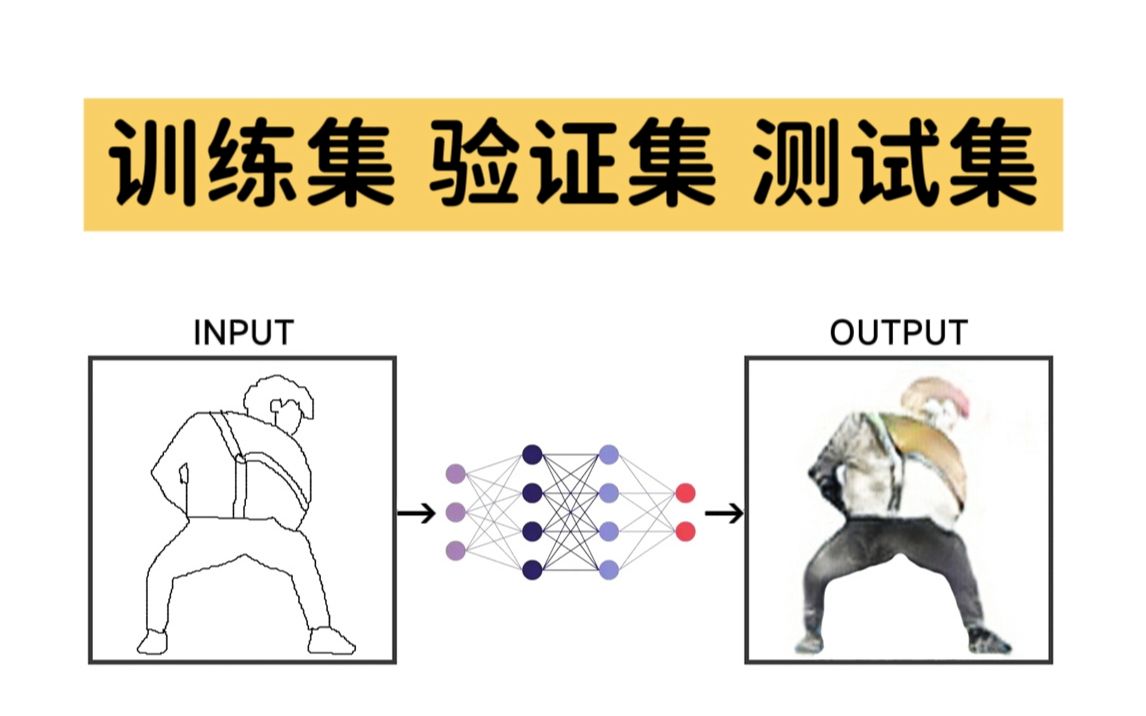
从业务场景到数据准备:地基打得牢,房子才稳
在动手写代码之前,必须先明确你要解决什么问题,是识别图片中的缺陷,还是预测下个月的销量?不同的场景决定了完全不同的数据形态,业内专家指出,80%的项目失败源于数据质量问题,而非算法错误。
数据清洗与标注的实操路径
原始数据往往充满噪音,你需要执行具体的清洗步骤,而不是直接丢进模型。
处理缺失值与异常值
不要简单删除缺失行,这会导致样本偏差,对于数值型数据,可以使用均值或中位数填充;对于分类数据,可以新增一个“未知”类别,异常值需要结合业务逻辑判断,比如销售额突然激增是促销导致的真实数据,还是系统故障产生的脏数据?
标注一致性检查
如果是监督学习,标注质量至关重要,建议采用多人独立标注后交叉验证的方式,当两个标注员意见不一致时,由资深专家进行仲裁,这种机制能显著降低标签噪声,提升模型泛化能力。
数据增强:让小样本拥有大视野
当数据量不足时,数据增强是性价比最高的手段,对于图像数据,随机旋转、裁剪、色彩抖动是基础操作;对于文本数据,同义词替换、回译是常用技巧。
- 图像增强:使用OpenCV或Albumentations库,批量生成增强样本。
- 文本增强:利用预训练语言模型生成语义相近的变体。
- 音频增强:添加背景噪声、改变语速或音调,模拟真实环境。
这些操作不仅能扩充数据集,还能强制模型学习更鲁棒的特征,避免过拟合。
模型架构选择:没有最好的,只有最合适的

面对Transformer、CNN、RNN等无数架构,开发者常陷入选择困难症,2026年的趋势是:预训练大模型微调成为主流,从头训练小众模型仅用于特定边缘场景。
如何评估不同架构的优劣
选择模型时,需权衡精度、速度、资源消耗三个维度。
| 架构类型 | 适用场景 | 训练难度 | 推理速度 | 资源需求 |
|---|---|---|---|---|
| CNN (卷积神经网络) | 图像分类、目标检测 | 中等 | 快 | 中等 |
| Transformer | 自然语言处理、多模态 | 高 | 慢 (训练期) | 高 (GPU/TPU) |
| RNN/LSTM | 时间序列预测 (逐渐被Transformer取代) | 中等 | 中等 | 低 |
| GNN (图神经网络) | 社交网络、推荐系统 | 高 | 慢 | 高 |
对于大多数企业级应用,直接使用Hugging Face或ModelScope上的预训练模型进行微调,是效率最高的路径,你不需要从头学习如何构建Attention机制,只需关注如何适配你的特定数据分布。
迁移学习的实战技巧
微调并非简单替换输出层,关键步骤包括:
- 冻结底层权重:在初期训练阶段,冻结预训练模型的大部分层,只训练顶层分类器,这能防止灾难性遗忘,并节省算力。
- 学习率衰减:微调时的学习率应远小于从头训练,通常设置为1e-4或更低。
- 分层学习率:对底层使用更小的学习率,对顶层使用较大的学习率,以保留通用特征的同时快速适配新任务。

训练与优化:在过拟合与欠拟合间走钢丝
模型训练过程是一场博弈,你需要监控损失函数(Loss)和准确率(Accuracy)的变化曲线,判断模型是否健康。
监控指标与调试策略
不要只看最终准确率,要关注训练集和验证集的损失差值。
- 欠拟合:训练集和验证集损失都高,解决方法:增加模型复杂度、增加训练轮数、减少正则化。
- 过拟合:训练集损失低,验证集损失高,解决方法:增加数据增强、使用Dropout、增加L2正则化、早停法(Early Stopping)。
早停法的具体操作
设置一个耐心值(Patience),例如10,如果验证集损失在10个Epoch内没有改善,则停止训练,并回滚到最佳权重,这能有效防止模型在验证集上过拟合,同时节省计算资源。
超参数调优的科学方法
网格搜索(Grid Search)效率低下,贝叶斯优化(Bayesian Optimization)或随机搜索是更优选择,重点调优以下参数:
- 学习率:最敏感的参数,建议使用学习率调度器(Learning Rate Scheduler)。
- Batch Size:较小的Batch Size有助于泛化,较大的Batch Size训练更快。
- 权重衰减(Weight Decay):相当于L2正则化,防止权重过大。
模型部署与持续迭代:从实验室到生产线
模型在笔记本上跑通只是第一步,部署到生产环境才是价值实现的开始,2026年的部署环境强调轻量化和实时性。
模型压缩与加速
为了在边缘设备或高并发场景下运行,模型必须瘦身。
- 量化(Quantization):将FP32精度转换为INT8,体积缩小4倍,速度提升2-3倍,精度损失通常在1%以内。
- 剪枝(Pruning):移除网络中不重要的神经元或连接,进一步减小模型体积。
- 知识蒸馏(Knowledge Distillation):用一个大模型(教师)指导一个小模型(学生)训练,小模型能继承大模型的部分能力。
部署工具链选择
- 云端推理:使用TensorRT、ONNX Runtime加速推理。
-

边缘部署
:使用TFLite、CoreML适配移动端或嵌入式设备。 - 容器化:使用Docker封装模型和服务,确保环境一致性,便于Kubernetes编排。

监控与反馈闭环
模型上线后,性能会随时间衰减(Data Drift),必须建立监控体系:
- 数据漂移检测:监控输入数据的分布变化,一旦显著偏离训练分布,触发重新训练。
- 预测置信度监控:记录低置信度预测的比例,这些样本往往是模型盲区,需优先人工复核。
- A/B测试:新模型上线前,先对小部分流量进行A/B测试,对比业务指标(如转化率、点击率),确保新模型确实带来提升。
常见问题解答:白话ai 看懂深度学习_开发深度学习模型
开发深度学习模型需要多少数据量?
数据量需求因任务复杂度而异,对于简单的图像分类,几千张标注图片可能足够;但对于复杂的自然语言理解或自动驾驶场景,可能需要数百万甚至数十亿条数据,近年来,随着自监督学习技术的发展,利用未标注数据进行预训练,再用少量标注数据进行微调,已成为降低数据依赖的主流方案,多数情况下,数据质量比数量更重要,干净、一致的标注能显著提升模型效果。
深度学习模型开发周期通常多长?
开发周期没有固定标准,取决于项目规模和团队经验,一个原型验证(PoC)通常在2-4周内完成,包括数据探索、基线模型搭建和初步评估,从原型到生产级部署,往往需要3-6个月甚至更久,主要时间花费在数据清洗、模型调优、性能优化和系统集成上,行业共识认为,前期充分的数据准备和清晰的业务定义,能大幅缩短后期调试时间。
小白如何入门深度学习模型开发?
建议从Python编程基础入手,掌握NumPy、Pandas等数据处理库,随后学习PyTorch或TensorFlow框架,通过MNIST手写数字识别、CIFAR-10图像分类等经典案例熟悉流程,参与Kaggle等平台的竞赛,阅读开源代码,理解模型架构和训练技巧,不必深究数学推导,先跑通代码,再逐步深入原理,据工信部及相关教育机构数据,掌握基础框架和具备工程化思维,是初学者快速进入行业的关键门槛。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/452698.html