


分布式大数据的核心价值在于通过横向扩展集群节点,以较低成本实现海量数据的实时处理与存储,彻底解决单机性能瓶颈,是当前企业构建数据中台和智能决策系统的基石。
想象一下,如果一家大型电商平台每天产生数十亿条用户浏览记录,传统的单机数据库就像一辆小轿车,哪怕加满油也跑不动这么重的货,而分布式大数据系统则是一列由无数节车厢组成的超级高铁,每节车厢(节点)只负责搬运一部分货物,但整体运力却是惊人的,这种架构不仅解决了存储容量的问题,更通过并行计算将处理速度提升了数个数量级。
分布式架构如何打破单机性能瓶颈
在单机时代,提升性能主要依赖垂直扩展,即购买更昂贵的服务器,摩尔定律逐渐失效,硬件升级带来的边际效益递减明显,分布式架构引入了水平扩展的概念,通过增加节点数量来线性提升系统能力。
数据分片与并行计算机制
分布式系统的核心逻辑是将大数据集拆分成小块,分发到不同节点并行处理,以Hadoop HDFS为例,文件会被切分成默认128MB或256MB的数据块,分散存储在不同机架的节点上。
- 数据冗余策略:每个数据块通常会有3个副本,分别存储在本地机架、相邻机架和跨机架节点,确保即使部分硬件故障,数据依然可用。
- MapReduce计算模型:将任务分解为Map(映射)和Reduce(归约)两个阶段,Map阶段并行处理数据,Reduce阶段汇总结果,这种模式特别适合日志分析、词频统计等批处理场景。
- 容错性设计:当某个节点失效时,系统会自动将任务调度到其他健康节点,用户几乎无感知。
存储与计算分离的趋势
早期的分布式架构往往存储与计算耦合,导致资源利用率不均,现代云原生大数据架构倾向于存储与计算分离。
对象存储与弹性计算
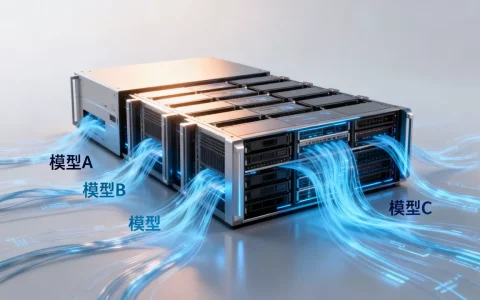
利用S3或OSS等对象存储作为底层数据湖,上层连接Spark、Flink等计算引擎,这种架构允许用户根据业务高峰低谷动态调整计算资源,无需预先购买大量闲置硬件,据工信部相关数据显示,采用存算分离架构的企业,其IT基础设施成本平均降低了30%以上。

实时流处理与离线批处理的融合
业务场景对数据时效性的要求越来越高,从T+1的天级报表发展到秒级甚至毫秒级的实时监控,传统的批处理系统无法满足这一需求,流批一体架构应运而生。
Lambda与Kappa架构对比
业内专家指出,在实时数据处理领域,Lambda架构曾占据主导地位,但因其维护两套代码(批处理和流处理)的复杂性,逐渐被Kappa架构取代。
| 架构类型 | 核心特点 | 适用场景 | 维护成本 |
|---|---|---|---|
| Lambda | 批处理层+速度层+服务层 | 对历史数据回溯要求极高 | 高(需维护两套逻辑) |
| Kappa | 仅保留速度层,通过重放日志回溯 | 实时性要求高,历史回溯需求少 | 低(统一逻辑) |
主流引擎选型指南
对于企业而言,选择合适的引擎至关重要,Spark因其内存计算特性,在复杂ETL和机器学习场景中表现优异;Flink则凭借原生流处理特性,在金融风控、实时大屏等低延迟场景中大放异彩。
- Spark优势:生态丰富,支持SQL、MLlib、GraphX等多种API,适合复杂的数据清洗和转换任务。
- Flink优势:低延迟、高吞吐,支持精确一次(Exactly-Once)语义,适合对数据一致性要求极高的金融场景。
- 选型建议:若业务以离线分析为主,优先选择Spark;若需实时响应且逻辑复杂,Flink是更佳选择。

企业落地分布式大数据的常见陷阱
许多企业在引入分布式大数据技术时,往往陷入“为了技术而技术”的误区,导致项目失败或资源浪费。
数据孤岛与标准缺失
分布式系统本身能解决技术问题,但无法解决管理问题,如果企业内部各业务系统数据标准不一,即使搭建了大数据平台,也只能得到一堆“垃圾数据”。
- 统一数据模型:建立企业级数据仓库模型,明确事实表、维度表定义。
- 数据治理先行:在数据入湖前进行清洗、去重和标准化,确保数据质量。
- 元数据管理:建立完整的数据血缘图谱,方便追踪数据来源和问题定位。
资源调度与成本失控
分布式集群一旦规模扩大,资源调度变得极其复杂,缺乏有效的监控和限流机制,容易导致“大马拉小车”或资源争抢。
优化策略
- 队列管理:根据业务优先级划分YARN或K8s队列,保障核心业务资源。
- 小文件合并:定期合并HDFS或OSS中的小文件,减少NameNode压力。
- 冷热数据分离:将近期活跃数据放在高性能存储,历史归档数据移至低成本存储。
2026年大数据技术演进方向
随着AI大模型的爆发,大数据技术正迎来新的变革,数据不再仅仅是报表的原料,而是训练智能体的燃料。
Data+AI深度融合
传统大数据平台正在向Data+AI一体化平台演进,向量数据库成为标配,支持非结构化数据的高效检索。
- RAG架构普及:检索增强生成技术成为企业知识库构建的主流方案,依赖大数据平台提供实时、准确的知识切片。
- 智能数据治理:利用AI自动识别数据异常、推荐索引策略,降低运维门槛。
Serverless化与云原生

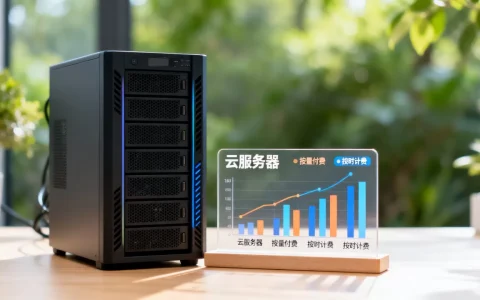
企业将更少关注底层集群维护,转而使用Serverless化的大数据服务,按需付费、自动扩缩容成为标配。
操作路径示例
对于初创企业,建议直接从云厂商购买托管的大数据服务(如阿里云MaxCompute、酷番云CDW)。
- 注册云账号:开通大数据计算服务。
- 数据上传:通过DataWorks或类似ETL工具将本地数据同步至云端。
- 编写SQL:使用标准SQL进行数据分析,无需关心集群配置。
- 可视化展示:连接BI工具,生成实时报表。
分布式大数据常见问题解答
分布式大数据系统适合中小型企业吗?
中小型企业通常数据量未达到TB级,自建分布式集群性价比极低,建议采用云原生SaaS服务或轻量级开源方案(如ClickHouse单机版),只有当数据量持续增长且对实时性有强需求时,才考虑迁移至分布式架构。
如何评估大数据项目的ROI?
评估ROI需从直接收益和间接收益两方面考量,直接收益包括通过精准营销提升的转化率、通过供应链优化降低的库存成本;间接收益包括决策效率提升、合规风险降低,数据治理完善的企业,其大数据项目回报周期在12-18个月左右。
分布式大数据与数据仓库的区别是什么?
数据仓库(Data Warehouse)侧重于结构化数据的存储和分析,强调一致性、准确性和历史追溯,通常用于BI报表,分布式大数据平台(Data Lake)侧重于多源异构数据(包括日志、图片、视频)的存储和处理,强调灵活性和扩展性,现代架构常采用Lakehouse模式,融合两者优势。
选择Hadoop还是Spark?
Hadoop是底层基础设施,提供HDFS存储和YARN调度,Spark是上层计算引擎,运行在YARN之上,二者并非替代关系,而是互补关系,Spark可以读取HDFS数据进行处理,极大提升计算速度,若仅涉及简单存储,HDFS即可;若涉及复杂计算,必须搭配Spark或Flink。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/459990.html



评论列表(1条)
讲真啦~以前我们公司用单机MySQL,订单一多就卡成PPT,最后硬是拆成12个节点的Hadoop集群,虽然搭起来头大,但