Python处理不平衡数据最有效的过采样方法是SMOTE及其变体,实操中需根据数据特征选择策略并配合交叉验证,才能避免过拟合并提升模型泛化能力。
Python过采样方法对比:SMOTE、ADASYN与随机过采样
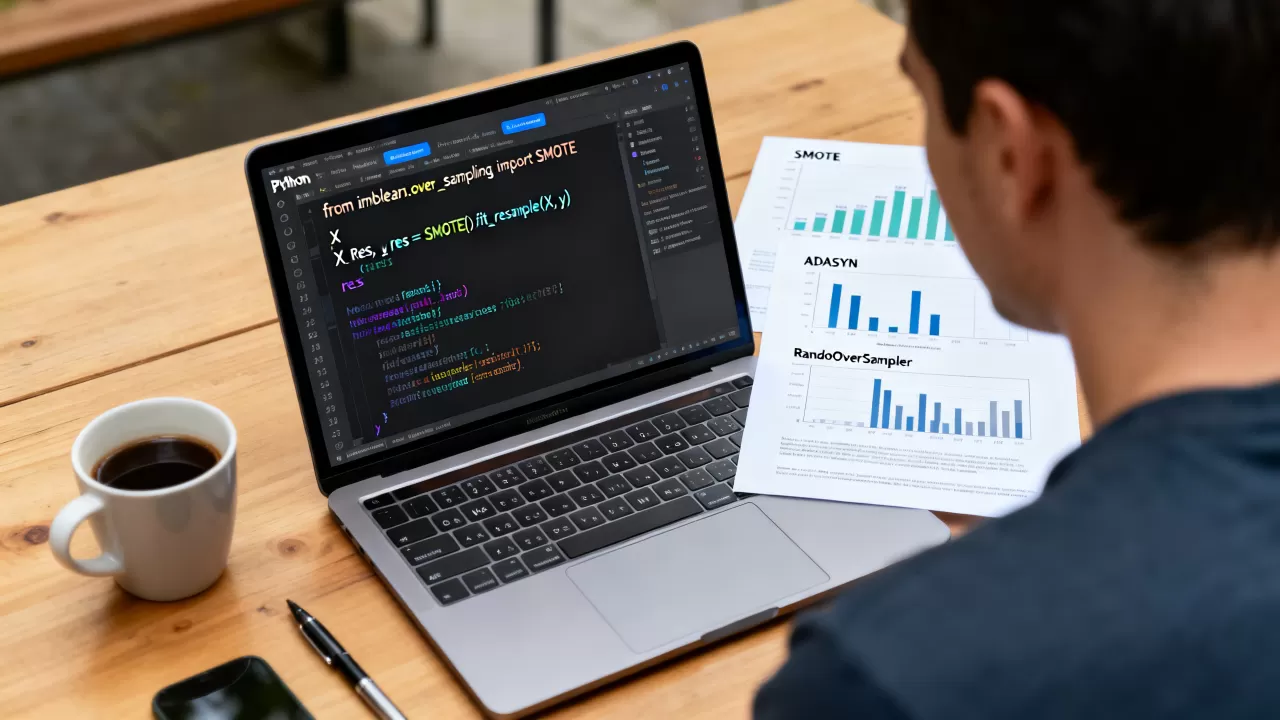
过采样通过增加少数类样本数量来平衡数据分布,Python中主流实现包括随机过采样、SMOTE(合成少数类过采样技术)和ADASYN(自适应合成采样),行业共识认为,SMOTE在大多数表格数据中表现稳定,但高维数据需谨慎;ADASYN则更关注边界样本,对噪声敏感。
三种方法的核心差异
随机过采样直接复制少数类样本,简单但容易导致过拟合,模型记忆重复样本,泛化能力下降,SMOTE在少数类样本之间插值生成新样本,保留数据分布特征,但可能产生重叠样本,ADASYN根据样本密度分布自适应生成不同数量,更侧重边界区域,但会放大噪声。
| 方法 | 生成策略 | 适用场景 | 常见风险 |
|---|---|---|---|
| 随机过采样 | 随机复制 | 小规模数据,快速验证 | 过拟合严重 |
| SMOTE | K近邻插值 | 表格数据,类间距离适中 | 高维下效果差 |
| ADASYN | 密度自适应 | 边界样本重要时 | 噪声放大 |
如何选择合适方法
数据维度是首要考量,当特征数超过100时,SMOTE的K近邻计算容易失效,业内专家指出此时优先考虑SMOTE变体如Borderline-SMOTE或使用降维后过采样。
样本数量也很关键,若少数类少于10个,SMOTE的插值会极度依赖少数邻居,生成样本缺乏多样性,随机过采样反而更可控。
任务需求决定策略,对信用卡欺诈检测这类边界样本重要的任务,ADASYN能帮助模型关注难以区分的样本;对医疗诊断这类类别清晰但数据量少的任务,SMOTE配合Tomek Links去噪更稳妥。
Python不平衡数据过采样代码实战
环境准备与库导入
使用imbalanced-learn库,它基于scikit-learn接口,支持SMOTE、ADASYN等,安装命令:pip install imbalanced-learn,导入常用模块:
from imblearn.over_sampling import SMOTE, ADASYN, RandomOverSampler
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
核心代码与参数设置
基本流程:创建采样器对象,调用fit_resample生成平衡数据,示例:
X, y = make_classification(n_classes=2, weights=[0.9, 0.1], random_state=42)
smote = SMOTE(sampling_strategy='auto', random_state=42, k_neighbors=5)
X_res, y_res = smote.fit_resample(X, y)
关键参数:sampling_strategy控制采样比例,'auto'表示平衡到多数类;可设为5使少数类达到多数类一半。k_neighbors决定插值邻居数,默认5,小样本类可降至3,避免使用噪声邻居。random_state固定结果便于复现。
进阶用法
:在流水线中集成过采样,避免数据泄露,使用Pipeline:
from imblearn.pipeline import Pipeline
from sklearn.ensemble import RandomForestClassifier
pipeline = Pipeline([
    ('over', SMOTE()),
    ('clf', RandomForestClassifier())
])
pipeline.fit(X_train, y_train)
参数调优与验证策略
过采样必须在训练集内进行,不能对验证集或测试集操作,使用StratifiedKFold交叉验证,确保每折分布一致,据scikit-learn官方文档建议,过采样后应使用严谨的评估指标,如精确率-召回率曲线、F1分数,而非准确率。
参数调优时,可结合GridSearchCV对k_neighbors和sampling_strategy进行搜索,但需注意过采样会增加训练时间,大网格搜索可能导致过拟合。
Python过采样后模型评估与常见陷阱
过采样导致过拟合的识别与应对
过采样后模型在测试集上表现差,通常是因为训练集包含过多重复或合成样本。缓解方法:使用集成过采样与欠采样(如SMOTEENN),或使用更严格的验证策略,如多层交叉验证,另一个常见陷阱是评估指标选择不当,准确率在极度不平衡数据下虚高,应使用混淆矩阵、PR曲线和AUC。
数据泄露:过采样在交叉验证中的位置
错误操作:先对整个数据集过采样,再划分训练集和测试集,这会导致测试集包含过采样生成的样本,模型评估结果虚假偏高。正确做法:过采样作为预处理步骤,放在交叉验证内部,仅对训练折进行,使用
imblearn.pipeline可以自动保证这一点。
高维数据的过采样挑战
当特征数远大于样本数,SMOTE的欧氏距离计算变得不稳定,所有样本几乎等距,行业共识认为,此时先降维(如PCA)再过采样,或使用基于类中心的过采样方法(如SVMSMOTE)更有效,文本数据常用词袋表示,特征稀疏,不宜直接插值,可考虑生成对抗网络(GAN)过采样,但复杂度高。
Python oversample常见问题解答
过采样后模型过拟合怎么办?
优先检查是否在训练集外对测试集使用过采样,确保数据泄露未发生,若仍过拟合,可降低k_neighbors值减少生成样本多样性,或结合欠采样(如SMOTEENN)删除噪声合成样本,使用更简单的模型(如逻辑回归配合正则化)也能减轻过拟合。
SMOTE的k_neighbors参数如何选择?
默认值5在多数情况下可用,若少数类样本数量少于10,建议降至3或2,避免使用远处样本导致插值不可靠,若数据分布稀疏,增加至7-10可能生成更合理样本,可通过网格搜索结合F1分数调优,但需注意搜索范围不宜过大,一般2-8之间。
过采样对深度学习模型有效吗?
对中小规模深度学习任务有效,但需注意训练策略,过采样后数据量增大,需调整batch size和epoch数,防止欠拟合,在图像分类中,SMOTE对原始像素插值意义不大,更适合在特征空间或嵌入层过采样,近年来研究表明,对深度模型,过采样与数据增强(如图像旋转、裁剪)结合使用效果更佳。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/505834.html