服务器监控指标是保障业务稳定运行的生命线,核心指标包括CPU使用率、内存占用、磁盘I/O、网络流量和响应时间,缺一不可。任何一个指标出现异常,都可能导致服务中断或用户体验下降,本文从实操角度出发,拆解这些指标的意义、获取方式以及在不同场景下的选型策略,帮你快速建立一套有效的监控体系。
服务器监控指标有哪些?核心指标详解
CPU使用率:服务器性能的晴雨表
CPU使用率直接反映处理器忙碌程度,多数情况下,持续高于80%说明负载过高,需要排查进程或扩容,但要注意,iowait(等待I/O的CPU时间)过高时,CPU看似空闲,实际磁盘已成瓶颈,行业共识认为,CPU使用率应结合iowait一起看,不能只看单一数值。
内存占用:避免OOM的关键
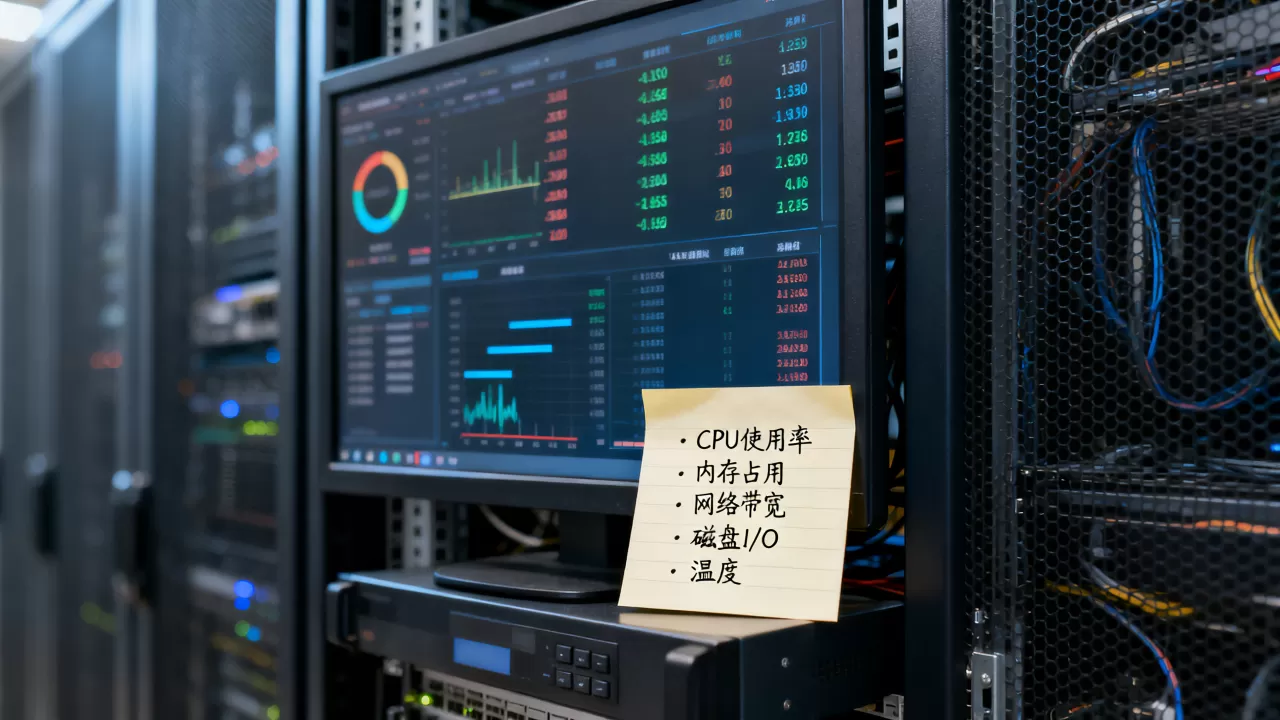
内存不足会触发OOM Killer,随机杀掉进程,造成服务中断,监控时除了总使用量,还要关注可用内存和Swap使用率,Swap过高说明物理内存吃紧,应及时扩容或优化内存泄漏的应用,建议对JVM、Python等进程设置单独的内存监控,防止内存泄漏长期积累。
磁盘I/O与空间:数据持久化的基石
磁盘空间接近90%时,系统可能无法写入日志,甚至导致数据库崩溃,I/O指标重点关注await(平均I/O等待时间)和%util(磁盘利用率),对于数据库服务器,磁盘I/O延迟超过10ms就需要关注,可以使用iostat -x 1获取实时数据。
网络流量:带宽与延迟的平衡
网络监控包括带宽使用率、丢包率和TCP连接数,带宽打满会导致请求超时,连接数过多可能遭遇DDoS或连接泄漏,建议监控SYN_RECV和TIME_WAIT状态数量,快速定位网络问题。
响应时间与错误率:用户体验的直接反馈
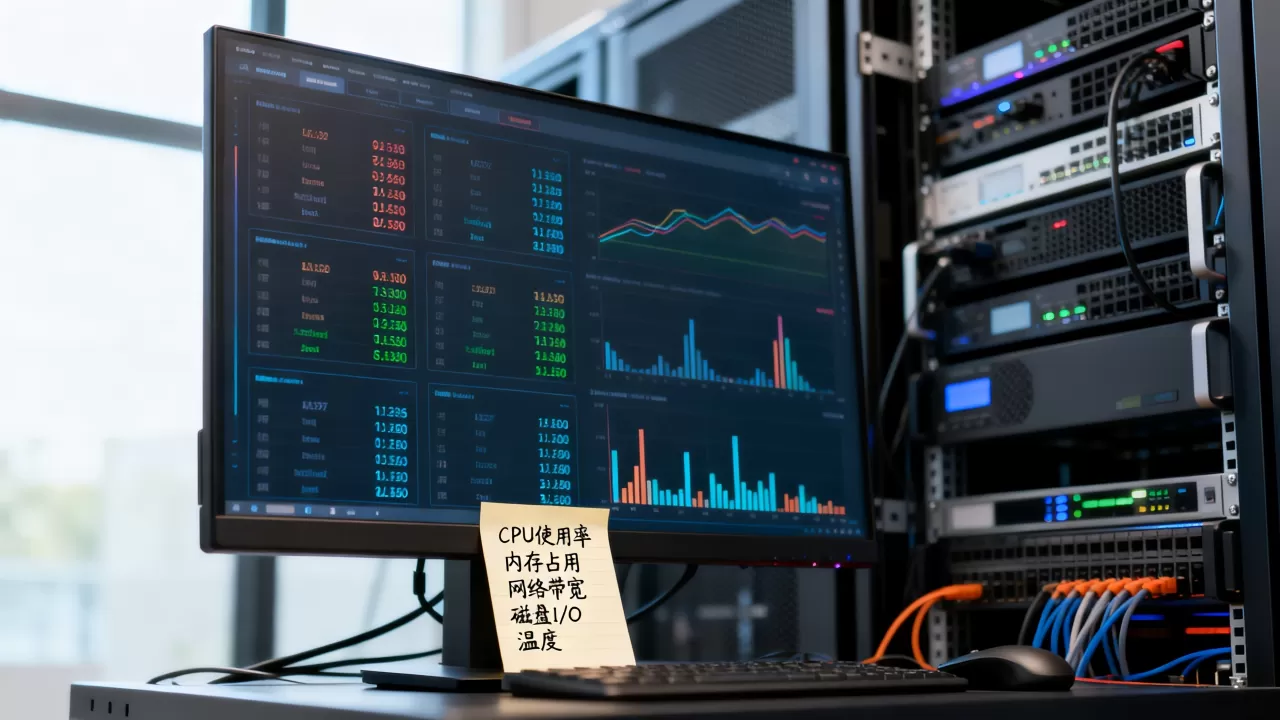
这是面向业务的指标,例如API响应时间超过200ms就需优化,错误率超过1%应立刻告警,这类指标通常通过APM工具或业务日志统计,能直接反映用户感受。
如何选择服务器监控指标?场景化定制方案
高并发Web场景
重点监控CPU使用率、网络带宽和请求队列长度,Web服务器瓶颈常在CPU和网络,内存相对次要,建议配合每秒请求数(QPS)和平均响应时间一起看,当QPS上升时,响应时间不应明显增加。
数据库服务器场景
磁盘I/O延迟和内存使用率是关键,MySQL的InnoDB buffer pool命中率低于95%时,应增加内存,同时监控慢查询数,超过5秒的SQL需优化,数据库服务器不建议使用Swap,应关闭或设置极低阈值。
游戏服务器场景
关注网络延迟抖动和CPU使用率,游戏场景对实时性要求高,丢包率超过1%就可能影响体验,建议使用UDP监控和帧率指标,同时监控在线玩家数与服务器负载的关联。
视频处理场景
CPU使用率和磁盘I/O是核心,视频编码对CPU消耗巨大,同时频繁读写临时文件,磁盘I/O容易成为瓶颈,建议使用多队列SSD,并监控编码队列长度,避免任务积压。
服务器监控指标工具对比与价格参考
主流监控工具一览
| 工具 | 类型 | 部署难度 | 价格特点 |
|---|---|---|---|
| Prometheus + Grafana | 开源,Pull模式 | 中等 | 免费,需自建维护 |
| Zabbix | 开源,Agent模式 | 中等 | 免费,企业版收费 |
| Nagios |
开源,插件丰富 | 较低 | 免费,但配置较老 |
| 云厂商监控(如云监控、CloudWatch) | 托管服务 | 低 | 按量付费,免费额度有限 |
| Datadog | SaaS | 低 | 按主机付费,较贵 |
价格与场景匹配
- 个人或小团队:开源工具免费,但需要投入时间学习,多数情况下,云厂商自带监控已能满足基本需求,成本可控。
- 中型企业:Prometheus + Grafana是主流选择,社区活跃,扩展性强,若预算充足,Datadog可减少运维团队负担。
- 大型企业:Zabbix在复杂网络环境中更成熟,支持分布式监控,但需注意,工具费用不是全部,人力和维护成本才是大头。
服务器监控指标实操:从部署到告警
Linux服务器基础监控命令
top/htop:实时查看CPU、内存、进程负载。htop支持颜色区分,更直观。iostat -x 1:查看磁盘I/O详情,重点看await和%util。vmstat 1:查看系统整体状态,包括CPU、内存、I/O、进程。netstat -anp | grep :80 | wc -l:统计80端口连接数,快速判断并发压力。df -h:查看磁盘分区使用率,du -sh定位大文件。
搭建Prometheus + Grafana监控栈
- 下载Prometheus二进制文件,修改配置文件,添加需要监控的目标(如服务器节点、数据库)。
- 在被监控机器上安装
node_exporter,暴露系统指标。 - 启动Prometheus,确认Targets状态为UP。
- 安装Grafana,添加Prometheus数据源,导入官方或社区仪表盘(如Node Exporter Full)。
- 设置告警规则:在Prometheus中配置
alertmanager,或直接在Grafana中创建告警通道(邮件、钉钉、企业微信)。
设置告警规则示例
- CPU使用率>80%持续5分钟 ➔ 触发警告,通知运维人员。
- 磁盘使用率>90% ➔ 触发严重告警,要求立即处理。
- 内存可用<500MB ➔ 触发告警,排查进程。
- 网络丢包率>0.5% ➔ 触发告警,检查链路或联系运营商。
注意:告警规则应避免频繁抖动,建议设置持续时间(如1分钟、5分钟)和聚合窗口,减少噪音。
服务器监控指标常见问题
Q1:服务器监控指标有哪些是必须的?
A: 基础系统指标包括CPU使用率、内存占用、磁盘I/O与空间、网络流量,针对业务特性增加响应时间和错误率,如果资源有限,优先监控磁盘I/O和内存使用率,这两个指标最容易导致服务中断。
Q2:服务器监控指标如何降低告警噪音?
A: 设置合理的阈值和持续时间,避免瞬时波动触发告警,例如CPU使用率超过80%持续5分钟再告警,而非1分钟,同时使用关联分析,比如CPU高且I/O高时,才发出告警,避免单一指标误报,定期清理不再使用的告警规则,保持告警有效。
Q3:服务器监控指标数据存储多久合适?
A: 原始数据保留7-15天用于问题排查,聚合数据(如5分钟级、1小时级)保留90天以上用于容量规划,如果存储成本有限,可以降低采样频率,但不可低于每分钟一次,使用Prometheus可以设置存储保留策略,自动清理过期数据。
监控不是目的,保障业务可用才是,抓住核心指标,结合自动化运维,才能让服务器监控真正发挥价值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/513178.html