负载分担机制避免节点被打满,核心不是让所有节点完全平均,而是通过持续健康检查、权重调度和自动摘除,把每个节点的请求量压在日常安全线以下。
负载分担机制和负载均衡有什么区别?先看清“分摊”逻辑
负载均衡像交通警察,主要负责把车流疏导到不同车道,负载分担更像把一车货拆给多个仓库,重点不是排队,而是让每个仓库都有能力接住。

节点被打满,多数情况下不是整体流量大到不可承受,而是某几个节点被算法“偏爱”,或者某个节点自身性能偏弱。
常见调度策略如下:
- 轮询:依次分发,简单但机器性能不同时,容易把弱节点先打满。
- 加权轮询:按性能给不同权重,弱节点少接一点,强节点多接一点。
- 最少连接数:把新请求交给当前连接最少的节点,适合长连接、视频流、WebSocket等场景。
- 一致性哈希:同一用户请求固定到同一节点,缓存命中率高,但热点用户可能把单节点打满。
- 最短响应时间:探测各节点实时延迟,动态选最快节点,多数情况下能绕开已经变慢的节点。
行业共识认为,避免节点被打满的关键不是追求数学平均,而是让调度器拥有“实时感知”能力,调度器只有持续看到每个节点的真实负载,才能把流量从危险节点身边拉开。
服务器负载过高怎么排查?负载分担机制先看这四类信号
节点不会瞬间被打满,它通常先“脸色发白”,再“动作变慢”,最后才“直接躺平”。
四类信号要提前盯住:
- 连接数接近上限:用
ss -s查看 TCP 概况,或用ss -tan state ESTABLISHED | wc -l统计已建立连接数,如果长时间接近ulimit -n限制,说明节点已经在硬扛。 - CPU持续高位:执行
top -bn1 | head -n 5,观察 us 和 sy 是否长时间偏高,单核跑满不一定危险,但多核同时持续高位就要警惕。 - 内存频繁换页:
free -h看 available 是否持续下降,内存不足时,应用会频繁换页,响应变慢,最终拖垮节点。 - 响应时间变长:用
curl -o /dev/null -s -w '%{time_total}n' http://节点IP:端口/health探测健康接口,响应时间突然从几十毫秒涨到几百毫秒,说明节点内部可能已经拥挤。
排查路径可以按这个顺序走:
- 先确认是单个节点还是所有节点,单个节点有问题,优先看配置和硬件;所有节点都有问题,先看入口流量是否暴涨。
- 看调度器健康检查日志,查看是否已有节点被标记为 down。
- 对比被摘除节点的应用错误日志,找应用层原因。
- 若调度算法使用轮询,检查节点权重是否与实际硬件性能严重不匹配。
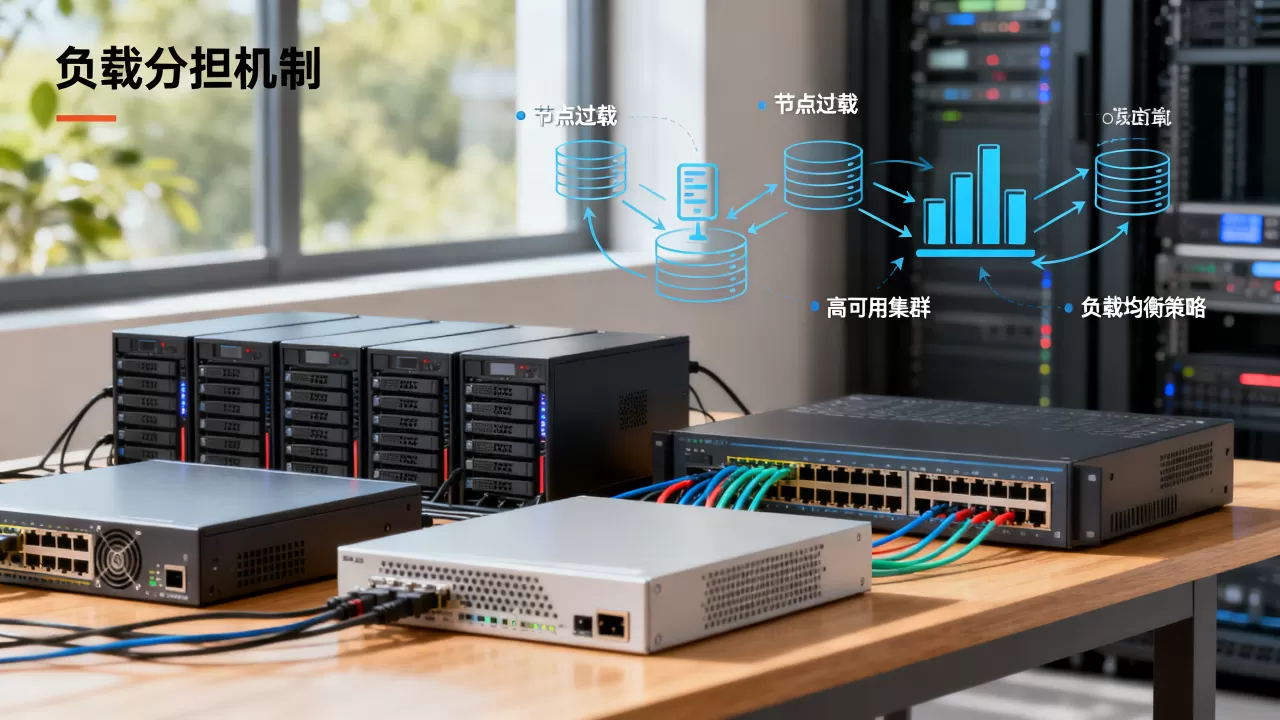
很多节点被打满的起点,并不是流量真的大到无解,而是某台节点的权重被调得太高,或者健康检查间隔太长,没来得及把它摘掉。
多线路负载分担如何设置?几条命令让节点离打满远一点
以 Nginx 为例,负载分担策略集中在上游配置块里,配置文件一般位于 /etc/nginx/conf.d/upstream.conf。
upstream backend_pool {
    least_conn;
    server 10.0.1.10:8080 weight=3 max_fails=2 fail_timeout=30s;
    server 10.0.1.11:8080 weight=1 max_fails=2 fail_timeout=30s;
    server 10.0.1.12:8080 backup;
}
server {
    listen 80;
    location / {
        proxy_pass http://backend_pool;
        proxy_next_upstream error timeout http_502 http_503;
    }
}
每条命令都有明确目的:
least_conn:把新连接分给当前连接数最少的节点,避免长连接把某一台堆满。weight=3:让性能强的节点多承担,但不至于无限制灌入。max_fails=2和fail_timeout=30s:30秒内失败2次,就暂时把节点摘除,已经打满的节点,不会继续收到新请求。backup:其他节点都不健康时才启用,避免备用节点无故闲置。proxy_next_upstream:当响应超时或后端返回5xx时,自动换下一个节点重试。
保存后执行 nginx -t 检查配置,再执行 nginx -s reload 让配置生效。
如果要防止单节点连接数超限,HAProxy 的配置更直接,在 /etc/haproxy/haproxy.cfg 中,给 server 行加上 maxconn 2000:
server web1 10.0.1.10:8080 maxconn 2000 check inter 3s fall 3 rise 2这里 inter 3s fall 3 rise 2 表示每3秒探测一次,连续失败3次摘除,连续成功2次恢复。maxconn 2000 则给节点设了硬上限,连接数碰到这个值就不再分配新连接,避免节点被打满后才被动处理。
北京机房负载分担方案怎么避免单节点过载?地域调度是隐藏变量
北京机房作为北方重要流量入口,晚高峰访问集中,如果只靠单机房内部做负载分担,可能整条链路都压在同一个物理入口上。
地域调度是隐藏变量,它把“内部均摊”升级成“入口分流”。
- DNS分区域解析:在云解析控制台选择“解析设置”,为北京线路单独配置A记录,指向北京机房入口IP;其他线路指向其他机房入口IP,这样北方用户默认走北京,南方用户默认走广州,北京节点不容易被全国流量打满。
- 任播路由:同一IP通过BGP路由到最近机房,不同地域用户天然从不同物理入口进来。
- 跨地域健康检查:北京节点负荷偏高时,把新请求暂时引导到相邻的天津或河北节点,给北京节点留出喘息时间。
操作上,如果使用智能DNS,通常按这个路径配置:
- 进入域名解析控制台。
- 添加两条A记录,分别选择“北京”和“默认”。
- 北京线路记录值填写北京机房的负载分担入口IP。
- 默认线路记录值填写其他地域机房的入口IP。
- 开启DNS健康检查,当北京入口连续探测失败时,自动把部分解析切换到备用入口。
这样,北京机房就不会因为单一地域流量集中而被轻易打满,负载分担从“单机房内循环”变成“多入口外循环”。
负载分担策略配置命令:从权重到健康检查的完整路径
不同负载分担工具,配置路径和命令不同,但思路一致:先设定调度算法,再设定健康检查,最后给节点设上限。
常用算法与场景对比如下:
| 调度算法 | 适用场景 | 避免打满的特点 |
|---|---|---|
| 轮询 | 节点性能相近 | 简单均摊,但性能差异大时容易压垮弱节点 |
| 加权轮询 | 节点性能不同 | 按权重分配,保护弱节点 |
| 最少连接 | 长连接、视频流 | 避开连接堆积节点 |
| 最短响应时间 | 动态波动大 | 实时感知延迟,把流量导给快节点 |
| 一致性哈希 | 缓存命中要求高 | 热点访问可能仍打满单节点,需配合限流 |
在 Nginx 中,动态调整权重后,执行 nginx -s reload 即可生效,在 LVS 中,可以用 ipvsadm -L -n 查看当前分发统计,观察每个节点的连接数是否均衡。
健康检查配置也要落地到具体参数,HAProxy 的完整示例:
backend web_backend
    balance leastconn
    server web1 10.0.1.10:8080 maxconn 2000 slowstart 60s check inter 3s fall 3 rise 2
    server web2 10.0.1.11:8080 maxconn 2000 slowstart 60s check inter 3s fall 3 rise 2
slowstart 60s 的作用是:节点恢复后,用60秒逐渐增加流量,防止瞬间涌入再次把节点打满,这个参数经常被忽视,但对已经“大病初愈”的节点非常关键。
再结合系统层命令,可以形成完整操作闭环:
cat /proc/loadavg:查看1分钟、5分钟、15分钟负载。ss -tan | awk '{print $1}' | sort | uniq -c | sort -rn
:统计连接状态分布。
curl -x 127.0.0.1:8080 http://backend/health:模拟通过调度器访问健康接口,验证转发链路是否正常。
负载分担策略配置的核心,就是把“感知、分流、摘除、恢复”串成一条连续动作,任何一步缺失,节点都可能被打满后才被发现。
节点被打满前,负载分担机制会自动做哪三件事
真正成熟的负载分担机制,不是等节点彻底打满才行动,而是提前介入。
- 主动摘除不健康节点:多次探测失败后,调度器停止向该节点分发新请求,不再雪上加霜,Nginx 靠
max_fails和fail_timeout,HAProxy 靠fall和inter。 - 慢启动恢复:节点刚恢复时,以较低权重重新接收请求,逐步回到正常分担比例,HAProxy 的
slowstart就是干这件事。 - 动态权重衰减:部分高级负载分担设备会根据节点响应时间自动下调权重,响应变慢的节点,分到的流量越来越少,直到恢复后再回升。
这三件事共同构成一个保护环:提前发现、提前摘除、平滑恢复,节点被打满的概率,会大幅降低。
负载分担机制不是万能药,但它把“单点被打满”从一个必然事件,变成可拦截、可转移、可恢复的运维动作,真正避免节点被打满,靠的是调度策略与健康检查持续配合,而不是某一次配置完成后就高枕无忧。
负载分担机制能完全避免节点被打满吗?
不能,突发流量超过所有节点的总容量时,任何分担策略都无法凭空创造资源,负载分担机制能做的是在总容量范围内,避免局部过载和短板效应,并把不健康节点快速摘除,配合限流、熔断和自动扩容,才能进一步降低被打满概率。
节点被打满后负载分担机制如何自动恢复?
当健康检查探测到节点不可用,调度器会将其标记为 down 或备用,节点恢复后,若配置了慢启动,会以较低权重重新接收请求,逐步回到正常分担比例,以 Nginx 为例,max_fails 与 fail_timeout 控制探测窗口,恢复后按原权重继续服务;HAProxy 的 slowstart 可平滑恢复流量,避免恢复节点被瞬时流量再次打满。
负载分担机制和限流有什么区别?
负载分担机制解决的是“多个节点如何分配流量”,限流解决的是“允许进入系统的总流量有多大”,前者把压力分散到多个节点,避免单个节点被打满;后者在入口处拒绝超出容量的请求,避免整个系统被打满,两者常配合使用,负载分担策略根据限流后的请求总量进行二次分配。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/656216.html