西安GPU算力服务器选型,核心不是先比价格,而是先锁定业务场景、显存容量、网络拓扑、电力散热和本地服务能力。 这五项没对齐,后面买什么卡都容易返工,西安本地团队还要看交付周期、机房条件和售后响应。
西安GPU算力服务器选型需要重点考虑什么?先看这五个硬指标
业务场景先定调:训练、微调、推理不是一回事
买GPU服务器最怕“先买卡,再想用途”,训练、微调、推理对硬件的要求差别很大。
- AI训练:看重显存容量、显存带宽、卡间互联,多卡并行时,NVLink、PCIe拓扑、InfiniBand或RoCE网络都会影响效率。
- 模型微调:LoRA、QLoRA等方式能降低显存门槛,但数据吞吐、NVMe存储和CPU预处理不能太弱。
- 大模型推理:看重并发、延迟、批处理能力和量化支持,显存带宽 often 比绝对算力更影响体验。
- 渲染与仿真:更关注专业卡认证、虚拟化支持和驱动稳定性。
实操时,先把需求写成清单:模型参数量、精度、并发数、上下文长度、响应时间、是否多机多卡,然后跑一条命令确认现有环境:
nvidia-smi
nvidia-smi topo -m
lspci | grep -i nvidia
nvidia-smi topo -m 能看卡间互联,如果显示走PCIe而不是NVLink,多卡训练效率可能受影响。
| 场景 | 卡型重点 | 显存倾向 | 网络 | 存储 |
|---|---|---|---|---|
| AI训练 | 高带宽、强互联 | 大 | NVLink/IB | 并行文件系统 |
| 大模型推理 | 带宽、量化、并发 | 中大 | 25G/100G | NVMe |
| 模型微调 | 显存与生态 | 中大 | 25G/IB | NVMe |
| 渲染仿真 | 认证与稳定 | 中等 | 万兆 | NVMe |
西安AI训练GPU服务器多少钱一台?先算清TCO再谈价格
问“西安AI训练GPU服务器多少钱一台”,不能只看整机报价,GPU服务器TCO包括采购价、电费、机柜、带宽、运维、备件和折旧。
- 采购成本:GPU卡占大头,CPU、内存、NVMe、电源、机箱也会拉高总价。
- 电力成本:单卡功耗普遍在数百瓦级,整机可达数千瓦,西安夏季高温,制冷电费不能忽略。
- 托管成本:本地机房机柜、PDU、UPS、带宽按功率和U位计费。
- 运维成本:驱动、CUDA、容器、监控、故障替换都需要人。
- 备件成本:GPU、电源、主板、网卡备件决定故障恢复速度。
预算分配建议:
- 先保GPU和显存,别为了便宜选低显存卡。
- 再保内存和NVMe,训练数据读得慢,GPU会饿着。
- 后保网络,多机训练没有高速网络,扩展性差。
- 最后留出运维和备件预算。
价格跨度较大,从数万元到数十万元不等,租赁适合短期项目、验证期和峰会式算力需求;购买适合长期稳定、数据敏感、利用率高的团队,可以先用nvidia-smi -q -d POWER看功耗,用ipmitool sdr或PDU读数估算电费。
西安GPU服务器和普通服务器有什么区别?别把算力卡当通用服务器用
西安GPU服务器和普通服务器有什么区别?核心区别在供电、散热、PCIe通道、拓扑和软件栈。
- 供电:GPU瞬时功耗高,普通服务器电源容易触发保护。
- 散热:GPU发热集中,普通机箱风道压不住。
- PCIe通道:CPU直连通道不足,GPU会降速运行。
- 拓扑:多卡训练需要NVLink或合理PCIe Switch拓扑。
- 软件栈:CUDA、驱动、cuDNN、框架版本要匹配。
检查PCIe宽度:
lspci -vv | grep -i LnkSta
如果显示Width x8而不是x16,说明插槽或拆分卡限制了带宽,再查NUMA:
numactl --hardware
GPU和CPU跨NUMA节点,数据搬运会变慢,普通服务器插上GPU卡不等于GPU服务器,整机设计必须匹配。
西安大模型推理GPU服务器怎么选?场景决定卡型与并发
西安大模型推理GPU服务器怎么选?先看并发和上下文长度,再看量化方案。
- 低并发、低延迟:优先高主频、显存带宽大的卡。
- 高并发、吞吐优先:多卡并行,配合批处理和KV Cache优化。
- 长上下文:显存占用增长快,需要更大显存或多卡切分。
- 量化推理:INT8、FP8、4bit量化能降低显存门槛,但要测精度损失。
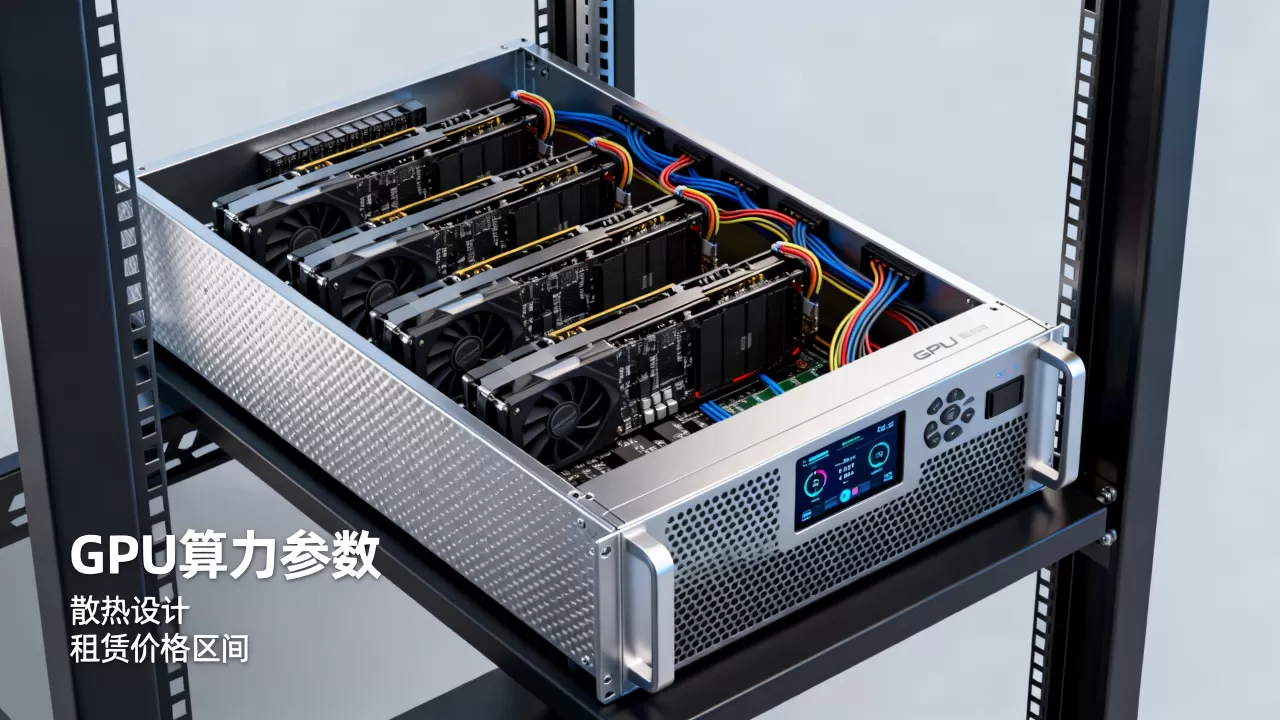
常用推理框架包括vLLM、TensorRT-LLM、TGI,以vLLM为例:
python -m vllm.entrypoints.openai.api_server
  --model /models/Qwen2.5-7B-Instruct
  --tensor-parallel-size 1
  --gpu-memory-utilization 0.9
启动后用nvidia-smi dmon看利用率和显存,如果显存吃满但GPU利用率低,可能是批处理或CPU预处理拖后腿。
显存估算可以用这个思路:显存 ≈ 参数量 × 精度字节数 × 冗余系数,上下文越长、并发越高,冗余系数越大,70B模型在FP16精度下通常需要多卡并行,量化后单机多卡可降低门槛,但并发和上下文长度仍决定最终配置。
西安GPU算力服务器租赁还是购买?地域交付与运维不能忽略
西安GPU算力服务器租赁还是购买,取决于使用周期和数据要求。
| 维度 | 租赁 | 购买 |
|---|---|---|
| 初期投入 | 低 | 高 |
| 弹性 | 强 | 弱 |
| 数据可控 | 视方案 | 高 |
| 长期成本 | 可能更高 | 利用率高时更低 |
| 运维 | 供应商承担较多 | 自建团队 |
| 适合场景 | 短期、验证、峰值 | 长期、稳定、敏感 |
西安本地选型还要看地域交付,高新区、经开区、航天基地等地有数据中心和高校资源,问清楚:GPU备件是否本地、故障响应多久、能否带卡托管、电力扩容是否方便,业内专家指出,本地服务能力往往决定故障恢复时间,异地寄修会拉长停机周期。
网络与存储:别让PCIe和网卡拖后腿
多卡训练和分布式推理,网络是隐形瓶颈。
- 卡间互联:NVLink优于PCIe,PCIe 5.0优于4.0。
- 节点间网络:InfiniBand低延迟,RoCE成本更友好。
- 存储:NVMe RAID适合热数据,并行文件系统适合多机共享。
- 检查命令:
ibstat、ethtool、lsblk、df -h。
如果ibstat显示端口未激活,先查线缆、子网管理器和驱动,存储带宽不足时,GPU利用率会周期性掉底。
电力与散热:西安夏季高温下的硬约束
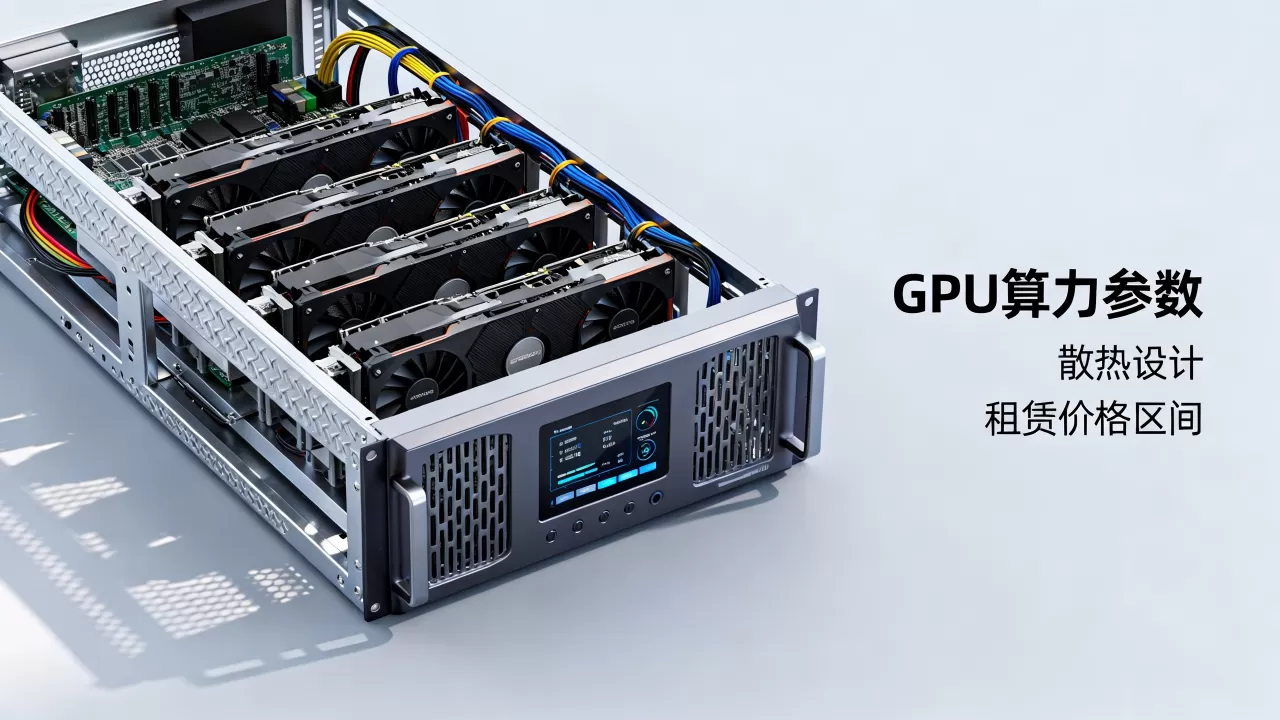
西安夏季高温,风冷机房要重点关注进风温度和机柜功率密度。
- 单机功率数千瓦时,普通机柜可能不够。
- PDU、UPS、制冷量要提前核算。
- 建议留出功率余量,避免满载跳闸。
- 用
ipmitool sensor看温度,用DCGM看GPU温度。
如果机房只有风冷,高功率GPU服务器可能需要更高风量或后门换热,水冷方案散热好,但运维复杂度和漏液风险要评估。
软件生态与运维:CUDA版本、驱动、容器
软件栈不匹配,硬件再强也跑不起来。
nvcc --version
docker run --gpus all nvidia/cuda:12.4.0-base-ubuntu22.04 nvidia-smi
如果容器里看不到GPU,检查NVIDIA Container Toolkit,生产环境建议统一驱动、CUDA、框架版本,用DCGM和Prometheus监控,行业共识认为,GPU服务器选型中显存和互联往往比CPU核数更关键,但CPU、内存、存储也不能成为短板。
供应商选择与本地服务:西安本地交付、备件、SLA
选供应商别只看报价,要问:
- 是否提供整机压力测试,如
gpu-burn、nccl-tests。 - 是否承诺备件库和响应时间。
- 是否支持带卡托管和电力扩容。
- 是否提供驱动、CUDA、容器调优。
测试多卡通信:
./build/all_reduce_perf -b 8 -e 128M -f 2 -g 8
如果带宽不达预期,查拓扑、NCCL版本和网络配置。
西安GPU算力服务器选型常见问题解答
西安GPU算力服务器选型需要重点考虑什么?最核心的三点是什么?
最核心的是场景、显存和网络,场景决定卡型,显存决定能不能跑,网络决定多卡多机效率,电力、散热、运维和本地服务是保障项,缺一项都可能让算力打折。
西安AI训练GPU服务器多少钱一台?预算怎么分配?
价格跨度较大,从数万元到数十万元不等,预算优先给GPU和显存,其次给NVMe、内存和网络,最后留足电力、制冷、备件和运维,短期项目可先租赁验证,长期稳定再考虑购买。
西安大模型推理GPU服务器怎么选?能跑70B模型吗?
70B模型在FP16精度下通常需要多卡并行和较高显存带宽,量化后单机多卡可降低门槛,但并发和上下文长度仍决定最终配置,推理选型先测目标框架的吞吐和延迟,再反推显存、卡数和网络。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/685873.html