服务器硬盘出问题,最直接的办法是看硬盘指示灯和RAID卡报警,再用管理工具定位盘位,坏盘通常一眼就能锁定。
但实际运维中,硬盘损坏可不是每次都亮红灯那么简单,很多时候是无声无息地降级、报错,或者系统日志刷屏但你找不到是哪一块,今天这篇就专门聊聊,n个硬盘坏了到底怎么快速找出来,从物理外观到命令行工具一条龙讲清楚。

怎么从物理层面判断服务器硬盘是否故障
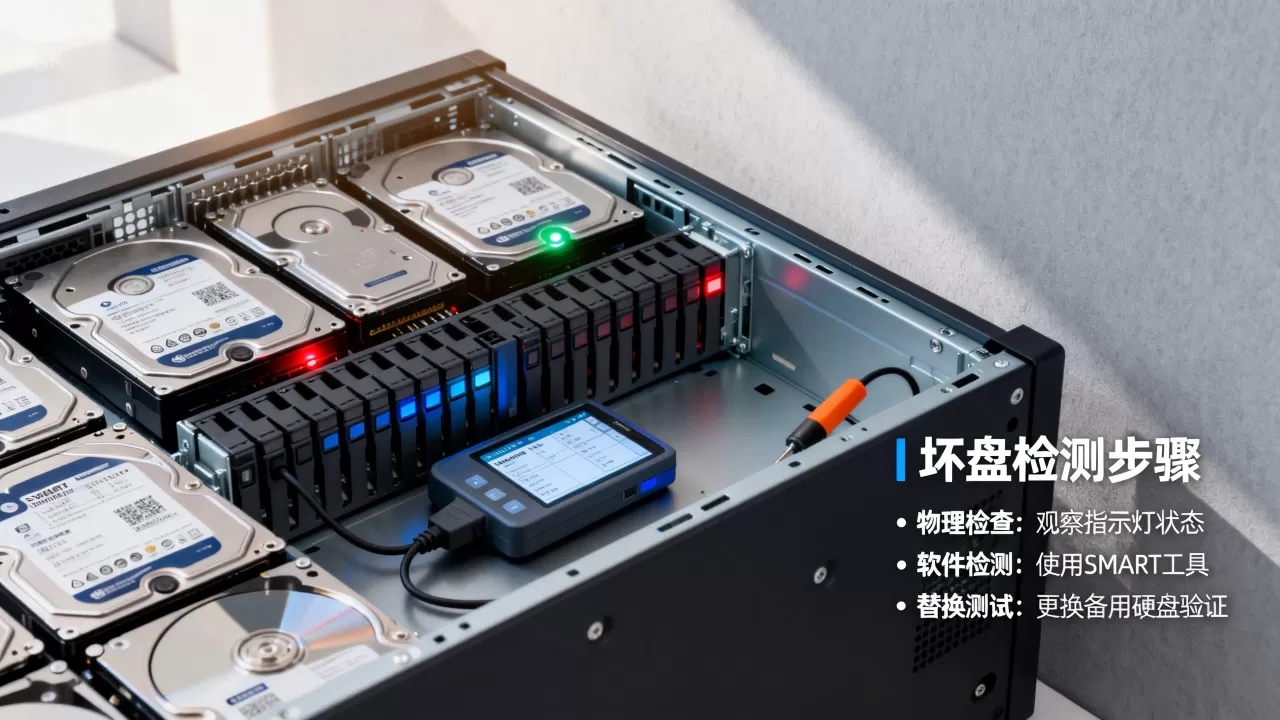
先别急着装软件、看系统,硬盘坏没坏,物理特征往往比任何监控都来得直接,服务器硬盘布局通常分两种:一种在前面板横插,一种在背板竖插,但不管哪种,硬盘本身会“说话”。
看硬盘灯状态:绿灯常亮不代表没坏
很多新手有个误区,以为硬盘灯不闪了才叫坏,业内专家指出,硬盘故障灯主要分三种状态,需要区分开来:
- 绿灯常亮:盘在线、供电正常,但未必健康,如果伴随读写速度骤降,可能盘体有坏道。
- 绿灯闪烁:正在读写,这是正常状态,但如果闪得非常急、持续时间很长,说明硬盘可能卡在I/O上。
- 黄色/红色灯常亮或交替闪烁:这就是明确的故障信号,基本可以判定盘挂了,或者正在重建。
统计下来,多数情况下红灯亮起时,RAID卡已经标记了这块盘为“Fail”状态,数据面临降级风险。
听硬盘自检声音:咔哒声和异响要留意
机械硬盘最明显的物理故障特征就是异响,正常的硬盘启动时会“嘀嘀”两三声自检,然后进入安静读盘状态,如果听到以下声音,就得立刻排查:
- 周期性“咔哒、咔哒”:很可能是磁头在反复寻道失败,俗称“敲盘”。
- 连续“嗡嗡”声加剧:电机轴承磨损,转速不稳。
- 完全没有声音:盘体完全断电,电机没转,控制电路大概率挂了。
固态硬盘没声音,但可以通过温度判断,用红外测温枪扫一下背板,温度明显高于其他盘位的SSD,大概率快要掉盘了。
观察RAID卡报警:面板上有蜂鸣器在响
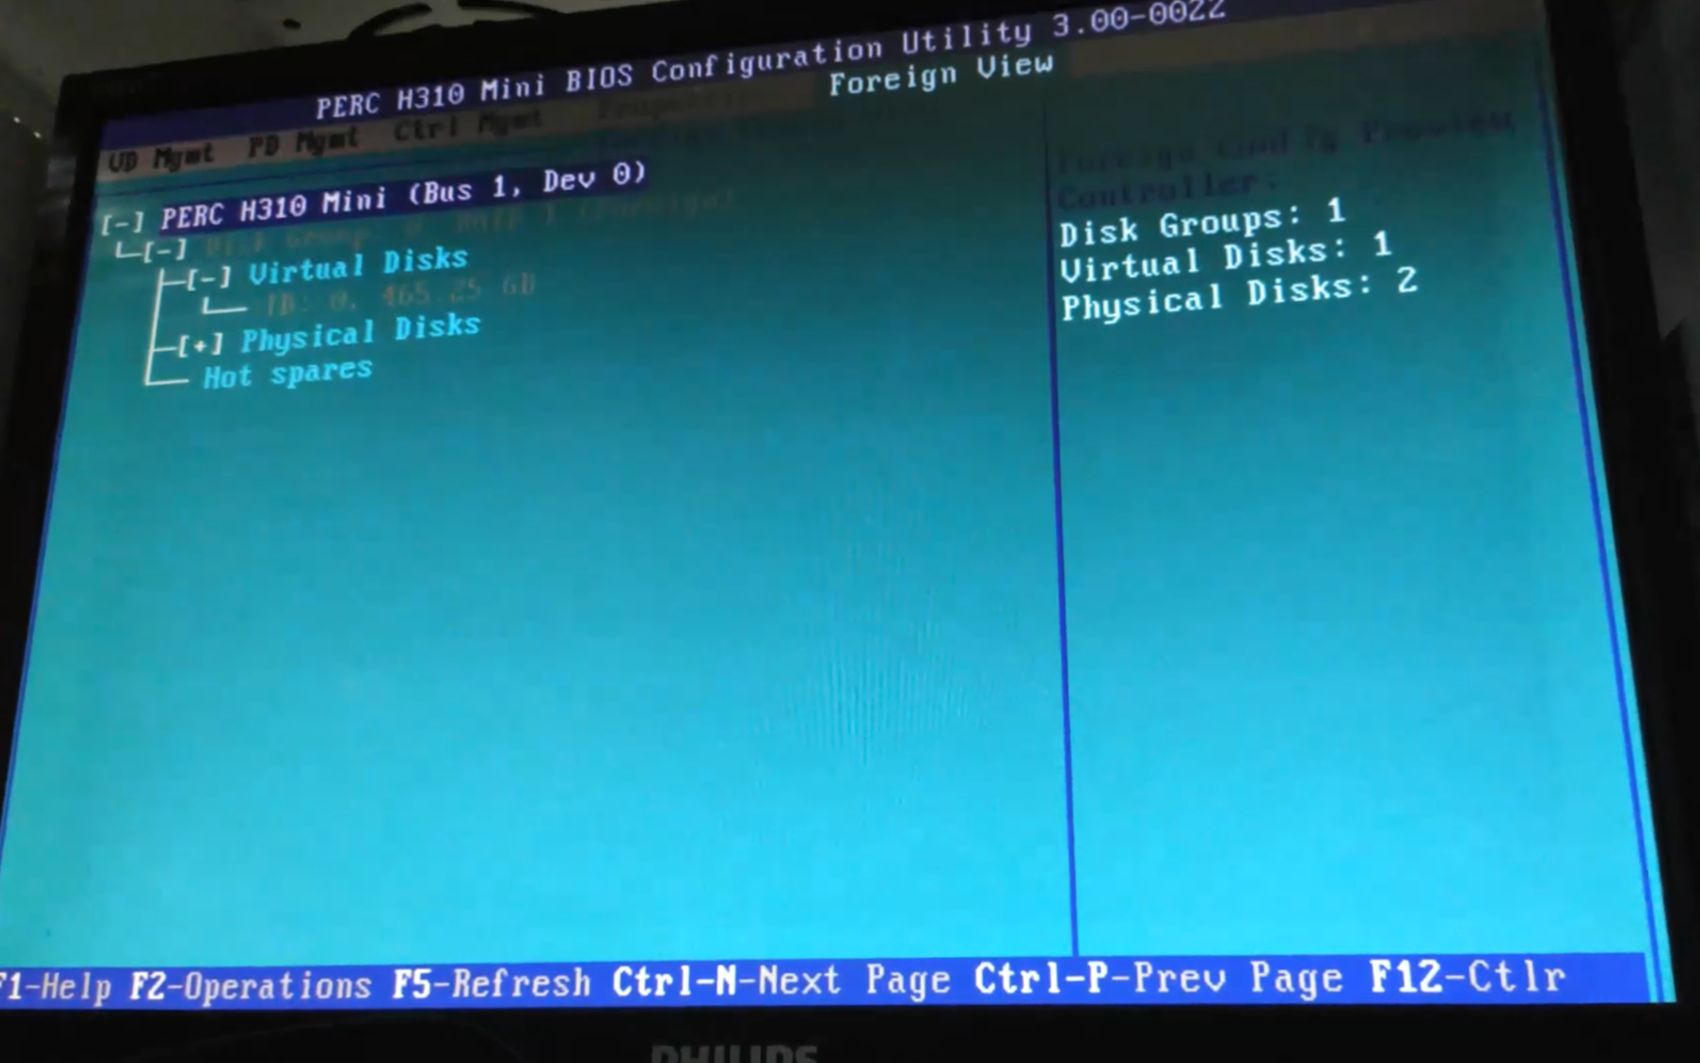
服务器硬件管理面板如果发出连续的“滴滴滴”长鸣,并且前面板有黄色警示灯在闪,基本就是RAID卡检测到阵列丢失了某块盘,这时候,直接看主板上的RAID卡型号,或者进BIOS里的RAID配置界面,就能找到哪块盘亮红。
服务器硬盘灯不亮是什么问题,怎么盘位定位
如果你遇到的情况是硬盘灯完全不亮,服务器却报错,那问题就比较隐蔽了,很多人问“服务器硬盘灯不亮是什么问题”,这里有两种可能:盘没供电,或者盘已物理损坏,后者是多数情况。
背板上的盘位编号从0还是1开始
定位盘位最怕搞混编号,大多数服务器厂商(比如戴尔、浪潮、华为)背板上会印有数字序号,通常从0开始,也有从1开始的,戴尔PowerEdge系列前面板硬盘托架上有HDD 0/1/2丝印,浪潮NF系列则标注为Slot 0-11,如果标记磨损看不清,可以参考磁盘托架上的标签,或者拔插时观察背板对应位置的LED灯。
使用RAID管理工具定位故障盘
物理层面确定不了,就用软件去查硬盘灯不亮背后的逻辑盘符,不同RAID卡的命令不一样,但思路一致:先找控制器,再找硬盘状态。
常用路径如下:
- LSI/MegaRAID系列:命令行执行
MegaCli -PDList -aALL,看Firmware state是否为Failed或Rebuilding。 - 戴尔PERC卡:用
perccli64 /call/eall/sall show,输出里直接有State = Failed的条目。 - 惠普Smart Array:进入Smart Storage Administrator(SSA),点选逻辑驱动器,能看到物理盘状态和对应插槽编号。
命令跑完,把报错盘位的Enclosure Device ID和Slot Number记下来,对应到机箱背板就能精准揪出坏盘。
在系统里用Smartctl交叉核对物理硬盘
如果你连的是Linux服务器,可以用smartctl --scan扫出所有磁盘设备名,比如/dev/sda对应哪块盘,可以通过smartctl -i /dev/sda查看Serial Number,再和硬盘托架上的序列号贴纸比对,这一步能防止拔错盘,尤其是服务器硬盘坏了多块准备乱拔的时候,必须逐一核对。
确认坏盘后,怎么安全拔出和更换
找到坏盘只是第一步,拔盘和换盘才是真正考验操作的时候,这里要分支持热插拔和不支持热插拔两种情况。
热插拔支持情况:看托架背后有没有扳手
大部分机架式服务器的硬盘托架都带解锁扳手,这种设计就支持热插拔,拔盘前一定要确认RAID卡和背板供电支持热插拔功能,否则直接拔会导致系统崩溃。
操作顺序为:
- 先暂停该硬盘对应的业务负载(如果是RAID1或RAID5,可以不停业务)。
- 观察硬盘状态灯从常亮变成闪烁或熄灭。
- 解开托架扳手,等5-8秒让硬盘完全停转。
- 垂直用力拉出托架。
- 换上新盘,推入到底,扣上扳手。
- 回到管理工具查看是否自动进入
Rebuild状态。
Raid5坏了一块硬盘怎么更换才安全
很多人搜索“Raid5坏了一块硬盘怎么更换”,核心诀窍在于:不要一次拔两块,RAID5只允许坏一块盘,如果同时坏了第二块,阵列直接失效,数据全没。
处理方法:
- 确认当前只有一块盘
Failed,另一块处于Online状态。 - 新盘容量必须大于等于坏盘容量,最好同品牌同型号。
- 插入新盘后,RAID卡会自动开始重建,此时不要重启服务器,不要做磁盘碎片整理。
- 等重建进度到100%再考虑做其他操作,重建期间硬盘负载很高,温度会上升,注意机房空调。
服务器硬盘损坏数据恢复流程有哪些前置操作
如果你遇到的是整阵列掉线,或者多块盘同时坏,数据恢复就得提上日程,这里先声明:数据恢复不是换盘就能解决的,别乱动。
先镜像再恢复,别在原盘上做文章
“服务器硬盘损坏数据恢复流程”的第一步永远是磁盘镜像,用专业设备或者软件把坏盘的扇区级镜像导出,再做文件系统层分析,直接在坏盘上跑数据恢复软件会加速磁头失效,二次损坏非常常见。
坏盘数量决定恢复策略
| 坏盘数量 | 阵列状态 | 恢复策略 |
|---|---|---|
| 1块(RAID5) | 降级可用 | 直接换盘重建,无需恢复 |
| 1块(RAID6) | 降级可用 | 直接换盘重建,无需恢复 |
| 2块(RAID5) | 失效 | 需虚拟重组,用镜像工具抽取剩余盘数据 |
| 2块(RAID6) | 降级可用 | 换盘重建,但风险高 |
| 3块及以上 | 彻底崩溃 | 只能送专业机构开盘处理 |
多数情况下,2块以上损坏且阵列失效,个人用软件扫描基本是浪费时间,建议直接找有洁净间条件的机构,把盘拆下来逐个做镜像,再用RAID重组软件拼数据。
日常怎么预防服务器硬盘故障和快速定位
与其等坏了再找,不如日常就建立监控防线,很多机房运维人员最头疼的就是硬盘报错但不知道是哪块,提前做好配置能省一大半时间。
配置硬盘巡检任务:定期做读检测
Linux下可以写一个cron定时任务,每个月执行一次smartctl -t long /dev/sdX,把结果输出到日志文件,用脚本抓取Raw_Read_Error_Rate和Reallocated_Sector_Ct的变化趋势,如果重映射扇区数持续上升,说明盘快不行了,提前换掉比事后恢复强得多。
使用服务器管理平台统一监测硬盘状态
戴尔的iDRAC、惠普的iLO、浪潮的BMC管理平台都能在WEB界面直接看到每块盘的Health Status,打开管理页面,进入“存储”或“磁盘”子菜单,状态为Critical或Failed的就是故障盘,有的平台还支持邮箱告警,硬盘一亮红灯,告警信直接到手机,这属于近年来企业机房标配的运维手段。
Q&A:服务器硬盘故障排查高频问题
服务器硬盘亮红灯怎么处理最先做什么
先确认亮红灯的盘位编号,然后进RAID管理工具查看该盘是否被标记为Failed,如果标记为Failed,立即确认阵列当前还有其他盘在线,接着热插拔更换同规格新盘,等待自动重建,如果管理工具里显示Rebuilding,说明系统已经在重建了,保持观察就好。
硬盘坏了一块不换能撑多久
RAID5阵列坏一块盘不换的情况下,系统处于降级运行状态,这个状态能撑多久没有保证,取决于剩余硬盘的健康程度和I/O负载,如果剩余盘已经有重映射扇区或坏道,随时可能再坏一块导致阵列崩溃,数据全部丢失,行业共识认为,降级状态最多作为短时间过渡,必须尽快换盘重建。
如何区分服务器硬盘物理故障还是逻辑故障
物理故障表现为异响、指示灯异常、smartctl输出中Current_Pending_Sector不为零,逻辑故障表现为系统能识别硬盘但分区丢失、文件系统报错、读写超时,物理故障需要换硬件,逻辑故障可以用fsck或数据恢复软件修复,两者处理路径完全不同,用smartctl -H查看整体健康状态,加上开机自检时的SMART Status: BAD提示,基本能判断是否物理损坏。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/701192.html