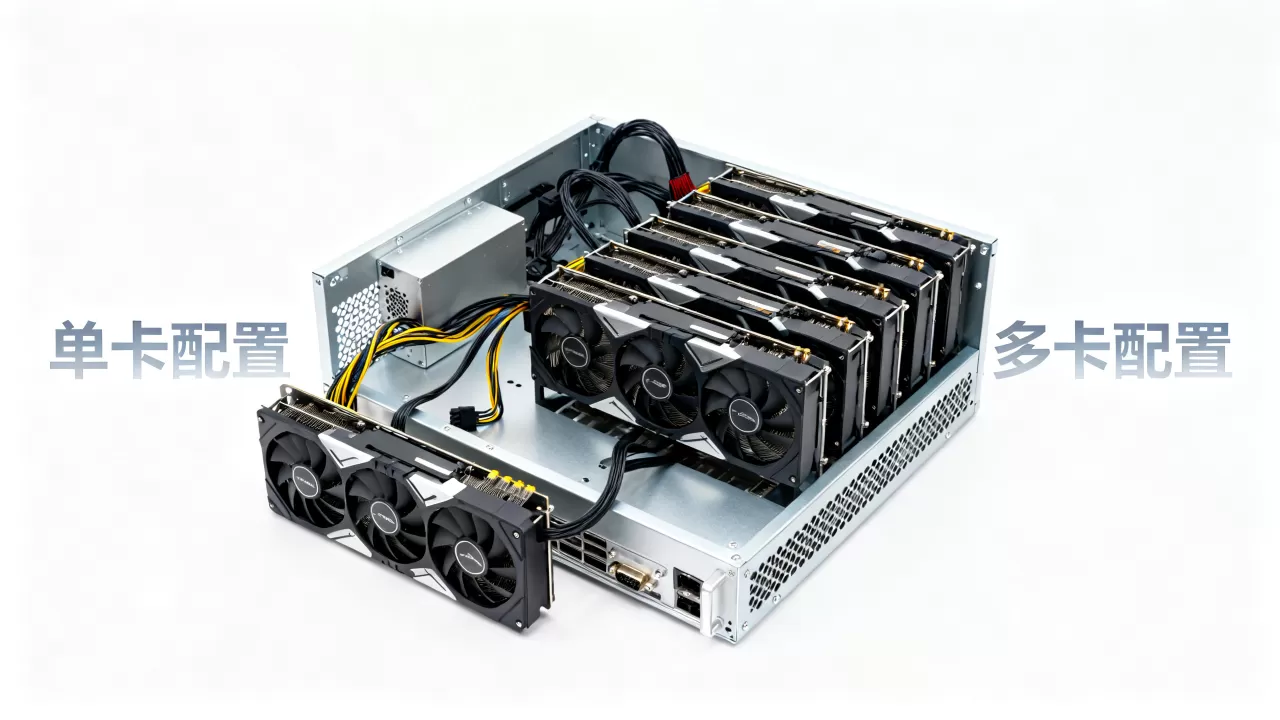
在成都选购GPU服务器,绝大多数深度学习与AI推理场景下,多卡方案比单卡更合适,但预算有限或任务单一明确时,单卡反而更划算。这个结论不是拍脑袋,而是基于GPU服务器的工作特性、成都本地机房带宽与电力成本、以及主流AI项目的实际负载形态得出来的,下面我从选型逻辑、场景拆解、价格敏感度、租购选择四个维度展开,帮你把账算清楚。
为什么说多卡方案是成都AI项目的“默认选项”
成都的AI产业集中在天府软件园、成都科学城和电子科技大学周边,这里跑的项目大多是计算机视觉、自然语言处理、推荐系统这类并行计算密集的任务,这类任务的共同点是:数据量大、模型参数量大、单张卡显存往往不够用,行业内专家指出,当前主流大模型微调的最低显存门槛已经来到24GB,而一张RTX 4090只有24GB显存,单卡跑7B参数模型只能勉强推理,训练根本无望,多卡能做什么?
- 模型并行:把一个大模型切成几块,分别放到不同GPU上,解决单卡显存不足的硬瓶颈。
- 数据并行:多张卡同时吃不同批次的数据,梯度汇总更新,训练速度接近线性提升。
- 流水线并行:层间拆分,适合超深网络,多卡协同减少单卡空闲等待。
具体到成都的创业团队,多卡GPU服务器意味着从“能跑”到“跑得动”的质变,比如一个做工业质检的客户,需要同时跑三个YOLO模型做缺陷检测,单卡只能串行推理,一张RTX 4090处理一张图要200毫秒;换成4卡A800服务器,并行处理后单张图耗时降到50毫秒以内,产线节拍完全跟得上。
多卡并不是无脑堆卡,一张卡能解决的问题,非要用四张卡,只会白白增加功耗和散热负担,下面我们把场景分清楚。
单卡最合适的三种情况
如果你属于以下三类用户,请优先考虑单卡方案,省下的预算足够你买三年云服务:
- 个人开发者或高校实验室:跑论文复现、小规模实验,单张RTX 4090或A6000足够,PyTorch单卡训练一个ResNet-50,在ImageNet子集上跑10个epoch,耗时大约6个小时,多卡加速比反而因为通信开销打折扣。
- 中小模型推理服务:比如部署一个BERT问答系统或者Stable Diffusion生图服务,单张A10能同时处理8-12路并发请求,绝大多数成都本地企业的日均调用量在千次级别,单卡绰绰有余。
- 算法原型验证:在写代码阶段先用单卡调试,确认模型结构和数据处理逻辑无误,再决定是否扩展到多卡,这能帮你避免在错误方向上浪费昂贵的多卡租赁费。
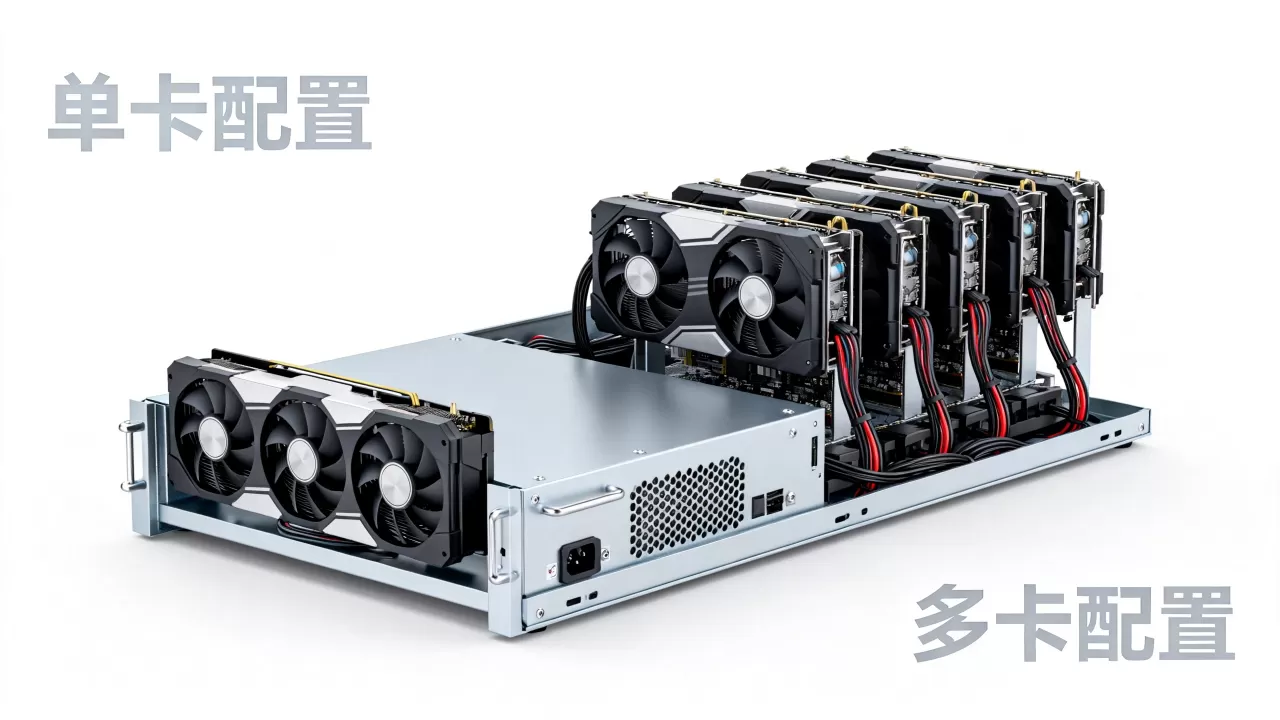
我有一个做自动驾驶数据标注的朋友,公司买了两台单卡RTX 4090服务器,每台不到4万元,专门跑标注模型的推理,一年下来比租云GPU节省了60%成本,但他们后来接了一个多模态大模型的项目,单卡连权重大小都装不下,最后还是换成了多卡方案。
多卡不可替代的核心场景
当任务满足以下任何一个条件,单卡就无法胜任,必须上多卡:
- 大模型微调或全参训练:参数规模超过7B,单卡显存直接溢出,以ChatGLM-6B的LoRA微调为例,一张A800(80GB)勉强能跑,但序列长度超过2048就会爆显存;改用两台双卡A800服务器做张量并行,序列长度能拉到8192,效果完全不同。
- 高并发实时推理:面向外部用户的API服务,需要稳定支撑上百路并发,单卡A10的推理吞吐量约为每秒50次,多卡集群通过负载均衡可以轻松扩展到每秒300次以上,而且单卡故障时其他卡还能降级服务。
- 多任务并行处理:比如同一个服务器上同时跑模型训练、数据处理和视频转码,这种混合负载对GPU资源的需求是碎片化的,多卡可以将不同任务隔离到不同GPU上,避免互相抢占显存。
成都本地几家做数字人直播的公司,几乎清一色采购了四卡或八卡GPU服务器,原因是数字人需要同时运行人脸识别、口型同步、语音合成和渲染四个模型,每个模型至少要占一张卡的半块显存,单卡根本塞不下这些任务。
成都多卡GPU服务器价格:从配置单看真实成本
不少人一听到“多卡”就以为价格翻倍,其实不然。多卡GPU服务器的成本不只是显卡的简单相加,主板、CPU、内存、电源、机箱都必须跟着升级,以下基于成都本地服务器经销商的公开报价区间(不含关税波动,2026年主流配置):
| 配置类型 | 典型规格 | 参考价格区间(万元) | 适合人群 |
|---|---|---|---|
| 单卡入门 | RTX 4090 + 单路至强 | 5-4.5 | 个人开发、小模型推理 |
| 双卡主流 | 2×RTX 4090 + 双路至强 | 7-9 | 中型团队训练 |
|
四卡高性能 | 4×A800(80GB) | 30-40 | 大模型微调、多任务负载 |
| 八卡旗舰 | 8×A800(80GB) | 60-75 | 大模型预训练、科研机构 |
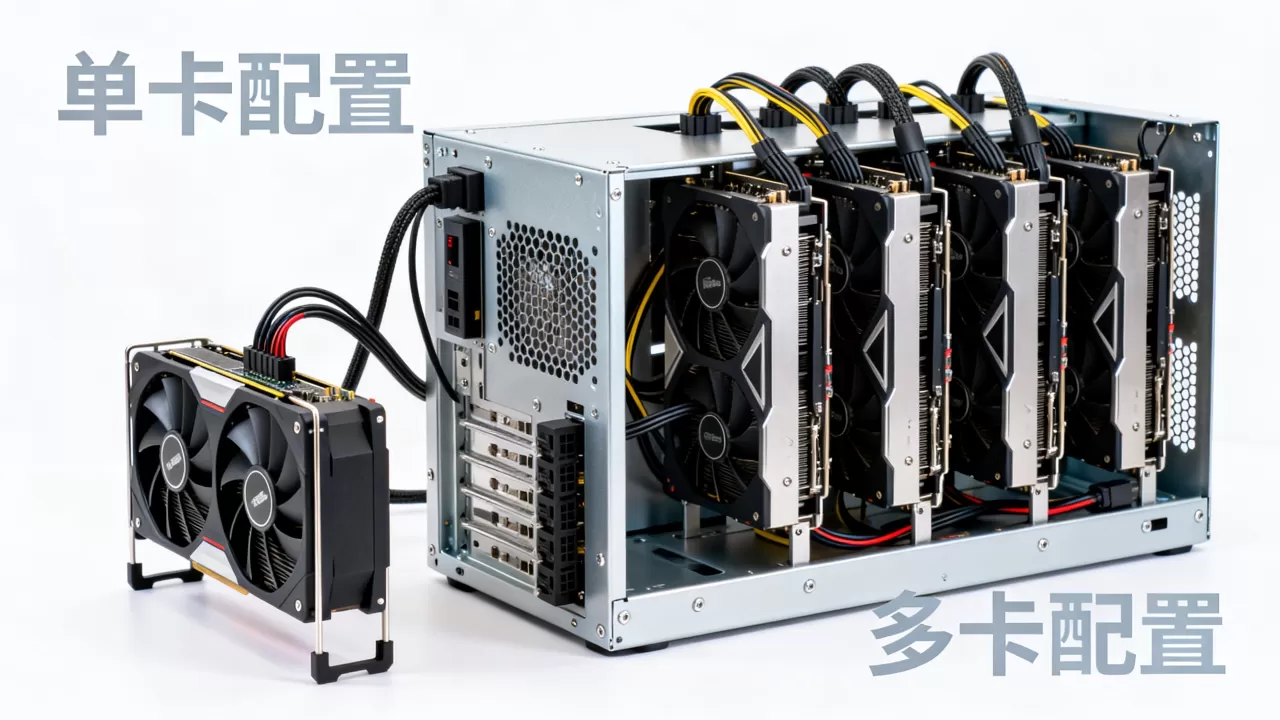
注意,上述价格是整机价格,包含主板、电源、散热、机箱,但不包含机柜和专线宽带,成都机房托管费用大约在每月每U 300-600元,一台4卡服务器通常占2U-4U空间,加上10M独享带宽(月费约1500元),一年托管成本大约在3-6万元,如果你在成都高新区自有办公室,用民用宽带上内网跑训练,那么只用付电费一张A800满载功耗300W,四卡满载加上CPU整机功耗接近6kW,按成都商业电价1.1元/度计算,7×24小时跑一个月电费约1300元。
租用还是购买:成都本地企业的真实账本
在成都买多卡GPU服务器的前期投入确实不低,但如果你算上三年折旧,租金往往更贵,我们做个对比:
- 购买四卡A800服务器:40万元,按五年折旧,每年8万元,加上托管费5万元/年,总成本13万元/年。
- 租用同等配置云GPU:按市面价每小时20元(包月有折扣),7×24小时运行,年费用约15万元。
- 只在训练时使用、推理用云函数弹性伸缩:年费用降到5-7万元,比自购便宜。
结论很清晰:如果GPU利用率超过70%,自购更划算;如果利用率低于40%,租用更灵活。 成都很多AI公司是从云GPU租用起步的,等模型跑通、数据量上来后再转为自购,这种“先租后买”的路径,行业共识认为能降低初期50%以上的试错成本。
从实际部署角度,教你判断单卡或多卡
不要盯着“卡数”做决定,按下面四个步骤操作,你自然知道该选什么。
- 跑一次显存诊断:用
nvidia-smi监控你的目标模型在典型batch size下的显存占用,如果峰值超过单卡显存的80%,直接选双卡或四卡,这个命令不需要额外安装依赖,Linux和Windows都自带。 - 估算训练日内耗时:记录现有单卡完成一个epoch的时间,乘以总epoch数,如果结果超过你项目deadline的一半,就考虑多卡加速,比如单卡跑完要72小时,而你只有48小时,那必然要上四卡。
- 检查代码是否支持多卡:PyTorch用
torch.nn.DataParallel或DistributedDataParallel,TensorFlow用tf.distribute.MirroredStrategy
,如果代码里没有这些,单卡直接跑更省心。
- 评估数据加载瓶颈:如果你的图像/文本数据量超过10GB,GPU计算往往在等硬盘IO,这种情况下加再多卡也快不起来,先解决存储问题再考虑多卡。
成都场景下,两个被忽略的“多卡”细节
电源老化与机柜散热,成都夏季炎热,机房如果没做精密空调,四卡满载时进风口温度超过30℃,GPU会自动降频,跑分打七折,建议选服务器时确认是否支持前后风道设计,并预留至少两个冗余风扇位。
多卡通信协议,同样是四卡,PCIe版本和NVLink开关直接影响加速比,40万元的四卡A800标配NVLink,卡间通信带宽高达600GB/s;如果你图便宜买了PCIe版A800,通信带宽只剩64GB/s,许多并行任务的加速比从3.8倍掉到2倍以下,购买时务必向商家确认“是否是NVLink版本”。
常见疑问:成都GPU服务器单卡还是多卡,快速问答
成都本地做毕业设计的学生买单卡还是多卡?
买单卡,毕业设计的数据量和模型复杂度都有限,一张RTX 4060 Ti 16GB(约4000元)就能覆盖绝大多数课题,多卡不仅超预算,还会因为实验室的普通插座供电不足(4卡需要独立40A电路)而根本无法开机。
多卡GPU服务器日常运维比单卡难很多吗?
没有想象中复杂,但多卡确实多两道工序:第一,定期用nvidia-smi -L确认所有GPU是否正常注册;第二,训练时用nvidia-smi dmon每10秒记录一次卡间温度差异,温差超过15℃就该检查散热风道,硬件故障几率会随卡数线性上升,但一台4卡服务器一年内故障概率仍然很低。
成都哪里有靠谱的多卡GPU服务器渠道?
本地渠道集中在磨子桥电脑城和高新区世纪城附近,线上则有简米云、酷番云的成都地域节点,建议先租一台4卡A800云服务器跑一周真实负载,用nvidia-smi统计平均利用率,确认利用率高于50%再考虑购买,如果任务峰值明显低于这个数,继续租用就好,不必背固定资产包袱。
最后说透一句话:选单卡还是多卡,本质是拿钱买时间还是拿时间换钱。 成都的AI创业者们,如果你项目周期短、预算充足,多卡帮你抢出三个月窗口期,这个价值远超硬件差价;如果你在验证阶段、现金流吃紧,单卡足够你写代码和调通逻辑,算清显存占用、算清月度电费、算清卡间通信损耗,你的答案自然浮现。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/704076.html