医疗AI质控模型的持续训练,本质上是让模型在真实临床环境中不断“见新病例、改旧毛病”,而这个过程的成败,完全取决于数据管道是否能把“采集、清洗、标注、回流、版本管理”这五件事做成一个自动旋转的闭环。如果管道设计不当,模型越训练越偏,质控指标反而下降,本文直接拆解一套可落地的数据管道规划方案,从数据源选型到版本回滚机制,每一步都给出具体操作路径。
医疗AI质控模型数据管道怎么设计
质控模型不同于辅助诊断模型,它处理的是“检查报告有没有漏项”“影像片拍摄角度是否达标”“病历书写是否规范”这类流程性数据,这类数据的特征是多模态、强时序、高噪声,管道设计的核心矛盾在于:训练数据要新,但新数据往往是脏的。

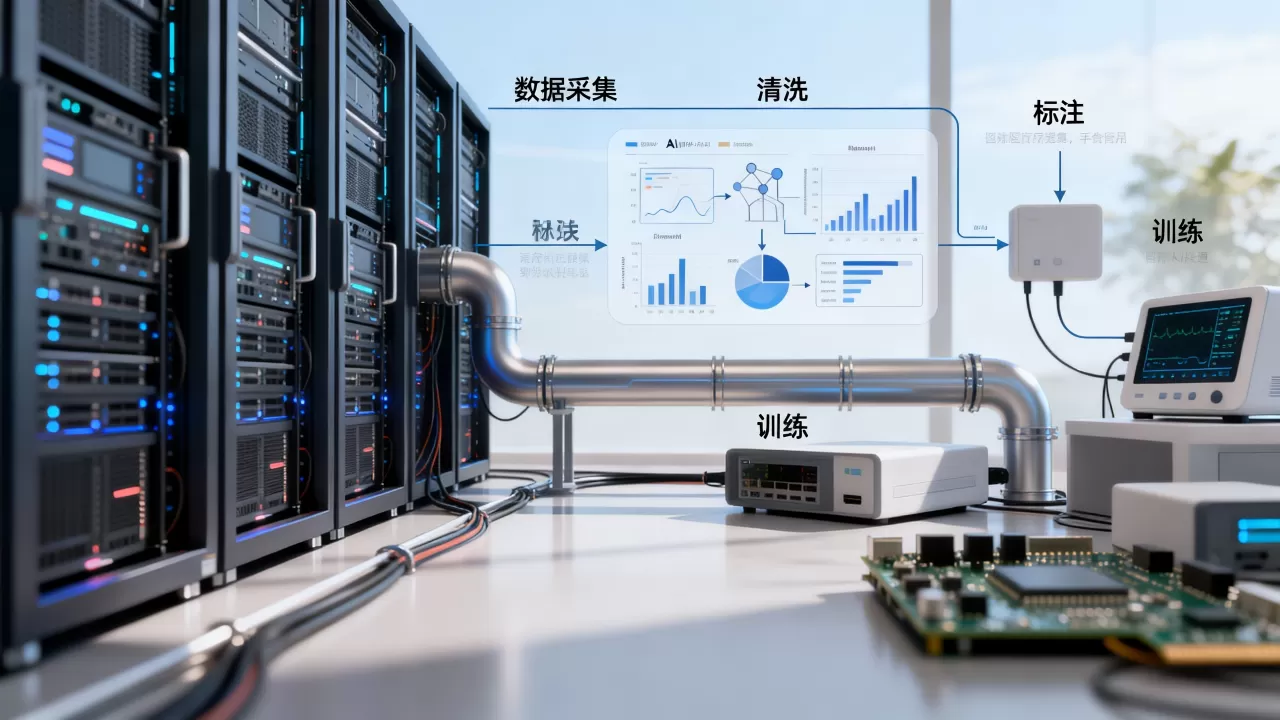
业内专家的共识是,管道必须分成“实时反馈支线”和“批量训练主线”两条路并行,实时支线只做轻量级清洗,把当天产生的质控日志、图像标注修正、医生驳回记录抓出来,存入原始缓冲池,批量主线则按周或双周触发,对缓冲池数据做深度治理,生成标准化训练集,为何要分两条路?因为质控模型的误判案例是最好的训练样本,而这些案例恰好在生产环境中产生,等不了月度汇总。
第一步:定义数据源接入优先级
不是所有数据都值得进管道,优先级排序如下:
- P0级数据源:模型自己产生的误判记录,例如质控系统把正常影像标记为“曝光不足”,医生手动纠正后,这条数据必须即时回流,没有这类数据,管道就是死水。
- P1级数据源:PACS/RIS系统的质控日志、病历质控平台的修改痕迹,这类数据显示的是“真实临床标准”的变化趋势。
- P2级数据源:公开的医学质控指南更新、行业质控竞赛数据集,用于防止模型在持续训练中“遗忘”基础能力。
按此优先级分配存储和算力资源,相当一部分项目失败,就是因为把P2级数据当成P0级来采集,导致管道拥塞。
第二步:设计清洗规则与标注仲裁机制
医疗数据的清洗不能只靠正则表达式和异常值检测,质控数据的“脏”主要体现在标注不一致上,两个科室对“病历主诉书写完整”的判定标准可能互相冲突。
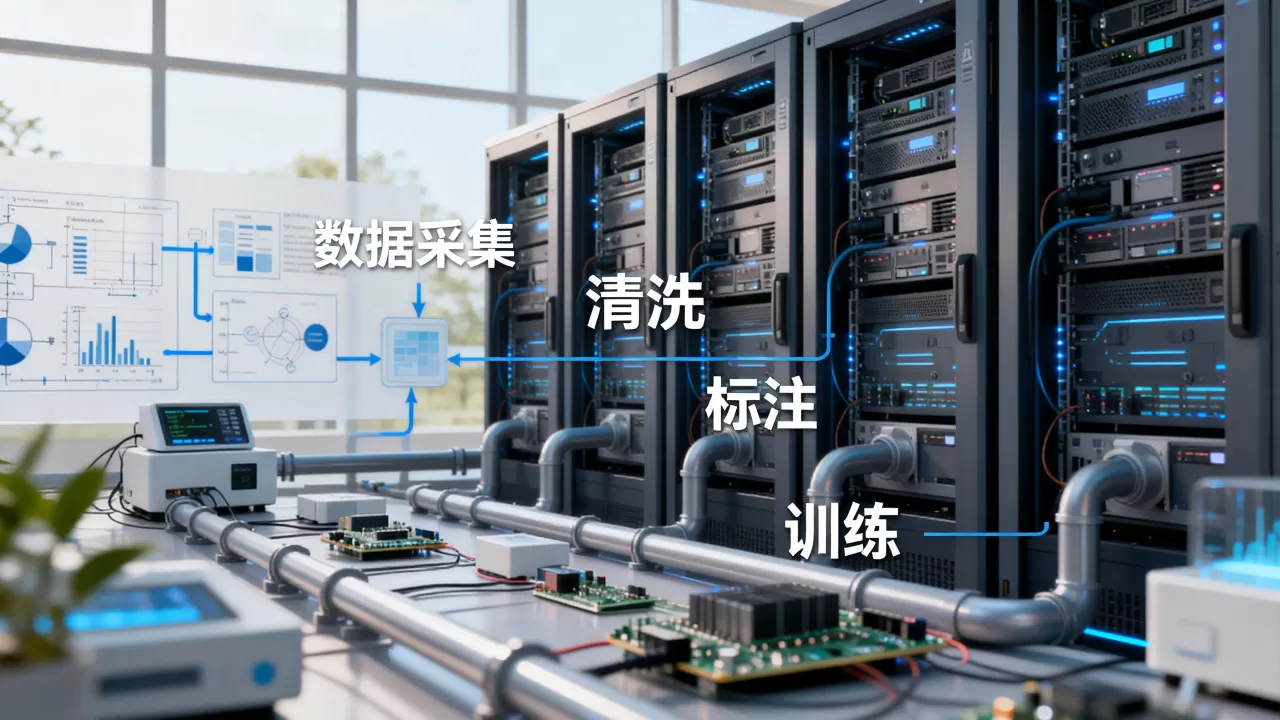
推荐路径是:规则引擎预清洗 -> 主动学习筛选 -> 人工仲裁,规则引擎负责剥离无关信息,比如去掉影像文件头里的设备序列号、清除重复提交的报告,主动学习模型挑选出“模型置信度在40%-70%之间”的争议样本,推送给人机协同标注平台,人工仲裁环节必须有高年资医生参与,但不必让他们标注全部数据,只需仲裁机器无法决断的样本,据统计,这一流程能将标注成本降低近一半,同时保持仲裁结果的权威性。
第三步:数据版本管理与回滚机制
模型训练的噩梦之一,是“上周的数据比这周的好”,没有版本管理,你甚至说不清模型性能下降是因为代码改动还是数据污染,具体操作上,每个训练批次必须打上三重标签:
- 数据源标签:标明批次内来自P0/P1/P2的占比
- 时间窗口标签:临床数据有季节性,冬季呼吸道疾病高发期的质控数据和夏季完全不同
- 清洗规则版本号:清洗规则本身也在迭代,同样的原始数据在不同规则下产物不同
训练完成后,将模型在“留存验证集”上的表现记录下来,一旦新模型在验证集上出现超过预设阈值的性能回退,自动触发回滚,回到上一个稳定版本,行业惯例是在验证集上保留近三个月的核心指标基线,具体阈值因业务场景而异,建议设在2%-3%之间。
医疗AI训练数据清洗标注流程执行细节
很多团队把清洗和标注视为两个孤立步骤,实则它们紧密耦合,以下给出一套可复用的执行流程,尤其适合多院区部署场景。
清洗流程的四个具体动作
- 去重:依赖哈希比对配合影像特征向量检索,同一患者的重复检查在PACS里很常见,如果不去重,模型会对常见病例过度加权。
- 脱敏:质控数据涉及大量患者隐私,推荐在院内网关处完成姓名、身份证号、住院号的替换,训练数据集内仅保留“年龄区间+性别+检查目的”等粗粒度字段,近年来,越来越多医院要求原始数据不出院,这就意味着脱敏动作必须前移到数据采集端。
- 时序校正:质控数据是流程的副产品,比如一份病历从创建到定稿历经多次修改,管道需要保留修改前后的完整版本链,而非仅仅保存终稿,操作层面,可利用DICOM头文件或HIS系统的时间戳重建时序。
- 质量评分:给每条数据输出一个0-1之间的质量分,低于0.6的数据直接丢弃或转人工复核,评分维度可参考表格:
| 数据维度 | 说明 | 常见低分原因 |
|---|---|---|
| 完整性 | 字段缺失比例 | 报告未传PDF原件,只有XML |
| 一致性 | 同一患者不同系统间信息冲突 | 身高体重单位混用 |
| 标注可信度 | 仲裁专家的年资和一致率 | 低年资住院医生独立标注 |
标注环节的协作分工
质控模型的标注人员不必全是医生,观察类任务,影像位置摆放是否标准”,可以由经过培训的技师完成;而涉及诊断逻辑的任务,如“诊断结论与检查结果描述是否矛盾”,必须由主治医师以上人员负责。
建议使用“预标注+修正”模式:先让上一版模型对数据做自动标注,标注员只负责修正,实测这一模式能把标注速度提升约40%,同时由于预标注的参考框架存在,标注员之间的标准差异也会缩小,标注完成后,需执行抽检环节,抽检比例按5%动态调整,若抽检不一致率高于阈值,则整批退回重标。
医疗AI质控数据闭环怎么打通
数据管道不是单向流水线,而是一个环,打通闭环的关键在于评估“训练后的模型是否真正解决了生产环境中的旧问题”。
在推理服务内埋设反馈接口
具体操作:在质控模型的推理服务中,增加一个“预测结果采纳状态”字段,当医生的操作与模型建议相悖时,系统记录这条冲突上下文,这些上下文是模型下一次迭代最珍贵的物料,质控模型提示“当前CT影像缺少定位像”,但技师强制提交了申请单,系统需要记录技师的拒绝理由。
定期用真实数据切片做回测
训练完成后的模型,不能只跑历史测试集,还要拿到当前生产环境的数据切片上跑一遍,切片的选取策略为:近7天全量数据 + 随机抽取的一个完整科室月度数据 + 边界案例数据包,边界案例包内是人工收集的极难样本,比如罕见的图像伪影、极端体位的检查记录。
监控管道健康度
设置三个核心监控项:
- 数据延迟:从生产事件产生到进入缓冲池的时长,应低于5分钟
- 标注积压量:若积压超过一周的训练用量,需要临时增加标注人力
- 误判回流率:推理服务中医生纠正模型的比例,该指标突然飙升往往意味着数据分布漂移
行业共识认为,数据管道的健康度比算力利用率重要十倍,一个能稳定提供高质量训练数据的管道,远比一个GPU满载但喂给模型垃圾数据的管道有价值,医疗AI质控模型的数据管道规划终归要回到一个朴素的道理:让每一次临床上的细微纠偏,都变成模型下一次更聪明的理由。
医疗AI质控数据管道常见问题详解
Q1: 医疗AI质控模型数据管道和一般AI数据流水线区别在哪?
核心差异在“真值获取”环节,通用的图像分类或NLP模型,真值标签相对客观,图片里是否有猫”,而医疗质控数据带有强烈的主观判断和院区差异,同一份病历,在一家三甲医院质控科眼里是合格,在另一家要求更严格的医院可能就是D级,管道的后期必须引入多院区的专家仲裁机制,而非单纯依赖标注规范文档。
Q2: 如何控制医疗AI质控训练数据标注成本?
首先砍掉基础数据的标注外包,质控数据的初级任务,如“图像是否模糊”“报告字段是否缺失”,完全可以用规则引擎自动打标,准确率很高,真正需要人工介入的只有语义矛盾、标准争议这类复杂案例,这部分成本无法压缩,但可以通过主动学习将复杂案例的占比显著缩小,实际项目中,经过三轮管道迭代后,需人工标注的数据量通常能降低到总量的三成左右。
Q3: 多院区部署时,数据管道应该集中还是分散?
采用“分散清洗、集中训练”的结构,各院区只上传经过脱敏和规则清洗后的特征数据,原始影像和完整病历留在院内的数据网关,这一做法既符合大型医院对数据出境的管理要求,也能让中心节点聚合多院区数据,获得更稳定的统计分布,分散节点之间通过加密通道同步清洗规则版本,确保各个院区产出的特征口径一致,否则训练出的全局模型在某个院区容易失效。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/705231.html