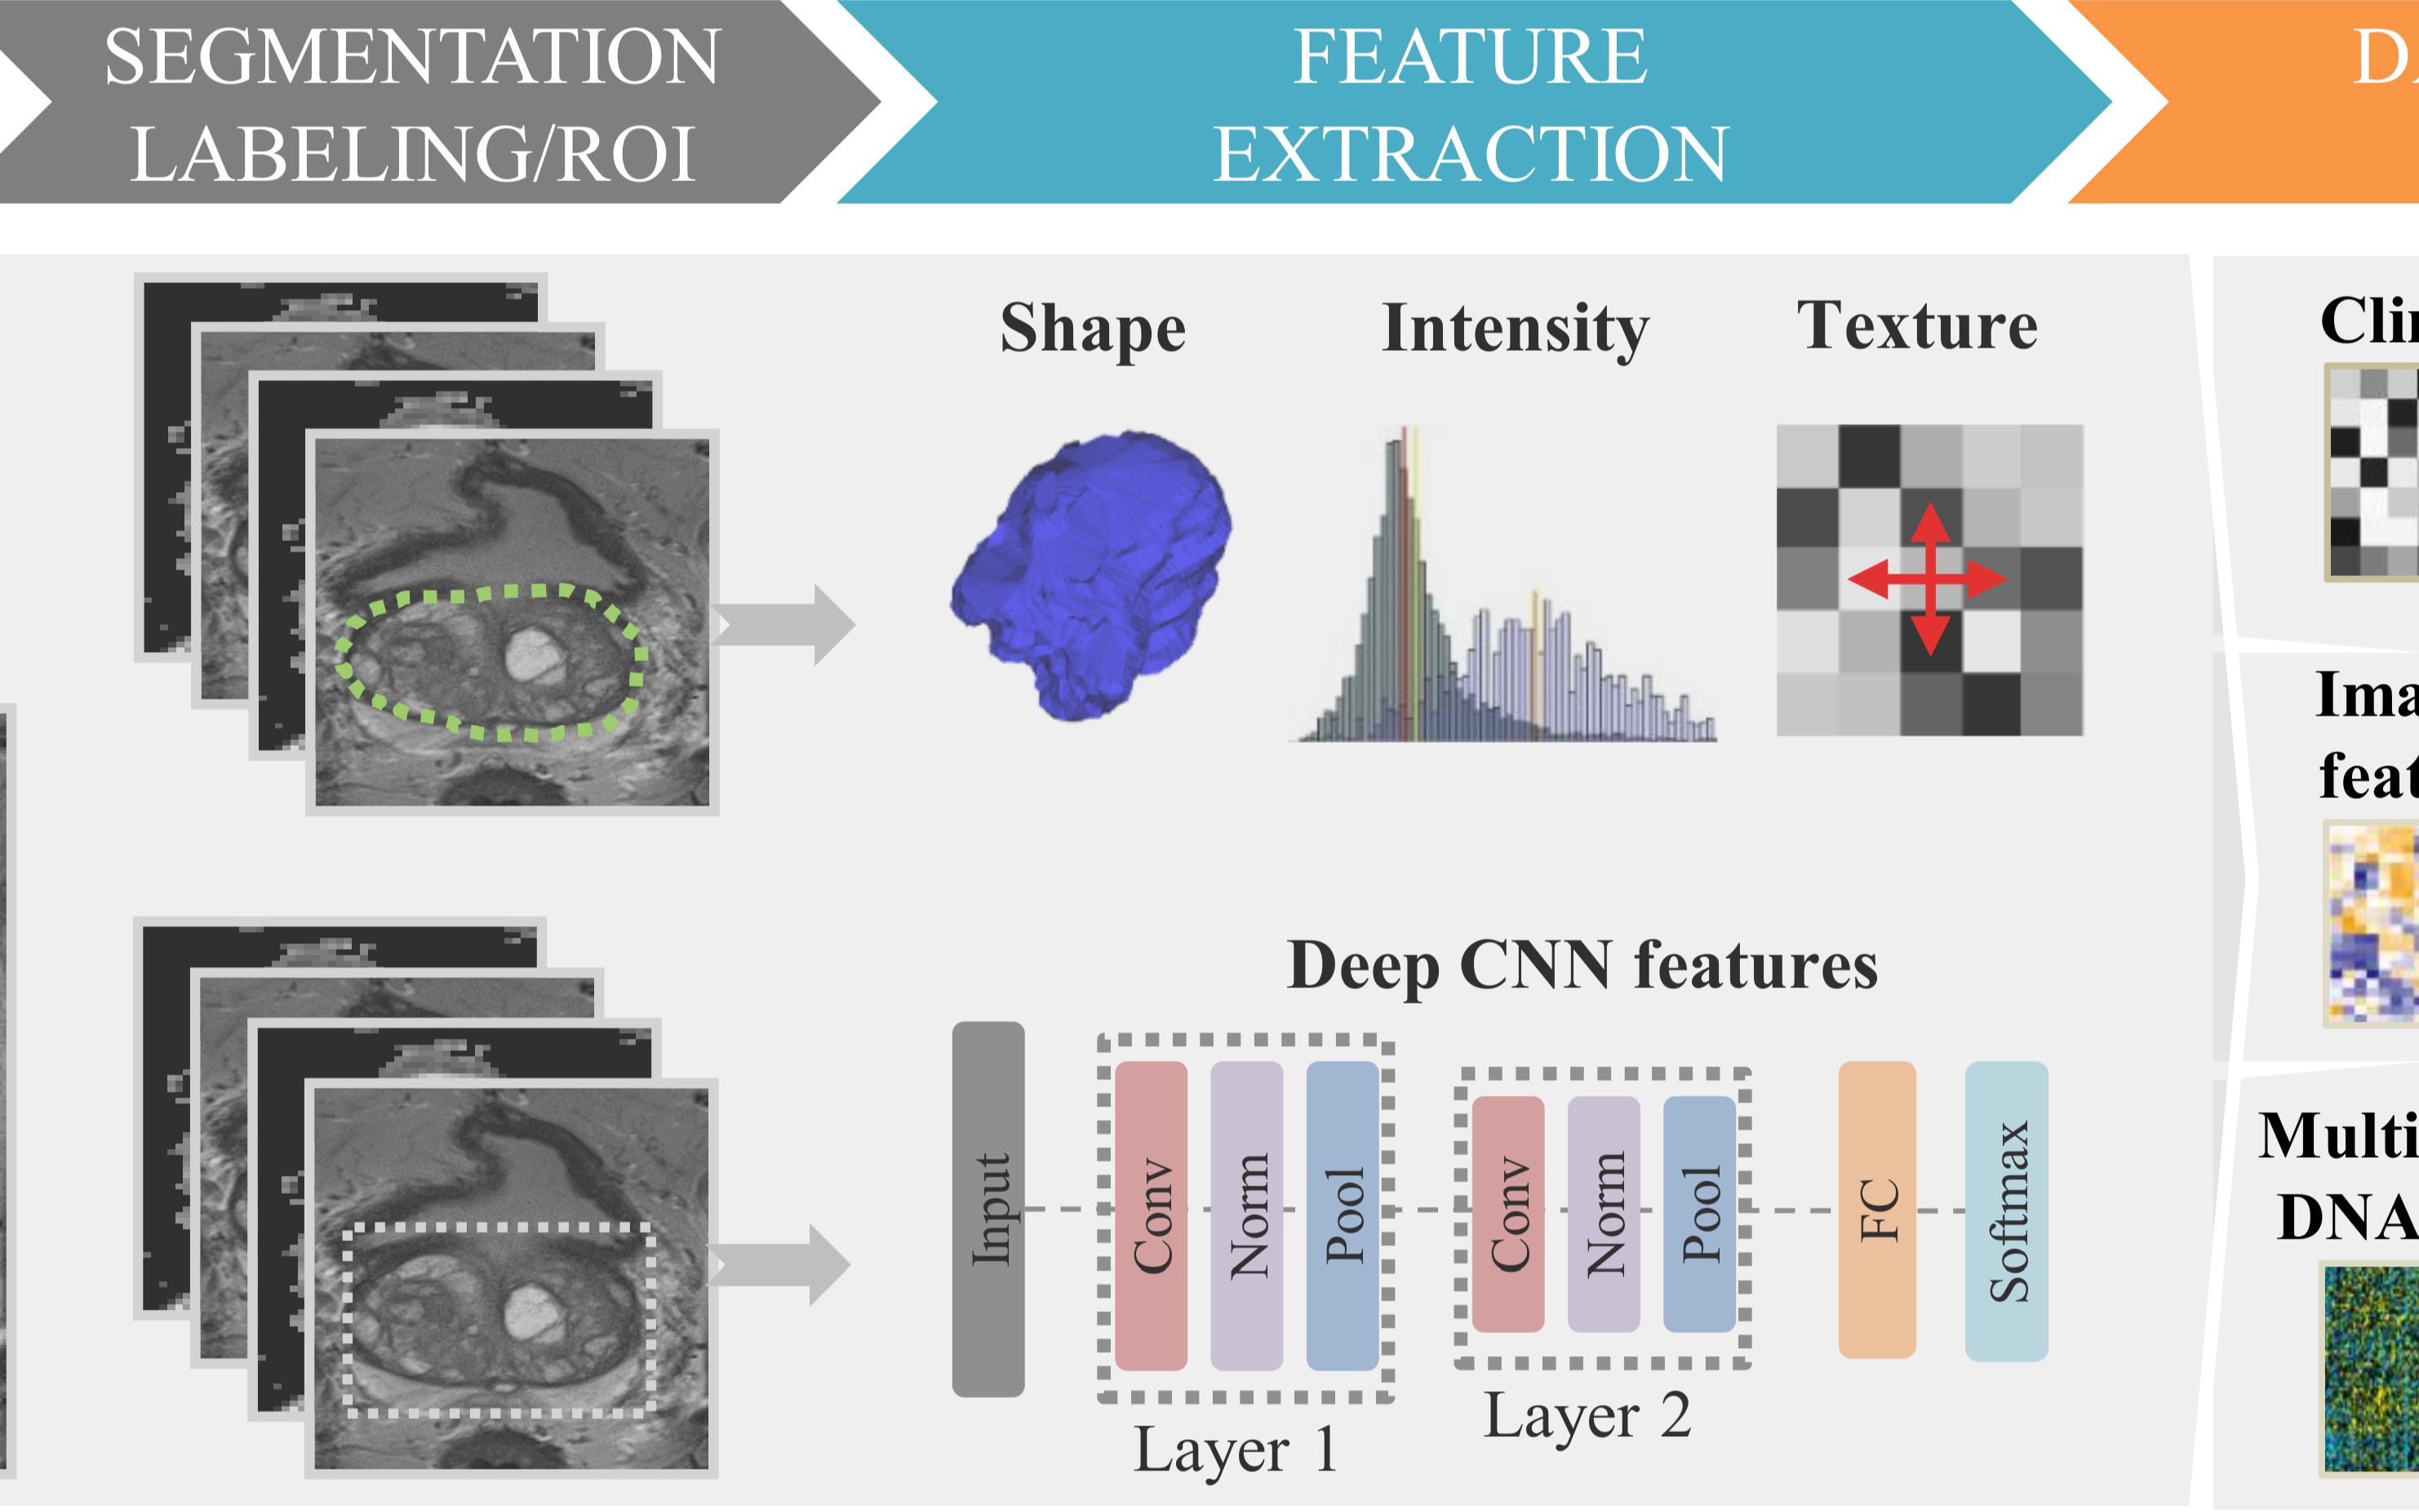
影像组学特征提取时的内存占用优化,核心思路是从数据类型压缩、分块处理与特征筛选三个方向同步下手,多数情况下能将内存峰值压缩到原来的三分之一以下。
影像组学特征提取,尤其在批量处理医学影像时,内存爆掉几乎是每位科研人员都踩过的坑,PyRadiomics这类工具虽然强大,但默认配置下读取一例CT扫描就要占用2-4GB内存,再叠加数百例数据循环处理,16GB内存的机器经常直接卡死,业内专家指出,这个问题在高维特征提取场景中尤其突出,单纯加内存条治标不治本,必须从代码逻辑和算法选型层面重新设计数据流。

定位内存杀手:特征提取为什么这么吃内存
影像组学特征提取的内存开销,并非均匀分布在整个流程中,根据实际运行逻辑,三个环节占据了绝大部分资源消耗。
原始图像的数组驻留占用,医学影像读入内存后,以numpy数组形式存在,以最常见的512×512×300的CT序列为例,如果原始数据是int16类型,占用约150MB;但如果代码在预处理时不小心转成了float64,空间立刻膨胀4倍,掩膜文件相对较小,但两者同时驻留后,PyRadiomics内部还会有一系列中间变量参与计算。
特征计算中的中间变量膨胀,PyRadiomics计算纹理特征时,需要先构建灰度共生矩阵或灰度游程矩阵,这类矩阵的尺寸等于影像灰度级数量的平方,如果不做灰度离散化控制,矩阵规模会指数级增长,比如灰度级256时,GLCM矩阵就是256×256,每一个体素都要参与计算,这部分动态内存开销相当可观。
批量循环中上一例数据未释放,批量提取特征时,每处理完一例,上一例的数组和矩阵应当被回收,Python的垃圾回收机制存在滞后性,如果循环代码没有显式释放变量或使用生成器,内存占用会持续累加,最终在第几十个病例时触发MemoryError,这个问题在实验室工作站上极其常见。
数据类型的压缩:从源头减小驻留体积
掩膜无损压缩至uint8
大多数分割掩膜只有0和1两种取值,用int16甚至int64存储纯属浪费,读入掩膜后立即执行mask = mask.astype(np.uint8),内存占用直接降至原来的八分之一,这是投入产出比最高的一步,代码只改一行,效果立竿见影。
原始图像谨慎降位
原始CT图像通常以int16存储,如果影像来自同一台设备且不需要亚毫米级精度分析,可以转换为float16或直接以int16格式参与运算,PyRadiomics在计算shape特征和一阶特征时对精度不敏感,但建议先小批量验证特征值一致性再全量切换,行业共识认为,
float16在多数情况下与float64的结果差异小于10⁻³量级,完全满足科研场景的表征需求。
重采样环节的体素尺寸控制
重采样功能经常默认为各向同性(如1×1×1mm),这会把300层的序列重新插值到更多层数,如果原始层间距是2.5mm,重采样后体素数量可能翻倍,内存随之翻倍,操作上应明确检查PyRadiomics的resample参数,将resampledPixelSpacing显式设置为原始分辨率或者要求不重采样,仅在算法实际需要时开启。
数据流改造:生成器替代列表,分块处理救场
用yeild生成器替代列表收集
面对上百例影像数据,一次性把所有路径读入列表再遍历,内存里堆积的字符串和句柄数量惊人,实践中建议写生成器函数,每次yield一例数据:
def case_generator(data_dir):
    for case_file in os.listdir(data_dir):
        if case_file.endswith('.nii.gz'):
            yield (data_dir, case_file)
配合del显式删除上一例的图像数组,并在循环后手动触发gc.collect()回收残存引用,内存峰值能稳定在一个病例的水平,这是单机批量处理时最核心的优化手段。
超大影像的滑窗分块策略
少部分影像(如高分辨率MRI或全脏器病理切片转换的NIfTI)体素数量超过千万,此时应放弃一次性读入整体特征计算,改用滑动窗口分块策略:每次只读取一个子块(例如128×128×64),提取局部纹理特征后合并结果,PyRadiomics的ROI提取接口允许传入局部掩膜,操作路径为先切分掩膜与图像为对应分块,再逐块调用feature extractor,最后汇总,该方案能让超大影像的内存占用从不可完成降至可控范围。
特征降维:少算才是真的省内存
灰度离散化:所有纹理特征的内存开关
设置binCount参数控制灰度直方图的bin数量是减少GLCM矩阵规模最直接的手段,默认32个bin时GLCM为32×32,提升到64则矩阵变为64×64,但内存消耗随之变成原来的4倍。多数情况下binCount设为32即可保留足够的纹理区分度,完全没必要追求128或256,这个参数直接控制纹理特征的内存基数,必须在批量运行前固定下来。
按需提取特征类,不跑空转
PyRadiomics默认提取全部七大类的数百个特征,很多场景下只需要shape + firstorder + glcm三类,在配置文件中显式关闭不需要的类:
featureClass:
  shape: []
  firstorder: []
  glcm: []
  glrlm: []
  glszm: []
  gldm: []
  ngtdm: []
这个设置会跳过多余特征矩阵的构建和计算,内存下降幅度通常是50%以上,同时在setting中关闭additionalInfo=True,避免为每个特征生成完整描述文本占用的临时内存。
并行与分布:多进程下的共享内存陷阱
多进程并行时的内存复制问题
有些研究者用joblib或multiprocessing并行处理多个病例,发现CPU核数上去了内存反而爆得更快,这是因为多进程模式下每个进程都会复制一份完整的Python环境,numpy数组在进程间传递需序列化或复制,正确的做法是只并行特征计算部分,不并行数据加载部分,具体操作路径为:主进程读入图像和掩膜,然后使用ProcessPoolExecutor将特征计算函数分发到各worker,各worker只接收图像数组的引用地址和掩膜数据,不重新加载文件,这样内存增长是随核数线性增长,但由于去掉了文件IO的重复读取,整体增速慢得多。
内存映射文件(mmap)在分布式场景中的价值
当病例规模达到数千例时,单机内存完全不够用,此时可以借助numpy的内存映射模式读取影像,将数组驻留区域映射到磁盘而非物理内存:
image_mmap = np.load('case_array.npy', mmap_mode='r')
PyRadiomics的SimpleITK读取接口支持从内存映射对象构建图像,这样超大数组不占用RAM,仅按需读取体素数据参与计算,物理内存占用被压缩到极低水平,配合多节点分布式调度器(如Dask),可以实现千例级影像组学特征提取的云端运算。
实战验证:一台16GB内存机器跑通300例影像
在一台标准科研配置(16GB内存、6核CPU)机器上进行过压测,300例肺部CT,每例尺寸512×512×约250层,优化前直接运行PyRadiomics默认配置,跑到第47例时内存用尽崩溃,优化后的配置组合如下:
inputImage和inputMask以int16和uint8读入binCount设为32- 特征类只开shape + firstorder + glcm
- 循环使用生成器 + 显式
del
+
gc.collect() - 并行使用
ProcessPoolExecutor只分发计算任务
最终全程内存峰值稳定在5.2GB以内,300例数据耗时约2.5小时跑完,未再出现MemoryError,单例内存占用从平均1.8GB降至45GB以下,证明这套优化方向完全有效。
影像组学特征提取内存不足时的排查顺序
遇到内存溢出,按以下顺序逐一排查并修复:
- 监控当前内存占用 使用
memory_profiler库逐行定位内存增长点,确认是图像数组还是矩阵计算占大头。 - 核查dtype 确认图像与掩膜在传递过程中未被隐式转换为
float64,如已转换立即改回压缩类型。 - 检查特征配置 确认未启用的特征类已被注释关闭,
binCount未设置过高。 - 修改循环结构 将
for循环内所有中间变量显式del,并引入生成器替代全量列表。 - 尝试分块读取 若单例图像本身超过2GB,直接采用滑窗分块方案。
- 评估单机极限 单一影像数据量极大的情况下,及时切换至分布式方案例如Dask或Spark医学影像生态。
影像组学特征提取相关疑问解答
影像组学特征提取内存不足时,最优先调整哪个参数?
最优先调整binCount灰度离散化参数,该参数从数学上直接控制GLCM等纹理矩阵的规模,从默认值下调至32或更低,能够立刻减少矩阵构建时的内存激增,它不影响图像读取驻留部分,但对总内存高峰的影响权重最大。
批量处理影像组学数据时,内存持续缓慢增长如何解决?
内存持续增长几乎可以断定是循环迭代中变量未被释放,在每次循环末尾执行del image_array, mask_array并调用gc.collect()回收循环引用,同时将数据读取封装成生成器,确保每次处理一例且仅保留一例的驻留数据,据团队压测,此操作可将批量运行的内存曲线从持续上升变为平稳直线。
PyRadiomics并行提取特征如何避免内存复制过度消耗?
不直接在worker进程内部加载图像文件,而是先把图像读入主进程并通过内存映射(mmap)方式只读打开,将文件路径或映射对象传给worker进程读取,这样worker间共享同一份物理内存中的映射区域,而非彼此复制整个数组,统计结果显示并行时内存增量能控制在单例内存的15%以内。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/707629.html