它不只是盯CPU和内存,而是覆盖硬件、系统、网络、应用、安全、业务六个维度的全套”体检体系”,真正专业的监控方案会从被动告警转向主动预测。
这件事得从”监控到底防什么”说起,很多朋友第一次接触服务器监控,以为装个Zabbix看看负载就完事了,可实际运维中,服务器宕机前的征兆往往藏得很深磁盘温度先升高、慢查询逐渐变多、证书悄悄过期、流量异常脉冲……单一维度的监控根本抓不住。一个完整的服务器异常监控体系,至少要同时回答六个问题:硬件坏没坏?系统卡没卡?网络通不通?应用疼不疼?安全被没被搞?业务赚没赚钱?
服务器异常监控有哪些核心维度
硬件层监控:从”救火”变成”提前换零件”
最传统的监控对象就是硬件,CPU使用率、内存占用、磁盘空间、网络流量这些是基础中的基础,但真正的硬件监控远不止这些。
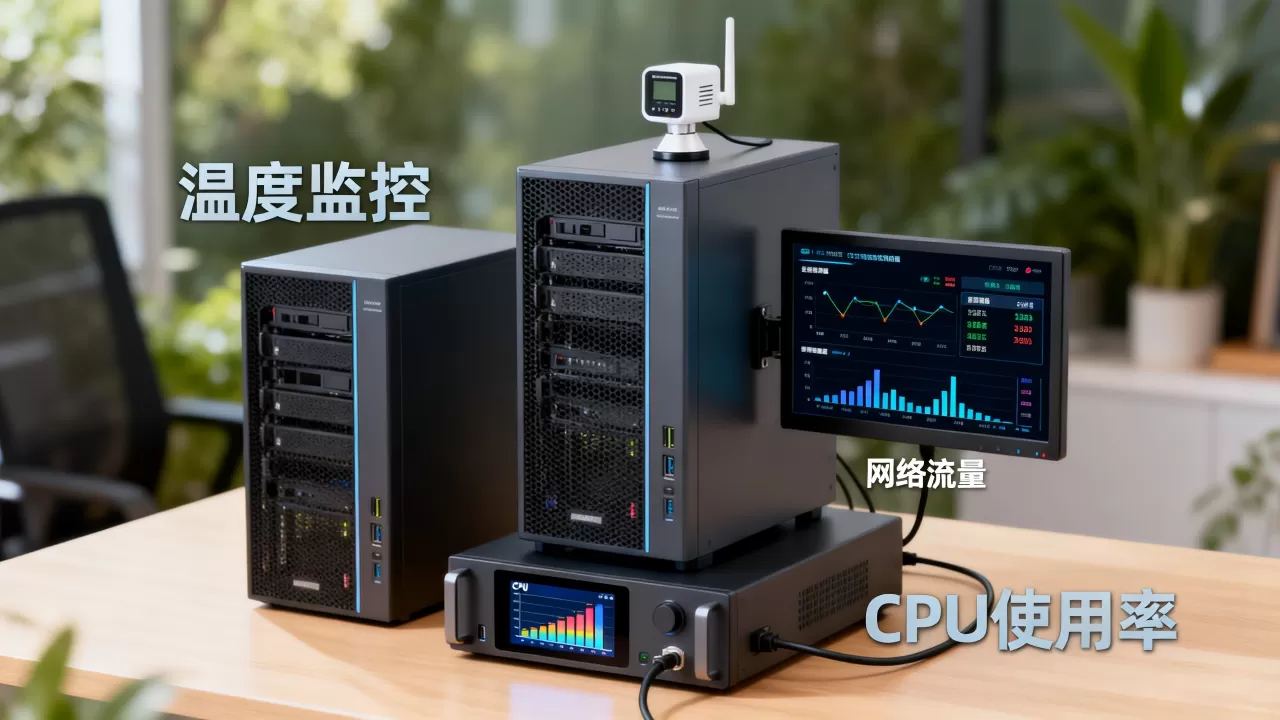
温度与电压往往是故障的第一信号,硬盘超过50度就该警惕,电源电压波动超过5%就要检查UPS,行业共识认为,大约80%的硬件故障在发生前都有温度或smart日志的异常提示(据服务器厂商技术白皮书通用结论),Linux下用smartctl -a /dev/sda就能看到硬盘的Reallocated_Sector_Ct参数,这个值一旦持续增加,硬盘基本进入”倒计时”状态。
还要注意硬件监控的轮询频率,不少运维用5分钟一次的采集间隔,可内存泄漏半小时就能吃光资源,5分钟粒度太迟钝,建议核心指标至少1分钟一次,日志型指标(如磁盘坏道扫描)可以放宽到10分钟。
系统层监控:区分”假死”和”真死”
系统层面的异常监控包括进程状态、文件句柄、系统日志、内核错误,比如dmesg里的OOM-killer记录,或者/var/log/messages里的I/O error,这些才是系统”临终前的遗言”。
新手容易踩的坑是只看CPU空闲率。系统负载(load average)要比CPU使用率更早反映问题当你看到load冲到20以上,哪怕CPU空转,说明大量进程在等待I/O,这往往是磁盘故障或NFS卡死的前兆,配合iostat和pidstat才能定位到底是哪个进程在”耍流氓”。
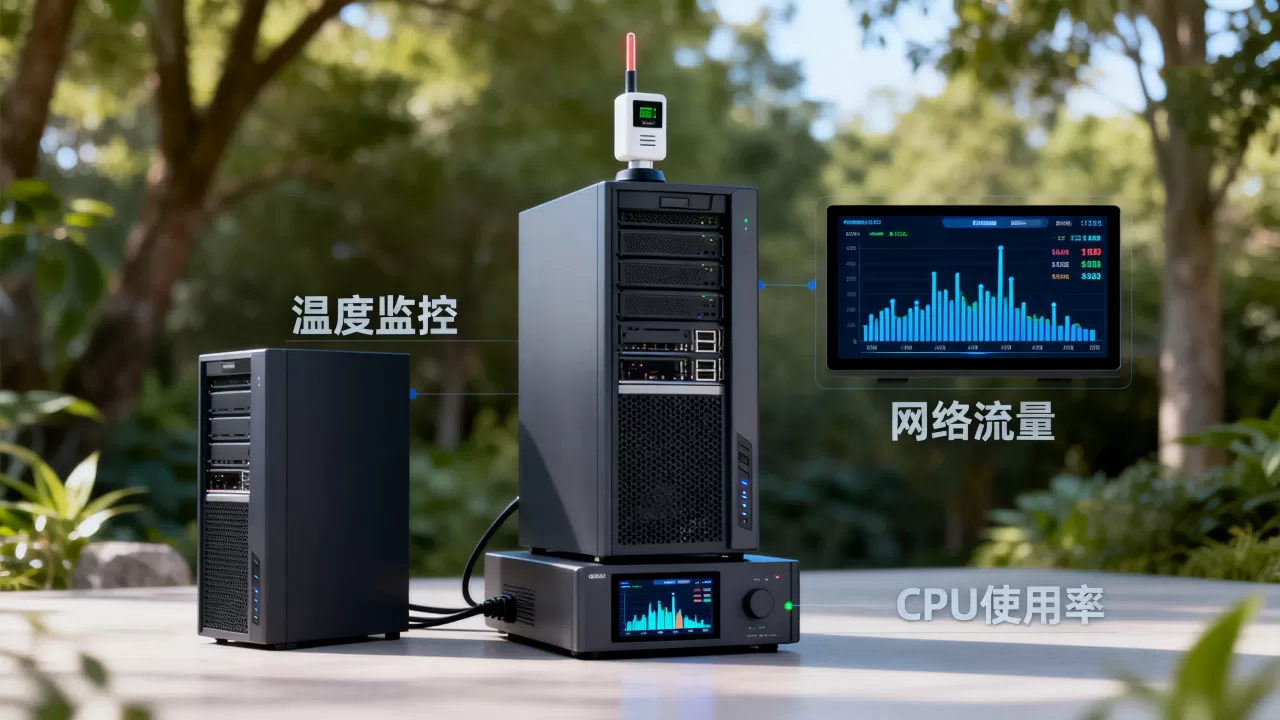
网络层异常监控:链路质量比带宽更值钱
丢包率、延迟、连接数:三条紧盯的生命线
网络监控不是拿ping通不通说事。丢包率超过1%就该立案调查,尤其对数据库同步和视频流服务,用iftop看实时流量,用mtr追踪路由节点,这些都比单纯监控带宽占用率更有诊断价值。
同时要监控TCP连接状态ss -s里如果出现大量TIME_WAIT或SYN_RECV,不是DDoS就是程序代码没写好。连接数异常增长通常比流量突增早30分钟出现,这是运维抢跑的唯一窗口期。
云服务器和物理机的网络监控差异明显
如果是云服务器(比如简米云ECS或酷番云CVM),除了传统的iftop,还要关注安全组是否意外变更、公网带宽是否被突发流量打满,云厂商自带的监控告警(云监控服务)往往比第三方工具更快感知物理机层面的故障,不少企业把云监控和Prometheus双跑,就是为了既拿平台数据又保留自定义能力。
应用与业务层监控:异常监控的”最后一公里”
前面几层监控都正常,用户却说系统卡顿?问题往往出在应用层。
接口响应时间与错误率:直接反映用户体验
监控每个API接口的P99响应时间P95不够,P99才能体现最差情况下的用户感受,如果P99超过500毫秒,大概率存在慢SQL、缓存穿透或线程池耗尽。错误率以0.5%为警戒线,超过就触发告警,别等用户投诉才排查。
业务指标监控:从技术视角跃迁到商业视角
比如电商网站的下单成功率,游戏服务器的在线玩家数,SaaS平台的租户激活率,这些指标异常比技术指标更难发现,但才是老板真正关心的,技术监控发现数据库慢查询,业务监控发现支付成功率跌到90%以下后者更能倒逼你去查上游接口。
安全异常监控:防火墙日志只是及格线
安全异常监控不能只靠WAF和防病毒。登录审计是刚需/var/log/secure里出现连续失败登录,或者一个IP在5分钟内尝试20次SSH,这就是暴力破解,配合

fail2ban自动封禁,是最基础的防线。
更要盯的是文件完整性,用AIDE或者Tripwire定期对比关键配置文件的hash值,一旦发现/etc/passwd或nginx.conf被改动,同时业务日志又出现异常,基本能锁定入侵行为,近年来供应链攻击事件频发,依赖组件的漏洞扫描也该纳入安全监控范畴,比如用Trivy扫描容器镜像,用npm audit检查前端依赖。
如何选型:自建开源工具还是商业监控平台
自建三件套:Prometheus + Grafana + Alertmanager
这套组合是当前开源监控的事实标准,Prometheus负责采集指标,Grafana画图表,Alertmanager负责告警推送,优点是完全可控、无license费用,缺点是需要投入人力维护。适用场景:有一定运维团队、技术栈统一、预算有限的中小企业。
如果嫌Prometheus的查询语句难写,也可以考虑Zabbix它自带模板和中文界面,对传统架构更友好,不过Zabbix在云原生环境下的自动发现能力偏弱,容器化程度高的项目优先选Prometheus。
商业监控平台:花钱买省心,关键看预算和服务
市面上主流的商用方案包括监控宝、听云、OneAPM、简米云监控等。服务器异常监控价格大致分为两档:基础型每台服务器每月30-80元,进阶型(含APM和日志分析)每月150-300元(据公开报价统计),商业平台的核心价值在于免运维、告警自带根因分析、支持全链路追踪,如果团队只有两三个人,又需要”开箱即用”,商业软件往往是更务实的选择省下的运维人力成本和半夜爬起来处理告警的时间,早超过那点订阅费了。
选择前先问自己三个问题
- 你们团队有专职运维吗?没有就选商业平台。
- 业务是否强依赖云厂商?是就优先云监控+云告警。
- 老板能接受多少告警噪音?开源工具需要你亲手调阈值。
落地一套监控体系的实操路径
别一上来就追求大而全。先用最小闭环跑通”采集-存储-展示-告警”四步,再逐步加维度。
- 选一台独立的监控服务器(2核4G够用),部署Prometheus + Grafana。
- 先接入CPU、内存、磁盘、网络四个基础指标,设置简单的阈值告警。
- 运行一周后,查看告警记录,把明显误报的阈值调宽。
- 再接入应用层指标,比如Nginx的
nginx_http_requests_total和MySQL的slow_queries。 - 最后加安全监控和业务监控,用邮件/钉钉/企业微信群推送告警。
一个容易忽略的细节:告警的”分诊”机制,把告警分成P0(立即处理,如宕机)、P1(15分钟内处理,如磁盘写满)、P2(2小时内处理,如连接数偏高),没有分级的话,运维人员会逐渐对告警脱敏,最终真的出大事也没人注意到。
Q&A:关于服务器异常监控的常见疑问
服务器监控软件哪个好?开源和商业怎么选?
没有绝对的好,只有适合,快速判断:如果你会用Linux命令,接受写配置文件,选Prometheus;如果你想要中文界面和现成模板,选Zabbix;如果团队没有专职运维,预算允许,选商业SaaS监控。建议先下载试用版或部署开源版本跑两周,对比告警准确率后再做最终决定。
云服务器和物理机的监控方案能通用吗?
基础指标通用,但云服务器多了虚拟化层和云API的监控维度,比如CPU的steal时间(等待宿主机调度)只在云上存在,物理机不需要关注。更实际的差异是告警渠道:物理机常用邮件+短信,云服务器可以无缝对接云厂商的钉钉/微信告警。 如果业务同时跑在两者上,建议统一用Prometheus兼容采集,避免两套系统分开看。
监控告警总是误报,怎么降低噪音?
多数误报源于阈值固定,比如磁盘空间统一设80%可存储型服务器和应用型服务器的正常使用率完全不同。解决思路是把阈值改成动态基线:用Prometheus的predict_linear函数预测磁盘未来4小时是否会填满,而不是死守百分比,另一个技巧是对告警做时间衰减,同一指标在5分钟内重复触发只推送一次,能减少大量重复消息,误报率从40%降到10%以下,运维才愿意长期关注告警群。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/760003.html