量化回测中,海量tick数据读取的核心瓶颈在于文本格式的逐行解析与磁盘随机访问,优化最快的方式是转换为列式二进制存储并配合内存映射读取。
为什么tick数据读取会拖慢整个回测?
tick数据不只是“大”,而是“多文件+高频次”
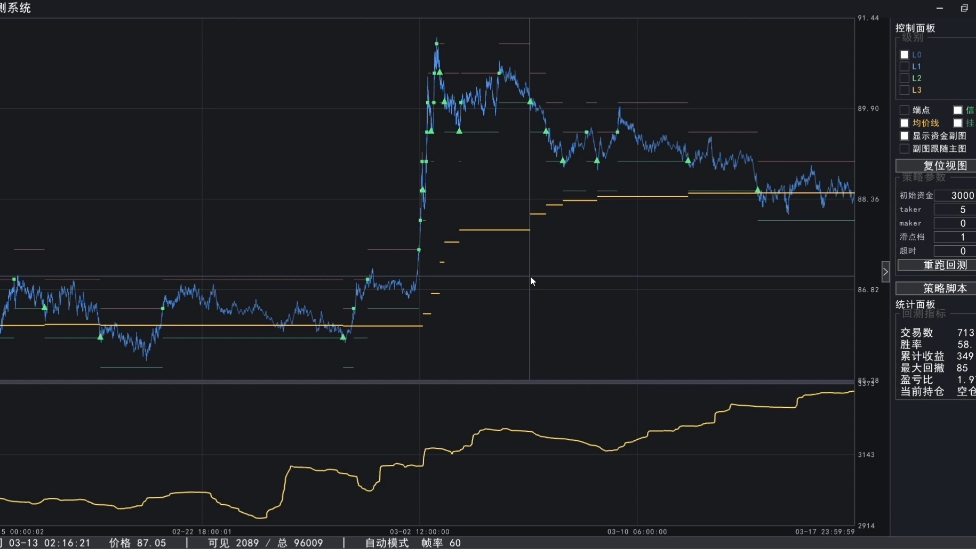
每个A股交易日,单只活跃股票的tick数据就有几万条到几十万条,全市场多年份累计下来,轻松达到数十亿条,你本地保存的tick数据,往往是按日期、按合约拆分的上千个CSV文件,每个文件几十MB到几GB不等,回测引擎启动时,第一件事就是把所有这些碎片文件读进内存,行业共识认为,多数个人量化策略在tick级回测时,数据读取时间占总回测时间的比例相当大,甚至超过策略计算本身。

文本解析是CPU杀手
CSV是tick数据最常见的原始存储格式,但也是最低效的,每一条记录都需要按逗号切分、去掉引号、把字符串转成数字、解析时间戳,逐行读取时,CPU大量时间花在文本解析上,而不是在计算信号,更麻烦的是,CSV文件通常没有索引,想按时间窗口提取一小段数据,也得从头扫到尾,这种“全量解析+全量扫描”的模式,在数据量上来后直接卡死。
随机访问与全量扫描的矛盾
回测逻辑经常需要按时间顺序“播放”tick,但预处理步骤又需要随机跳转读取,机械硬盘的随机IO性能极低,即使换到普通SSD,频繁的小块随机读取也会造成大量IO延迟,一个典型的回测循环中,如果每次只取某个时间点的tick,文件系统不得不反复定位,这是多数人忽略的隐藏瓶颈。
tick数据读取优化有哪些实操路径?
第一步:把CSV换成分列式二进制格式
Parquet和Arrow是目前量化圈用得比较多的选择,Parquet按列存储,支持压缩、谓词下推和列裁剪,比如你的回测只需要时间、价格和成交量三个字段,Parquet可以直接跳过其他字段的读取,而CSV必须整行读进来再丢弃,HDF5也可以,但在并发读写和列裁剪上不如Parquet灵活。
实操做法:用Polars或PyArrow编写一次性转换脚本,把旧CSV批量转成Parquet,按日期或交易标的做分区。
import polars as pl
pl.scan_csv("raw_tick_20260102.csv").sink_parquet("tick.parquet")
之后读取时,只加载需要的列:
import pyarrow.parquet as pq
table = pq.read_table("tick.parquet", columns=["ts", "price", "volume"], filters=[("ts", ">", "2026-01-02 10:00:00")])
第二步:用内存映射替换标准read
传统read_csv()会把文件全部内容拷贝到用户空间,再逐步解析,而内存映射(mmap)直接让文件映射到进程的虚拟内存地址,数据按需从磁盘换入,省去了IO路径上的用户态复制,PyArrow的pq.read_table()默认就支持内存映射;手动读二进制文件时,也可以用Python的mmap模块,配合操作系统的page cache,多个回测进程还能共享同一份物理页,内存占用不重复。
需要注意,mmap并不意味着整个文件瞬时读入内存,而是按页惰性加载,首次触碰某个数据页时依然会触发磁盘IO,但后续重复读取同一页就快很多,把mmap和按时间窗口预取结合起来,效果更明显。
第三步:并行分片读取
单个大文件顺序读取时,单个CPU核的解析速度就成了上限,将tick数据按日期或连续时间区间切分成多个分片,每个分片交给一个线程或进程读取,之后在回测引擎内部按时间合并,要注意的是,并行读时要给每个分片独立的文件句柄,否则共享句柄内部的偏移量会互相干扰,如果你用Polars的scan_parquet,可以依赖其底层多线程读取,不需要自己写分片逻辑。
在回测循环中,还可以采用“预加载下一批、计算当前批”的生产者-消费者模式,数据读取和策略计算重叠起来,等待IO的时间就被隐藏了。
第四步:降采样与预聚合
不是每个策略都需要全量tick,对于分钟级或日级信号,完全可以在tick基础上先合成1秒或1分钟的快照,统计上,降采样后的数据量可能减少几个数量级,读取速度的提升比任何存储优化都直接。
具体做法:构建数据预处理流水线,在原始tick入库后立即生成多个粒度的中间表,
- 每笔tick原始留存,用于高频微观结构分析
- 1秒/1分钟/15分钟OHLCV,用于常规回测
- 盘口快照最高价/最低价/加权均价,用于事件驱动策略
回测引擎根据策略时间粒度,自动选择最粗但足够的数据源,避免每次都压榨全量tick。
tick数据存储格式对比:CSV、HDF5与Parquet哪个更适合回测?
我把三种常见格式放在一起对比,帮助你直接做决定。
| 维度 | CSV | HDF5 | Parquet |
|---|---|---|---|
| 读取速度 | 慢,逐行解析 | 中等,需搭配h5py | 快,列存+压缩 |
| 压缩率 | 低,明文存储 | 中等 | 较高,支持多编码 |
| 列裁剪能力 | 无,全行扫描 | 有限 | 原生支持谓词下推 |
| 并行读取 | 困难 | 有限 | 支持多线程/分片 |
| 生态兼容性 | 所有工具通用 | 科学计算为主 | 大数据生态广泛支持 |
| 推荐场景 | 小样本临时分析 | 中等规模结构化数据 | 海量tick长时间回测 |
业内专家指出,单纯把CSV改成Parquet,在包含数亿条tick的数据集上,读取耗时往往能缩短到原来的几分之一甚至更低,但前提是分区和过滤条件设置得当,如果数据量再上几个台阶,还可以考虑引入Delta Lake或ClickHouse这类支持更精细数据管理的方案。
本地tick数据回测提速的实战步骤
先检查你的数据现状
在动手优化前,先回答三个问题:当前数据总量是多少GB?文件总数是多少?回测时实际用到的字段有多少个?用命令快速摸底:
du -sh /data/tick/raw/
find /data/tick/raw/ -name ".csv" | wc -l
关注这两个结果,如果总量超过几十GB,且文件数超过几百个,那么读取瓶颈几乎必然存在。
编写转换脚本,确认数据一致性
不要直接删原始CSV,先写脚本,用Polars或PyArrow批量读取,输出Parquet分区,转换后,随机抽几个时间段的字段值,和原CSV比对,确认时间戳、价格、成交量没有偏差,这一步能避免后续策略结果失真。
改造回测引擎的数据接入层
找到回测框架中加载数据的入口,把原来的read_csv改成scan_parquet或pq.read_table,如果用的是自定义回测引擎,建议实现一个统一的“TickDataReader”接口,内部支持列选择和过滤,尽量把数据加载和策略逻辑解耦,后续调整IO层时不需要碰策略代码。
用计时工具量化提升效果
在回测主流程前后加上time.time()记录,或者直接使用Python的cProfile,重点关注两个指标:数据加载耗时和总回测耗时,对比优化前后的耗时差异,如果不明显,检查是否命中分区过滤和列裁剪,你按日期分区,但查询条件里没有指定日期范围,Parquet依然会扫描全部分区。
注意避免伪优化
有些优化看起来有效,实际上把问题转移了,比如把所有数据一次性加载到内存后,虽然读取速度很快,但内存占用过高,触发了swap,此时应该改为按时间窗口分块读取,而不是盲目“全量驻留”,同理,多线程读取时,如果磁盘本身是普通HDD,并行读反而会因为磁头频繁寻道而变慢,硬件升级优先级低于软件方案,但硬盘的类型直接影响优化上限。
量化回测海量tick数据读取瓶颈如何定位?
为什么换成Parquet后回测还是慢?
常见原因是分区键没有和查询条件对齐,只按日期分区,但策略经常按“分钟窗口”过滤,分区裁剪失效,另一种情况是,读取时使用了read_parquet但没指定columns,导致列裁剪未生效,检查一下你的读取代码,是否仍然加载了所有字段。
内存不够装下全部tick怎么办?
采用流式读取和窗口滑动的策略,把tick数据按小时或交易日分块,回测引擎只保留当前窗口的一块数据,计算完就释放,再加载下一块,Parquet按row group划分,天然支持分块读取,也可以使用Arrow的chunked array,但本质上依然要控制单次驻留数据量。
tick回测速度和哪些硬件因素关系最大?
磁盘类型、内存带宽和CPU核心数都会影响,普通SSD对比机械硬盘,随机读取性能可能有数量级差别,但如果软件层还是文本逐行解析,再快的SSD也无法弥补,软件优化到位后,NVMe固态硬盘和足够的内存容量能明显改善回测体验,但核心瓶颈往往不在硬件,把存储格式和读取方式处理好,tick回测的数据加载时间通常能压缩到可接受的范围内,真正的算力才能用在策略研究上。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/764895.html