服务器RAID1看磁盘坏道,核心不是只看阵列灯,而是同时查阵列日志、成员盘SMART和系统内核报错;阵列“正常”只代表冗余状态,不能替代坏道判断。
RAID1把两块盘做成镜像,一块盘读写异常时,另一块还能顶住,问题在于,坏道往往先于掉盘出现,硬件RAID还会把物理盘藏在阵列卡后面,系统里看到的/dev/sda不一定是某块成员盘,先备份,再查阵列卡工具和SMART,才不容易误判。
服务器RAID1磁盘坏道怎么检测:先看阵列状态,再读SMART
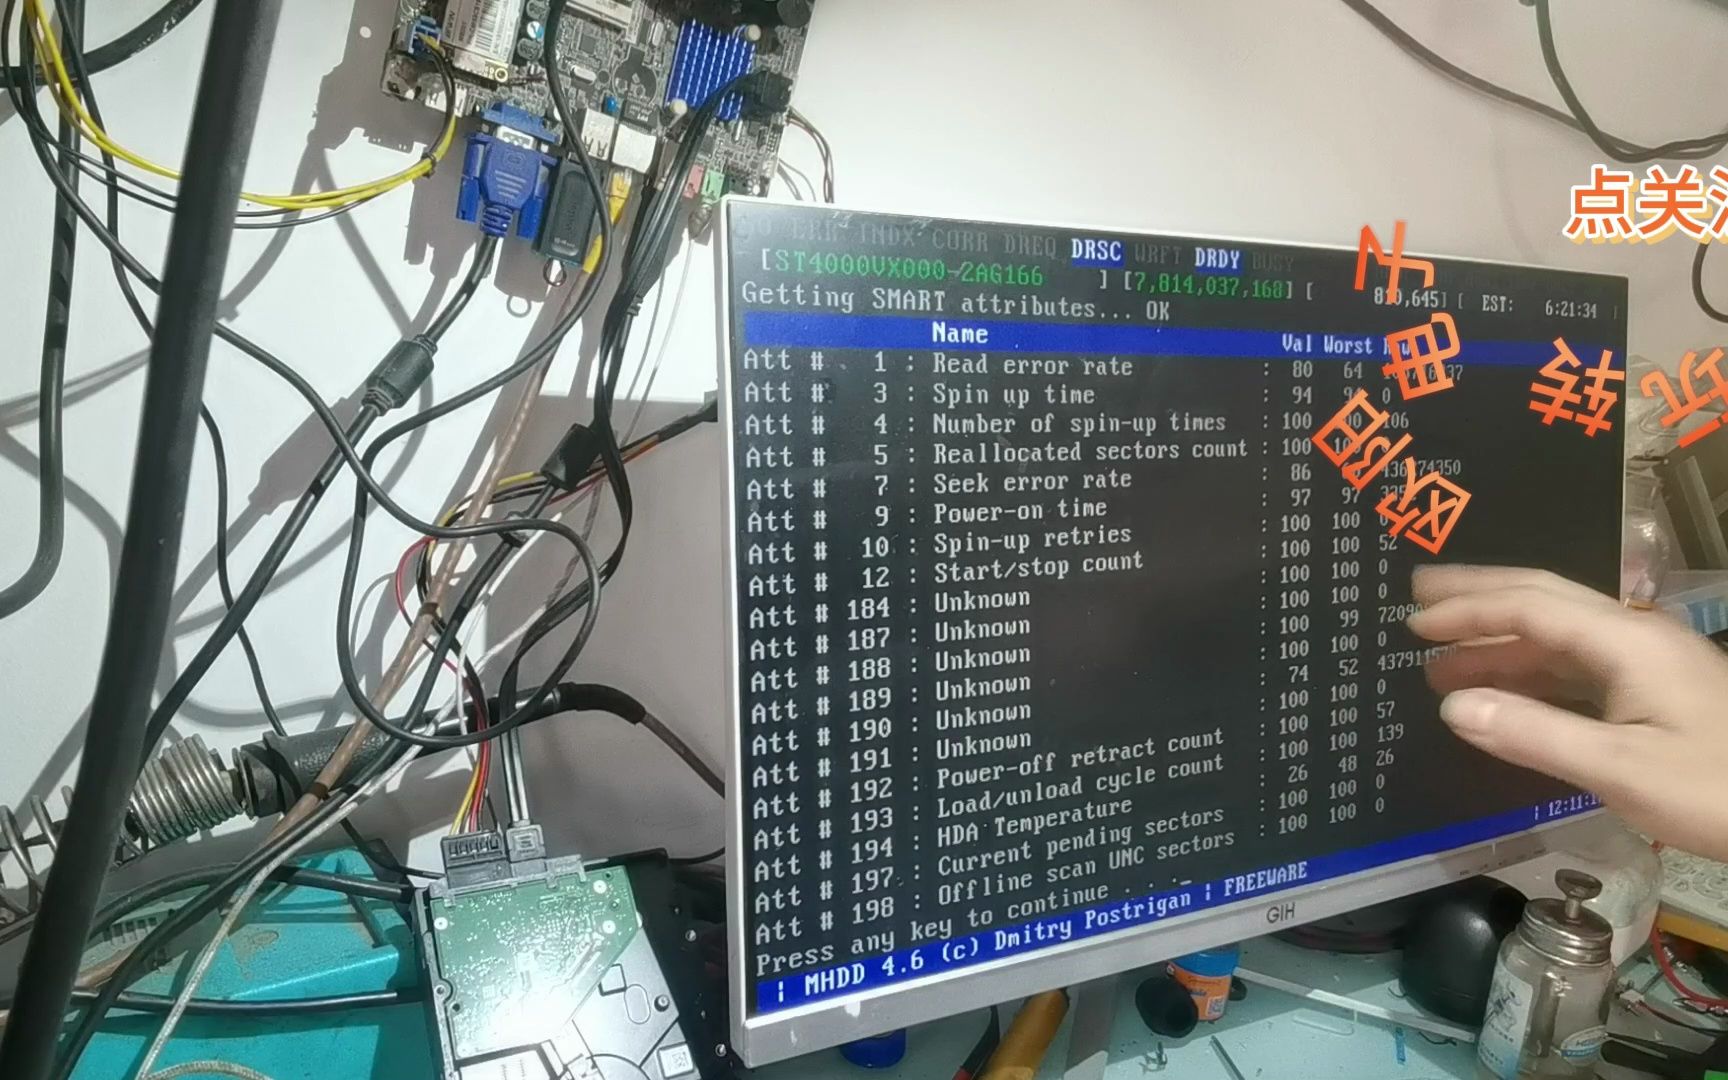
检测顺序可以固定为:阵列状态、成员盘媒体错误、SMART属性、内核日志、表面扫描,生产环境不要一上来就对整盘做写测试。
硬件RAID:用厂商工具把成员盘“点名”
常见阵列卡有LSI/Broadcom、Adaptec、HPE Smart Array等,先确认控制器和物理盘列表,再看每块盘的媒体错误计数。
- LSI/Broadcom:
storcli /c0 show、storcli /c0/eall/sall show all、storcli /c0/vall show - MegaRAID旧工具:
megacli -PDList -aALL,重点看Media Error Count、Other Error Count、Predictive Failure - Adaptec:
arcconf getconfig 1 PD - HPE:
ssacli ctrl all show config detail - 重建进度:
storcli /c0/eall/sall show rebuild
SMART要透传读取,LSI常见写法是smartctl -d megaraid,N -a /dev/sda,其中N是物理盘Device Id,部分SATA盘用smartctl -d sat+megaraid,N -a /dev/sda,读不到就换设备号,不要猜。
软件RAID:mdadm和SMART一起看
Linux软RAID1先看阵列,再看每块物理盘。
cat /proc/mdstatmdadm --detail /dev/md0lsblk -o NAME,SIZE,MODEL,SERIALsmartctl -a /dev/sdXsmartctl -t short /dev/sdX,随后smartctl -l selftest /dev/sdXdmesg -T | grep -Ei 'medium|error|ata|scsi|reset|uncorrect'
只读表面扫描可用badblocks -sv /dev/sdX,不要加-w,写测试会破坏数据,必须离线并确认盘内无业务数据。
SMART关键属性看哪些
| 属性 | 含义 | 风险提示 |
|---|---|---|
| Reallocated_Sector_Ct | 已重映射扇区 | 非零且持续增长要安排换盘 |
| Current_Pending_Sector | 待映射扇区 | 读取不稳定,优先备份 |
| Offline_Uncorrectable | 离线不可纠正 | 坏道风险高 |
| Reported_Uncorrect | 不可纠正错误 | 结合内核日志判断 |
| Command_Timeout | 命令超时 | 盘体或链路都可能异常 |
| UDMA_CRC_Error_Count | 链路CRC错误 | 先查线缆、背板、插槽 |
行业共识认为,Current_Pending_Sector比“已重映射计数”更能反映当前读取稳定性,据公开的SATA/SAS规范与硬盘厂商SMART文档,待映射扇区表示盘片读取已经不稳,应尽快做数据备份。
硬件RAID、软件RAID、云盘查看入口对比
| 环境 | 先看什么 | 成员盘SMART | 注意 |
|---|---|---|---|
| 软件RAID1 | /proc/mdstat、mdadm --detail |
smartctl -a /dev/sdX |
盘符就是物理盘 |
| 硬件RAID1 | 阵列卡工具、媒体错误计数 | smartctl -d megaraid,N |
不能直接对系统盘做整盘扫描 |
| 云服务器RAID1 | 云监控、内核日志 | 多数不暴露物理SMART | 先做快照再排查 |
RAID1硬盘坏道和掉盘区别:别把“重建成功”当健康
坏道是盘还能上线,但部分扇区读写异常,掉盘是盘被阵列卡判为Failed或Offline,阵列进入降级,两者的处理节奏不同。
| 现象 | 阵列状态 | 风险 | 动作 |
|---|---|---|---|
| 坏道 | 可能正常,也可能降级 | 重建时失败、静默损坏 | 备份、换盘、复检SMART |
| 掉盘 | 常见降级 | 冗余丢失 | 确认故障盘后更换并重建 |
RAID1降级后不要反复插拔,先备份,再记录成员盘序列号,替换盘容量不能小于原盘,重建期间避免高负载,重建进度卡住或媒体错误上升,要立即停业务评估。
业内专家指出,RAID1的价值在冗余,不在预测坏道;重建才是风险窗口,多块盘同时出现待映射扇区时,不要强制上线,先联系数据恢复评估。
云服务器RAID1查看坏道:先分清云盘、软RAID和直通盘
云服务器上执行smartctl,可能直接报不支持,原因不复杂:云盘底层由云厂商做多副本,客户拿不到物理盘SMART,此时重点看云监控、系统内核日志和I/O延迟。
dmesg -T | grep -Ei 'error|timeout|reset|medium'journalctl -k | grep -Ei 'ata|scsi|nvme|error'iostat -x 1看await、%util和重试- 云盘支持NVMe直通时,再试
smartctl -a /dev/nvme0n1 - 先做快照,再换盘或迁移
如果云主机里自建了软RAID1,按mdadm流程查,如果是云盘自带冗余,底层坏道由云厂商处理,客户侧重点是备份、快照和I/O错误告警。
北京服务器RAID1坏道检测流程:现场看什么,修复要多少钱
北京机房和托管场景,先远程后现场,带外管理口能看阵列卡日志的,先远程采集,不能远程的,再安排驻场和备件。
- 通过IPMI/iDRAC/iLO进入带外,查看阵列卡事件日志。
- 记录控制器型号、固件版本、物理盘槽位和序列号。
- 用厂商工具导出
storcli、arcconf或ssacli日志。 - 备份业务数据,确认可停机窗口。
- 更换同容量或更大容量盘,执行重建。
- 重建后复检SMART、媒体错误和文件系统一致性。
服务器RAID1坏道修复要多少钱,通常分三块:检测人工、备件与重建、数据恢复,仅检测和换盘重建,费用看机房是否需上门、盘是否在保、阵列卡型号和容量,数据恢复要看坏道数量、是否多盘异常、是否有备份,价格差异较大,通常按服务类型报价,不以“坏道数量”单项计价。
服务器RAID1看磁盘坏道Q&A
RAID1阵列显示正常,还需要查坏道吗?
需要,阵列正常只说明镜像关系还在,SMART里的待映射扇区、媒体错误计数和内核I/O报错,往往早于掉盘出现,建议定期做短自检并保留日志。
发现坏道后能不能直接拔盘重建?
不能直接拔,先备份,再确认故障盘的槽位和序列号,硬件RAID要核对Device Id,软RAID要核对/dev/sdX,拔错盘会让阵列从降级变成彻底失效,多盘异常时先停写,联系数据恢复。
RAID1坏道修复要多少钱?
检测、换盘重建、数据恢复是不同报价项,是否上门、是否在保、盘容量和阵列卡型号都会影响费用,实际费用由检测结果、备件和人工共同决定,不以坏道数量单项计价。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/775347.html