容器网络出方向NAT端口耗尽,本质是SNAT源端口池被并发连接占满,排查先看节点或网关的conntrack与端口分配,治理靠连接复用、扩大出口IP和拆分出口,单靠调大端口范围只能缓一时。
先看清“端口耗尽”到底耗的是什么
Pod访问集群外服务时,数据包通常要经过一次源地址转换,节点上的iptables/nftables做MASQUERADE,或者流量被送到云NAT网关,都会把Pod IP换成节点IP或网关IP,转换后,内核还要分配一个源端口,让“源IP、源端口、目标IP、目标端口、协议”这个五元组保持唯一。
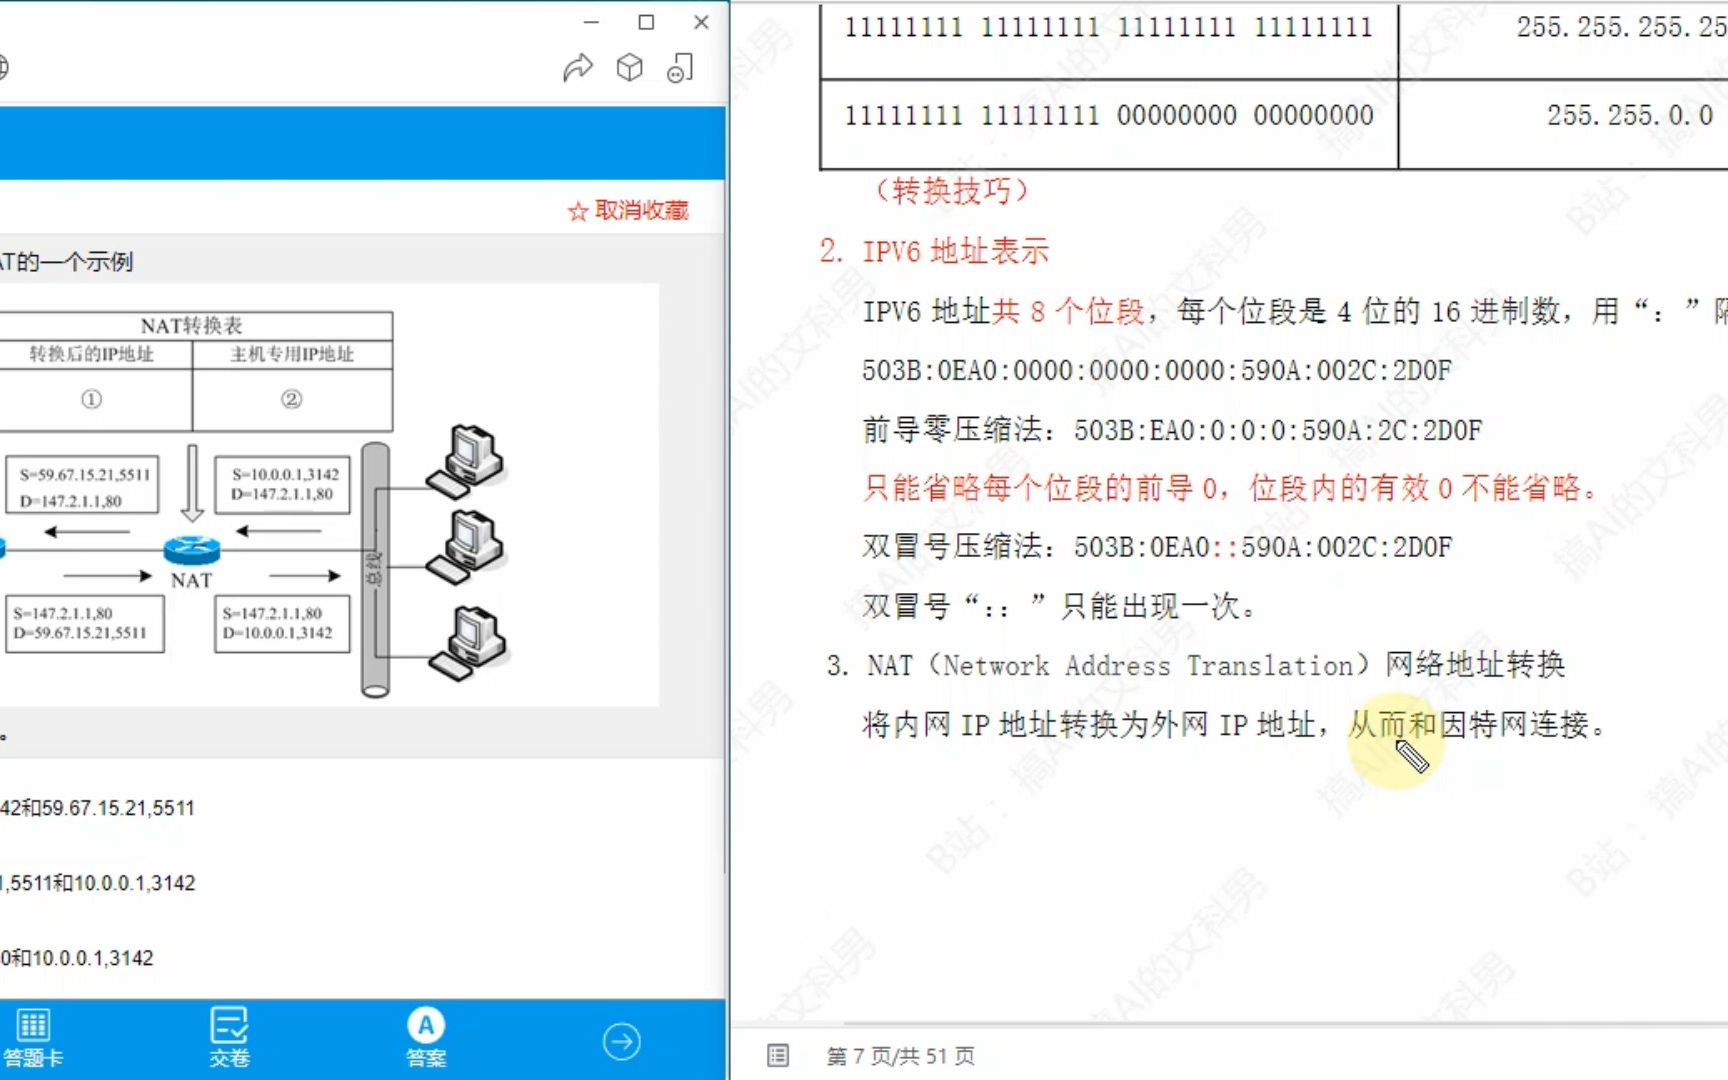
端口不是凭空没的,单个出口IP的可用源端口有限,Linux常见默认范围是32768-60999,据Linux内核文档,这个范围可通过net.ipv4.ip_local_port_range调整,容器密度一高、短连接一多,端口池很快被TIME_WAIT、CLOSE_WAIT和活跃连接一起占住。
SNAT端口池是怎么被占满的
- 每个到不同“目标IP+目标端口”的新连接,都要拿一个新的源端口。
- HTTP短连接、健康检查、DNS查询、日志上报、第三方API调用,都会反复建连。
- 连接关闭后,TIME_WAIT还会保留一段时间,端口不能立刻复用。
- 单节点跑几十个Pod,每个Pod再开几十个连接,端口消耗会被放大。
- 目标服务集中在少数IP上时,端口压力更明显。
业内专家指出,容器网络和传统虚拟机在出口连接密度上不是一个量级,排障时不能只盯Pod,还要看节点和网关的NAT表。
节点NAT与网关NAT,故障点不一样
| 对比项 | 节点SNAT | 云NAT网关SNAT |
|---|---|---|
| 端口池归属 | 节点IP与本地端口范围 | 网关SNAT IP与连接配额 |
| 常见现象 | 单节点新建连接失败,换节点可能正常 | 多节点同时受影响,网关侧超限计数上升 |
| 排查入口 | conntrack、iptables/nftables、ss | 云监控、NAT网关连接数、EIP |
| 扩容方式 | 加节点、加出口IP、调端口范围 | 加SNAT IP、升规格、拆网关 |
| 适合场景 | 中小规模、出口简单 | 多业务集中出口、需要统一审计 |
容器网络出方向NAT端口耗尽怎么排查:从现象到根因
先别急着重启,端口耗尽通常不是全站挂掉,而是“新建连接偶发失败,存量连接还能跑”,应用日志里可能出现cannot assign requested address、connect timeout、连接池获取超时,网关侧则可能看到SNAT连接数接近上限。
先确认现象与影响面
- 失败是否集中在某个节点、某个可用区、某个目标域名或IP。
- 是全部新建连接失败,还是只有高并发接口失败。
- 失败时CPU、内存、带宽是否正常,排除资源打满。
- 是否刚做过压测、扩缩容、健康检查频率调整。
- 应用是否大量使用短连接,连接池上限是否合理。
节点侧排查命令与路径
在节点上按顺序看这几项:
ss -s:看总连接数和TIME_WAIT数量。ss -tan state time-wait | wc -l:统计TIME_WAIT规模。cat /proc/sys/net/netfilter/nf_conntrack_count:当前conntrack表项数。cat /proc/sys/net/netfilter/nf_conntrack_max:conntrack上限。sysctl net.ipv4.ip_local_port_range:本地源端口范围。conntrack -S:看插入失败、无效包等计数,需安装conntrack工具。iptables -t nat -L -n -v或nft list ruleset:确认MASQUERADE规则和出口网卡。conntrack -L -p tcp | grep -o 'dst=[^ ]' | sort | uniq -c | sort -nr | head:看连接是否集中在少数目标。
如果nf_conntrack_count接近nf_conntrack_max,同时应用报新建连接失败,基本可以判断出口NAT压力已经很高,若conntrack没满但端口分配失败,重点看端口范围和目标集中度。
网关侧排查与临时缓解
云上环境先看NAT网关的SNAT连接数、端口分配率、新建连接速率和超限丢包计数,不同云厂商指标名称不同,但排查逻辑一致:连接数是否贴近规格上限,是否只有某个EIP吃满,是否某个业务在扫外部接口。
临时缓解可以这样做:
- 增加SNAT IP或出口节点,把五元组打散。
- 在业务低峰调整节点端口范围,写入
/etc/sysctl.d/99-nat.conf后执行sysctl -p。 - 适度提高
nf_conntrack_max,同时关注内存和hashsize。 - 对第三方调用做限流、重试退避和连接池复用。
- 把健康检查频率降下来,避免无意义短连接。
Kubernetes SNAT端口耗尽与iptables模式对比
Kubernetes里出方向NAT可能发生在多个位置:CNI插件、kube-proxy相关规则、节点MASQUERADE、云NAT网关,iptables模式依赖conntrack做NAT,排障时看iptables-save里的MASQUERADE和conntrack表比较直接,IPVS模式主要负责Service负载均衡,出集群的SNAT仍可能由iptables/nftables或CNI处理,不能简单认为换了IPVS就没有端口压力。
iptables/nftables与IPVS模式差异
- iptables模式规则链长,NAT和conntrack路径清晰,适合用
conntrack -L定位。 - nftables模式规则集更集中,排查看
nft list ruleset,老命令不一定能完整展示。 - IPVS模式在Service转发上性能更好,但出方向NAT仍要看出口规则和CNI实现。
- eBPF类CNI可能用独立NAT表,仍需监控端口分配和连接表,不要以为完全绕开限制。
实操检查kube-proxy与NAT规则
kubectl -n kube-system get cm kube-proxy -o yaml | grep mode:确认代理模式。iptables-save | grep MASQUERADE:看节点出口伪装规则。nft list ruleset | grep -i masquerade:nftables环境检查。ip route get <目标IP>:确认流量从哪块网卡出去。- 在Pod内
curl -v目标地址,同时在节点抓包,判断失败发生在建连前还是NAT后。
高并发短连接场景下,怎么把端口池用得更久
端口扩容是加法,连接复用是减法,两个方向一起做,才不会被业务增长迅速追平。
应用侧连接复用
- HTTP服务开启keep-alive,合理设置空闲超时。
- gRPC、消息队列、数据库使用长连接和连接池。
- 连接池上限不要只调大,要结合下游承载和超时设置。
- 对第三方API做批量合并、缓存和异步化,减少建连次数。
- 健康检查改成复用连接或降低频率,避免探测流量吃端口。
节点与网关调优
- 节点出口IP不足时,增加节点或给节点绑定多个出口IP。
- 云NAT网关按业务拆多个实例,避免一个网关承载全部出口。
- 适度扩大
net.ipv4.ip_local_port_range,但要知道单IP端口上限仍在。 - 调整conntrack超时参数要谨慎,TIME_WAIT过短可能带来协议异常。
- 对长连接和短连接分出口,避免短连接挤占关键业务端口。
监控与分流
监控至少覆盖conntrack使用率、SNAT端口分配率、新建连接失败率、TIME_WAIT数量、网关超限计数,告警不要等打满才报,接近上限前就分级处理,架构上可按目标域名、业务线、地域拆出口,静态资源走CDN,第三方调用走统一代理出口。
云上容器NAT网关端口耗尽怎么办:不同地域与架构差异
云上排障要先分清是“节点本地SNAT”还是“NAT网关SNAT”,托管Kubernetes的节点池如果直接走VPC路由到NAT网关,端口池在网关侧;如果节点自己做MASQUERADE,端口池在节点侧,不同地域的NAT网关规格、SNAT IP配额、可用区容灾方式可能不同,跨可用区集中出口还会带来额外跳数。
处理路径可以按这个顺序走:
- 在云监控确认NAT网关连接数、SNAT端口分配和EIP带宽是否触顶。
- 查清哪些命名空间、哪些工作负载在集中访问外部。
- 先做应用限流和连接复用,给端口池降压。
- 再评估增加SNAT IP、升规格或按可用区拆分网关。
- 涉及配额时走工单确认地域配额和扩容窗口,不要假设所有地域一致。
行业共识认为,集中式出口便于审计,但故障域也集中,多业务共用一个大NAT网关时要把配额和告警提前设计好。
容器NAT端口扩容价格与方案怎么选
扩容不是只看“加钱”,NAT网关通常按实例规格、连接数能力、EIP带宽或流量、公网IP数量计费;节点方案则看节点成本、出口IP和运维投入,具体价格随地域、计费方式和规格变化,应以云厂商公开计价页为准。
| 方案 | 适用情况 | 成本构成 | 主要风险 |
|---|---|---|---|
| 调大节点端口范围 | 单节点短连接突发 | 基本无新增费用 | 只能延后耗尽 |
| 增加节点出口IP | 节点级SNAT,规模中等 | 节点与EIP成本 | 调度不均仍会打满 |
| NAT网关加SNAT IP | 多业务集中出口 | 网关规格、EIP、流量 | 配额和故障域集中 |
| 按业务/地域拆网关 | 多租户、跨地域 | 多实例与运维成本 | 架构复杂度上升 |
| 连接复用与代理层 | 第三方调用多、短连接多 | 研发与代理层成本 | 改造周期较长 |
小规模先做连接复用和端口范围调整,中等规模优先加出口IP,多业务集中出口再考虑NAT网关拆分,价格敏感时不要只比实例费,要把EIP、流量、运维和故障损失一起算。
Q&A:容器网络出方向NAT端口耗尽常见问题
容器网络出方向NAT端口耗尽,为什么只影响新建连接?
因为已经建立的连接早已占好五元组,NAT表项还在,数据包可以继续转换,新建连接需要重新分配源端口,端口池没有空闲时就会失败,所以表现为“老连接能用,新连接偶发超时”。
扩大ip_local_port_range能彻底解决Kubernetes SNAT端口耗尽吗?
不能彻底解决,扩大范围只是把单IP可用端口变多,短连接增长、目标集中、出口IP不足时仍会耗尽,它适合做临时缓冲,长期还要靠连接复用、增加出口IP和拆分出口。
容器NAT端口耗尽和conntrack表满是同一回事吗?
两者相关但不等同,端口耗尽看的是源端口分配失败,conntrack表满看的是连接跟踪表项达到上限,实际故障中二者可能同时出现,排查时既要看nf_conntrack_count与nf_conntrack_max,也要看端口范围、TIME_WAIT数量和网关SNAT连接数。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/776361.html