超巨大服务器并非指某一台具体设备,而是指由数千乃至数万台服务器节点构成的超大规模数据中心集群,以及支撑其运行的软硬件基础设施,其核心能力体现在承载云计算、AI大模型和海量互联网业务的分布式计算架构上。
这类“巨无霸”通常不对公众直接出售,而是以云服务或算力输出的形式存在,下面从形态、组成、代表性项目与成本等维度拆解,帮你彻底搞清楚超巨大服务器的真实面貌。

超巨大服务器有哪些具体形态
超巨大服务器不是单台机器,而是以集群形态存在,按照使用场景和服务对象,主要分为以下三类。
云计算厂商的超级数据中心
这是最典型的超巨大服务器形态,简米云、酷番云、华为云等头部厂商在全球部署的“超大规模数据中心”,单个园区的服务器数量通常以十万台为计量单位。
- 这些数据中心内部通过高速网络互联,对外提供统一的算力接口
- 用户购买的云服务器,其实是这些物理资源中的一部分虚拟化切片
- 园区内包含制冷系统、电力系统、网络设备和运维团队,整体构成一个“服务器母体”
国家超算中心与智算中心
这类设施代表当前算力的最高天花板,国家超级计算中心(如天津、广州、深圳中心)和各地新建的人工智能计算中心,属于专门用于科学计算和大模型训练的“超巨大服务器”。
- 它们更像一座“算力工厂”,专注于高密度计算任务
- 内部使用大量GPU加速卡或专用处理器,整机柜级互联
- 主要服务科研机构、高校和企业研发部门
大型互联网公司的自建集群
头部互联网公司内部部署的超巨大服务器集群,支撑着数亿用户的日常使用,这类集群不对外提供服务,属于企业核心资产。
- 支撑搜索引擎、短视频推荐、电商交易等实时业务
- 规模庞大,可能在多个城市分布,通过专线互联形成“逻辑整体”
- 技术栈高度定制,涉及自研服务器、交换机、AI训练框架等
超巨大服务器性能怎么看
评估一套超巨大服务器系统的能力,不能只看单个CPU或GPU型号,必须关注整体架构指标。
算力规模的核心指标
业界通用衡量标准是浮点运算能力(FLOPS),以及最近兴起的AI算力(以PFLOPS为单位),一个典型的大型智算中心,其AI算力通常在百P(每秒百千万亿次)到万P规模之间。
- 看总算力:衡量系统能承担多大的计算任务
- 看存储容量:Exabyte(EB)级别的存储系统在超大规模数据中心已不罕见
- 看网络带宽:内部网络速率从100GbE(千兆以太网)向400GbE、800GbE升级,用于减少数据交换延迟
能耗与散热是核心限制因素
超巨大服务器的功耗极其惊人,一个大型数据中心园区的年耗电量可相当于一座中等城市居民用电总和,因此PUE(电源使用效率)是衡量其优劣的关键指标。
- 行业共识认为,PUE低于1.2属于优秀水平
- 近年来的新建大型数据中心普遍采用液冷散热方案,取代传统风冷以应对高功耗芯片
- 选址多靠近电力资源丰富或气候寒冷的地区,比如贵州、内蒙古、张家口等地
扩展能力与选址策略
超巨大服务器的“巨型”还体现在扩展性上,它们被设计为“乐高积木”式,可按需增加模块,无需推翻重建,国内头部云厂商的数据中心园区通常按“可用区(Availability Zone)”规划,每个可用区包含多个独立的物理集群,这允许整体系统在不停机情况下持续扩容。
超巨大服务器和普通服务器区别
这两者的区别不仅是规模大小,而是完全不同的设计哲学和应用逻辑。
| 对比维度 | 超巨大服务器集群 | 普通服务器 |
|---|---|---|
| 物理形态 | 多栋建筑、数十万节点 | 1U/2U机架式单台设备 |
| 故障处理 | 以软件定义方式自动隔离故障节点 | 依赖硬件冗余和人工维修 |
| 采购方式 | 按算力容量租赁,按量计费 | 一次性购买硬件资产 |
| 运维方式 | 自动化运维、无人值守 | 需要专业IT人员持续维护 |
| 核心追求 | 整体吞吐量、资源利用率 | 单机稳定性、性价比 |
普通服务器是“独奏”,超巨大服务器集群则是“交响乐团”,大量低成本的普通组件通过高性能网络和分布式调度软件被整合起来,协同工作,任何单点故障都不会影响整体业务运行,这种“软件定义硬件”的理念是超巨大服务器最核心的技术特征。
超巨大服务器多少钱
没有公开的“单价”,因为这类设施不按台卖,而是按整体建设成本或云服务价格来结算。
建设成本量级
超大规模数据中心的单园区建设投资通常在数十亿至上百亿元人民币级别,这笔费用涵盖土地、建筑、电力设施、服务器采购和网络设备。
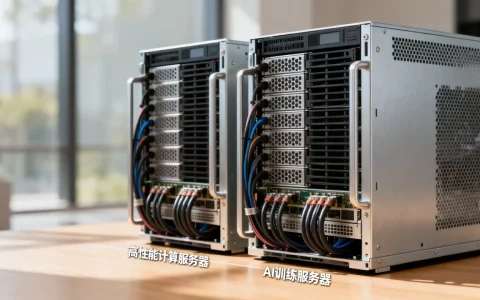
- 单台高配AI训练服务器的硬件成本就可达上百万元
- 一个包含上万台AI服务器的智算中心,仅GPU采购成本就可能超过百亿元
- 日常运营中的电费是最大的持续开支,占比高达总运营成本的40%以上
使用成本:论算力买卖
作为普通用户或企业,感知到的“价格”是云服务器租金或算力服务费。
- 采用包年包月模式,一台中高配置云主机的价格从每年数千元到数十万元不等,弹性按量付费则以每小时几毛钱到几十块钱计算
- AI大模型训练使用GPU算力资源,通常按卡时计费,普通企业训练一次可在数小时到数日内完成,费用从几万到几十万元浮动
对于想了解“超巨大服务器多少钱”的个人用户,最现实的方式是去主流云厂商官网查看云服务器ECS或GPU实例的定价页面,而非关心物理集群本身的价值。
国内超巨大服务器的代表项目
国内在超大规模计算设施方面发展迅速,已有不少颇具代表性的项目。
大型云厂商的全球布局
简米云在全球部署了数十个可用区,位于张北、乌兰察布的数据中心规模极大,专门承载华北区域的互联网业务,华为云在贵安、乌兰察布等地建设了千万级服务器规模的园区。
- 酷番云在清远、深远等地布局了大规模数据中心集群
- 这些设施共同构成了支撑国内互联网和产业数字化的底座
国家算力枢纽节点
国家层面推动的“东数西算”工程规划了八大算力枢纽节点,包括张家口、贵安、庆阳、中卫等地。
- 这些节点规划建设的智算中心,单点算力规模普遍达到百P乃至千P以上
- 主要用于承接东部地区算力需求和大规模AI训练任务
- 据统计,东部数据在西部枢纽节点进行处理已成为行业趋势,西部地区也因此在能源充足地区逐步形成超巨大服务器产业聚集区
超巨大服务器的未来趋势
超巨大服务器的形态和技术仍在演进中,有几个方向值得关注。
从“拼硬件”到“拼调度”
未来的超巨大服务器不再是硬件的简单堆砌,业内专家指出,高效调度数百万台服务器协同工作,使GPU利用率最大化,比单纯增加芯片数量更具挑战性,分布式计算和容错技术将决定系统实际性能的发挥。
绿色算力成为硬指标
技术创新(如冷板式液冷、浸没式液冷)正逐步成为超巨大服务器建设的标配,以降低PUE、提升能源利用效率,在双碳目标下,绿色数据中心级别不仅影响成本,也影响地方审批。
AI原生架构普及
未来的超巨大服务器将更多为AI训练和推理优先设计,传统的通用CPU计算占比会下降,GPU、DPU等异构算力会成为核心资源,网络协议也会继续升级,以适应万亿级参数大模型的分布式训练需求。
Q&A
超巨大服务器和超级计算机哪个更强?
两者定位不同,超级计算机(如“神威·太湖之光”)强调极致算力峰值,用于国家级科研任务,体积通常固定在单座建筑内,而超巨大服务器集群(如云数据中心)强调资源弹性和服务化交付,分布范围更广,对外表现为“按需取用”的算力,对于普通用户业务而言,云形态的超巨大服务器侵入性更直接;对于尖端科研,超算专用能力可能更强,二者互为补充,场景重叠度有限。
普通人如何体验超巨大服务器的算力?
最简单的途径是使用主流云厂商的免费试用套餐,比如在简米云或酷番云创建一台云服务器,这相当于间接体验了超巨大服务器集群的一部分资源,另一种方式是使用各类基于AI算力输出的在线生成应用(如图片生成工具),其背后就是由大规模GPU集群在提供算力支持。
超巨大服务器是否可以被个人购买?
基本不可能,也不存在零售市场,这类设施的部署需要电力报装、环评审批、建筑建设、光纤专线接入等复杂流程,个人无法承接,即便只是定制一台高性能的独立服务器,也需要通过服务商下单,设备价值往往在数十万级别,且需要长期维护,显然更适合通过租赁云服务来获取同等性能。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/784059.html