SQL数据库迁移到云服务器不是高风险操作,选对路径比选对工具更关键中小规模数据库一天内完成迁移是常态,核心是先搞清楚版本差距、预算成本和停机容忍度这三件事。
迁移前,先确认这三件事
很多人一上来就找迁移工具,结果在版本兼容性和权限映射上卡了一整天,迁移数据库这件事,九成问题出在动手之前的准备上。
版本差距决定迁移难度
先查一下本地数据库的具体版本,SQL Server在查询窗口跑一句SELECT @@VERSION,MySQL用SELECT VERSION(),把版本号和补丁级别记下来。
本地环境与云端的版本差异会直接影响迁移复杂度:
- 跨大版本迁移(比如SQL Server 2012迁到2026)需要额外测试存储过程、视图和触发器的兼容性
- 排序规则不一致会导致查询结果顺序异常,中文乱码经常是这一项引起的
- MySQL 5.7和8.0的认证插件不同,老的连接串可能直接报错
- 自增主键、保留字、索引长度限制在不同版本中有差异
行业共识认为,迁移失败案例中相当一部分问题出在版本兼容性上,而不是数据拷贝本身。
数据库迁移到云服务器要多少钱先算清这笔账
费用不是单一维度,它由四部分组成:
- 云服务器实例费用:CPU和内存规格决定基础价格,包年包月比按量付费便宜不少
- 云盘存储费用:按容量计费,系统盘和数据盘分开算,容量越大单价越低
- 公网带宽或内网流量费用:数据从本地传到云端,走公网会产生流量费,同地域内网传输则便宜很多
- 数据库许可证费用:如果你用的是SQL Server,选自带License的镜像比自备License便宜不少
最容易忽略的隐性成本有两个:一是迁移完成后原数据库环境至少要保留一到两周做回滚应急,这段时间本地服务器还在烧电费;二是云平台上DBA托管、自动备份、监控告警这类增值服务,开通之前看一眼价格明细。
端口、白名单和网络延迟提前排好
- 云端安全组规则提前放行1433(SQL Server)或3306(MySQL)端口
- 本地出口防火墙若限制出站流量,提前申请临时放行
- 先ping一下云服务器,确认延迟在可接受范围内,延迟太高说明地域选得不对
- 如果数据量大,申请临时提高带宽或者走云专线,能省大量等待时间
数据库迁移到云服务器需要停机吗按业务容忍度选方案
这是大家最关心的问题,答案取决于你的业务允许停多久,接受停机的用备份恢复,一小时内能搞定;不能停机的用同步工具,切换窗口可以压缩到分钟级。
接受停机窗口:备份+恢复,最简单直接
适合业务低峰期能接受短暂中断的场景,比如内部管理系统、测试环境、报表库。
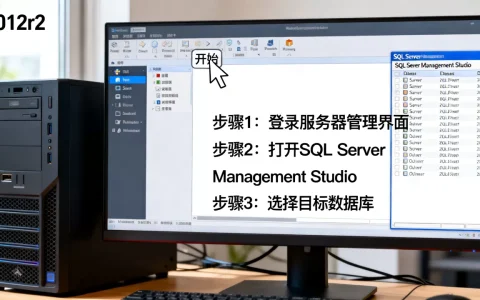
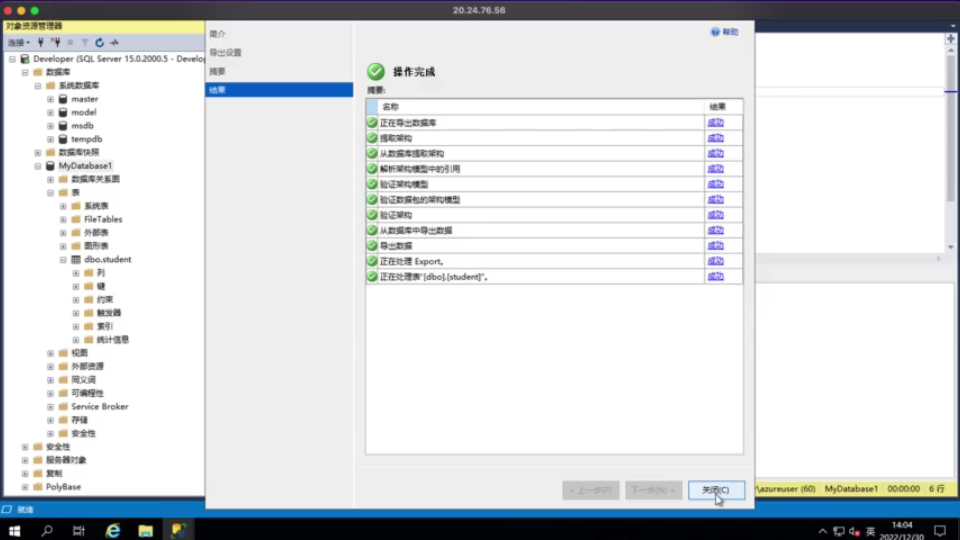
操作路径:SSMS里右键数据库 → 任务 → 备份,生成.bak文件,传到云服务器,再右键还原,MySQL则是用mysqldump导出SQL文件,目标库执行source导入。
# SQL Server备份示例
BACKUP DATABASE [你的库名] TO DISK = N'D:\backup\yourdb.bak' WITH INIT
# MySQL导出示例
mysqldump -u root -p --single-transaction --routines --triggers yourdb > yourdb.sql
停机时长的估算公式:备份文件大小除以实际传输速度,加上目标端还原和索引重建的时间,最后乘以1.5倍安全系数。多数中小数据库的实际停机时间在30分钟到2小时之间。
不接受停机:同步工具追平增量,最后做闪断切换
适合生产环境、电商系统、需要7×24小时在线的业务数据库。
操作思路是这样的:
- 先在云上新建一个空库,结构跟本地保持一致
- 用同步工具做全量同步,把历史数据拷过去
- 全量完成后开启增量同步,本地新写入的数据实时流向云端
- 观察增量延迟稳定在几秒以内后,选一个低峰时段切换连接串
- 切换完成,停止同步,完成迁移
整个过程里业务几乎没有中断,真正的停写窗口只有切换那几分钟,业内专家指出,这种方案唯一需要注意的是增量同步过程中的冲突处理,写操作频繁的表要做特殊配置。
选停机还是不停机,看这三个问题
- 数据库多大?几十GB以内选停机方案,一顿午饭的时间就迁完了
- 业务峰值集中在什么时段?凌晨两点切和下午两点切,完全是两种体验
- 团队有没有DBA维护能力?没有专职DBA的就选备份恢复,别碰同步复制
三种主流迁移路径,按场景对号入座
如果你在纠结数据库迁移到云服务器哪个方案好,答案其实很简单你的业务允许停多久,就选对应的方案。
| 迁移方式 | 适合数据量 | 停机时长 | 操作门槛 | 适用场景 |
|---|---|---|---|---|
| 备份-恢复 | 中小规模 | 分钟级到小时级 | 低 | 内部系统、测试环境、可接受维护窗口 |
| 同步工具 | 中大规模 | 分钟级 | 中 | 生产环境、要求短停机或不停机 |
| 原生主从复制 | 大规模 | 秒级 | 高 | 高可用架构、长期运维规划 |
备份-恢复:成本最低,适用面最广
不依赖网络带宽,把备份文件压缩后传输,能显著缩短传输时间,恢复时如果遇到“数据库正在使用”的报错,先把目标库设置为单用户模式再操作。
同步工具:兼顾数据量和停机时间
云厂商都提供了数据传输服务(比如DTS、DMS),界面化操作,配置源库和目标库的连接信息就能自动跑,同步工具的优势是支持结构迁移和增量数据同步,第一次全量完了,后面新写入的数据会被持续追平,最后切换时几乎无感。
原生主从复制:适合有长期运维规划的团队
SQL Server用Always On可用性组,MySQL用主从复制(binlog),本质上是在云端搭建一个从库,等数据追平后把应用切换到云端主库,这套方案的优势是切换粒度细、恢复能力强,劣势是配置复杂度高,需要DBA从底层维护复制链路。
迁移完成之后,别急着下线旧库
数据拷贝完成不等于迁移结束,验证这一步省掉,后续会付出更大代价。
数据一致性校验
- 对比原库和目标库的行数:每张表
SELECT COUNT()跑一遍,数字对得上才行 - 抽样对比关键表:选几条重要记录,逐字段对比数据内容
- 有条件的做校验和比对:计算结果集哈希值,一致则数据无误
权限和账号映射
这一步最容易出错,数据库登录名和用户SID如果不一致,应用会报“无法登录”或“用户无权访问”,SQL Server里使用sp_change_users_login修复孤立用户,MySQL则要重新授权用户权限。
定时任务和依赖项迁移
- SQL Agent Job、MySQL Event要手动重建
- 链接服务器、外部数据源引用要重新配置
- 应用连接串里的IP地址或主机名要改成云端地址
- 如果原库有邮件通知、作业调度,这些都要逐一验证
性能基线测试
- 跑一遍应用的核心查询,对比耗时是否在可接受范围内
- 检查云端实例的CPU、内存和IO延迟是否出现异常峰值
- 索引碎片严重的话,重建索引后再做一次压测
SQL数据库迁移到云服务器常见问题
迁移后本地数据库还能继续用吗?
能用,但不建议继续作为业务主库写入,两套环境同时接写入流量会造成数据分叉,一旦同步链路断开,两边数据不一致很难合并,稳妥的做法是保留本地库作为只读备份,观察两到四周,确认云端运行稳定后再下线。
数据量很大的库(多个TB)怎么迁才靠谱?
备份文件可能高达几百GB,走公网传输不现实,两条路线可以考虑:一是用离线迁移的方式,把备份文件拷贝到移动硬盘,通过快递寄到云厂商机房,由机房人员协助上传;二是用同步工具先全量后增量,全量同步期间业务不受影响,等增量追平后再切换。
迁移中途断了怎么办,会不会丢数据?
不会丢,至少不会因为断网丢,备份恢复模式中断了,重新传备份文件再恢复就行;同步工具支持断点续传,链路恢复后自动补传增量数据,唯一要留意的是切换窗口内的数据安全,切换前务必做一次最终备份,这是回滚的底牌。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/784367.html