socket接收服务器数据格式的关键,不是“读出来”三个字,而是先确认传输层有没有消息边界,再按应用层协议把字节流拆成完整消息。 TCP 下你收到的是连续字节流,UDP 下收到的是一份份数据报;格式解析的成败,多半取决于长度字段、分隔符、字节序和编码有没有对齐。
socket接收服务器数据格式的底层逻辑:先看边界,再看内容
你拿到一段 byte[],别急着 new String(),先问自己三个问题:这是 TCP 还是 UDP?服务端有没有给长度字段或分隔符?内容是文本还是二进制?这三个答案决定了你后面怎么写读取循环。
TCP和UDP接收数据格式有什么区别
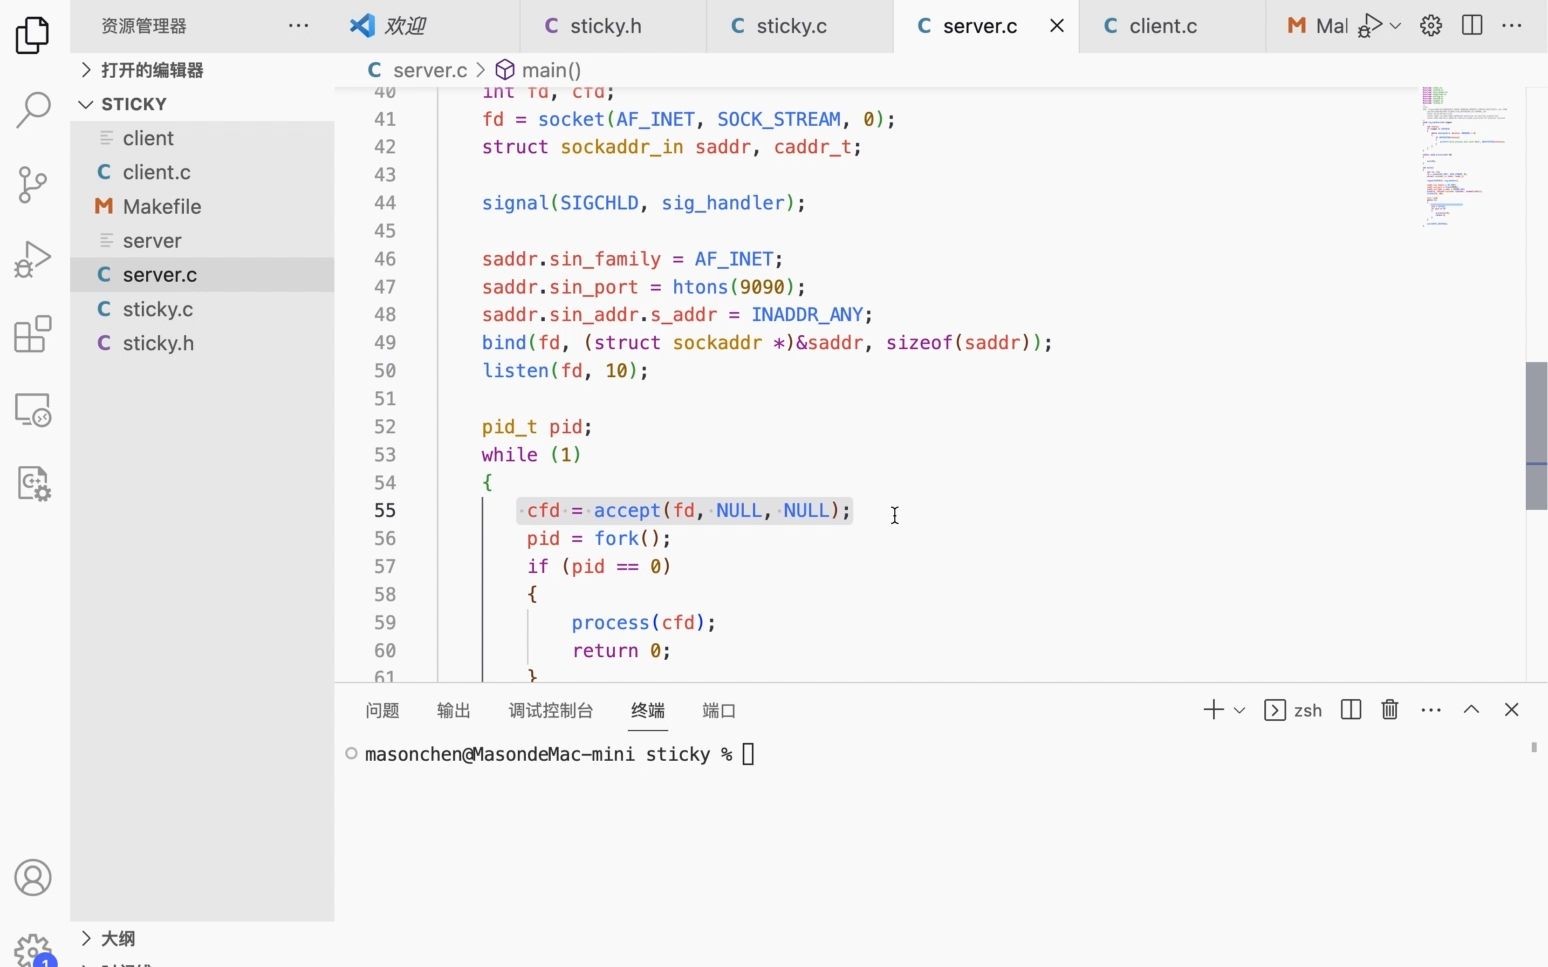
据IETF发布的RFC 793定义,TCP提供面向连接的可靠字节流服务;RFC 768定义的UDP则保留数据报边界,落到代码里,差别很直接。
| 对比项 | TCP | UDP |
|---|---|---|
| 数据形态 | 连续字节流,无消息边界 | 一份份数据报,保留边界 |
| 接收方式 | recv/read,可能半包 |
recvfrom,一次一份 |
| 常见问题 | 粘包、半包 | 丢包、乱序 |
| 解析重点 | 长度前缀、分隔符、循环读 | 单包完整性、序号 |
| 典型场景 | HTTP、文件传输、长连接 | DNS、音视频、实时指令 |
TCP 像水管,服务端倒进去的水,到你这边可能被分成几段,也可能几段合并,UDP 像快递盒,一个盒子一个盒子到,但盒子可能丢,行业共识认为,应用层协议必须自己定义消息边界,传输层不会替你保留“一条消息”的概念。
常见数据格式类型与识别方法
服务端返回的数据格式,常见就这几类:
- 固定长度:每条消息长度一致,按固定字节数切。
- 分隔符:用
\n、\r\n、\0或自定义字符分隔,适合文本行。 - 长度前缀:头部放 2 字节或 4 字节长度,后面跟消息体,二进制协议常用。
- 自描述格式:JSON、XML、Protobuf,本身能描述结构,但外层仍可能需要长度头。
- 混合格式:固定头 + 变长体,头里带魔数、版本、长度、命令字。
识别方法不复杂:先看协议文档;没文档就抓包,看首字节有没有魔数,看前 4 个字节像不像长度,再看内容是不是可打印字符,二进制协议里出现 00 00 00 1A 这种前缀,大概率是长度字段。
socket接收服务器数据格式乱码怎么解决
乱码通常不是 socket 的错,而是编码没对齐,服务端按 GBK 发,你按 UTF-8 解,中文就会变成问号或方块,先别改读取逻辑,先确认字节本身对不对。
编码不一致的排查路径
按这个顺序查:
- 看服务端协议或响应头,确认字符集是 UTF-8、GBK 还是其他。
- 用
xxd、hexdump或 Wireshark 看原始字节,确认内容不是压缩或加密后的数据。 - 客户端显式指定编码,Java 用
new String(bytes, StandardCharsets.UTF_8),不要依赖平台默认编码。 - 检查有没有 BOM、转义字符、Base64 外层包装。
- 文本行协议注意换行符是
\n还是\r\n,按行读时别把\r留在内容里。
一个常见场景:服务端返回 JSON,但前面加了 4 字节长度头,你直接 readLine(),读到的前几个字节是长度字段,后面自然解析失败,先抓包看首字节,比猜编码快得多。
字节序与结构体对齐
二进制格式还要看字节序,网络字节序是大端,主机字节序可能是小端,Java 的 ByteBuffer 默认大端,C# 的 BinaryReader 默认小端,Python 的 struct.unpack('>I', data) 用 > 表示大端,两边不一致,长度字段会变成一个离谱的大数。
结构体对齐也要留意,C/C++ 默认会对齐成员,导致实际字节数比字段长度之和大,跨语言通信时,用 #pragma pack(1) 或手动序列化,别直接把内存结构体往 socket 里塞。
Java Socket接收服务器返回数据格式解析
Java 里处理长度前缀协议,DataInputStream 很顺手,下面这段是常见写法:
DataInputStream in = new DataInputStream(socket.getInputStream());
int len = in.readInt();          // 默认大端,对应服务端 writeInt
byte[] body = new byte[len];
in.readFully(body);              // 必须读满 len 字节
String json = new String(body, StandardCharsets.UTF_8);
注意 readFully 和 read 的区别:read 可能只读一部分,readFully 会循环读到指定长度,半包问题就出在这里。
按分隔符读取
文本行协议可以用 BufferedReader.readLine(),但它只适合文本,不适合二进制,服务端如果发的是 {"a":1}\n,按行读没问题;JSON 被压缩成一行且没有换行,按行读就会一直等,更稳的做法是先读长度头,再读消息体。
处理粘包与半包
TCP 粘包不是错误,是流式传输的正常表现,业内专家指出,粘包和半包应该由应用层协议解决,而不是指望 recv 一次给你一条完整消息。
通用处理思路:
- 维护一个
ByteArrayOutputStream或ByteBuffer作为接收缓冲区。 - 每次
recv后追加到缓冲区。 - 循环判断缓冲区里有没有完整消息:够长度头就读长度,够消息体就切一条。
- 切完后把剩余字节留在缓冲区,继续下一轮。
- 用 Netty 的话,可以直接上
LengthFieldBasedFrameDecoder,指定长度字段偏移和长度。
socket接收服务器数据格式不全是什么原因
数据不全,先怀疑读取方式,再怀疑网络,多数情况不是服务端少发了,而是客户端只读了一次。
缓冲区与读取循环
常见错误清单:
- 只调用一次
recv(1024),而消息有 5000 字节。 - 缓冲区设得太小,又没循环读。
- 把
read返回值当成了消息长度,没判断实际读了多少。 - 解析完一条就退出循环,漏掉缓冲区里的下一条。
正确做法是循环读到满足协议长度,或者读到流结束,TCP 的 recv 返回 0 通常表示对端关闭;返回 -1 在阻塞模式下是错误,在非阻塞模式下可能是 EAGAIN,表示暂时没数据。
超时与断连
设置 socket.setSoTimeout(5000) 可以避免永久阻塞,超时后要决定是重试、跳过还是断开,长连接场景还要处理心跳和重连,别把超时当成数据格式错误。
本地调试socket接收服务器数据格式的步骤
先在本地把“服务端到底发了什么”看清楚,再改解析代码,顺序反了,容易在编码和协议之间来回猜。
抓包确认服务端发了什么
Linux 下可以用:
tcpdump -i any -nn -A 'tcp port 8080'
只看某台服务器:
tcpdump -i any -nn -A host 192.168.1.10 and port 8080
Wireshark 里右键某条 TCP 流,选 Follow TCP Stream,能直接看应用层内容,文本协议用 nc 127.0.0.1 8080 手动发请求也很快。
用最小脚本复现解析
Python 里先打印十六进制,别急着解码:
import socket, struct
s = socket.create_connection(("127.0.0.1", 8080))
buf = b""
while True:
    chunk = s.recv(4096)
    if not chunk:
        break
    buf += chunk
    while len(buf) >= 4:
        length = struct.unpack(">I", buf[:4])[0]
        if len(buf) < 4 + length:
            break
        body = buf[4:4 + length]
        print(body.hex())
        buf = buf[4 + length:]
先确认长度字段是 2 字节还是 4 字节,含不含头,是大端还是小端,这些对齐了,再谈 JSON 或 Protobuf 解析。
常见坑位清单
- 服务端开了 TLS,你却在明文 socket 上解析。
- 服务端 gzip 压缩了 body,客户端没解压。
- 长度字段包含自身头部,你却只按 body 长度切。
- 文本协议用了
readLine,但服务端没发换行。 - 二进制协议里混了调试日志,首字节对不上魔数。
记住一句话:先定边界,再解内容;先抓包,再改代码。 把长度字段、编码、字节序三件事对齐,socket接收服务器数据格式的问题大多能在半小时内定位。
socket接收服务器数据格式Q&A
Q1:socket接收服务器数据格式时,recv返回0和返回-1分别代表什么?
返回 0 通常表示对端正常关闭连接,读取循环应该结束,返回 -1 表示发生错误,需要查看 errno 或异常信息;非阻塞模式下 EAGAIN/EWOULDBLOCK 只表示当前没有数据可读。
Q2:服务端返回JSON,为什么按行读还是解析失败?
JSON 可能被压缩成一行且没有换行符,也可能前面带了长度头、魔数或 Base64 包装,先抓包看首字节和总长度,再决定用长度前缀还是分隔符读取,不要直接假设“一行就是一条消息”。
Q3:socket接收服务器数据格式需要先解压或解密吗?
看协议封装顺序,如果服务端在应用层做了 gzip,先用 GZIPInputStream 解压;如果走的是 TLS,先用 SSLSocket 完成握手再读业务数据,解析顺序必须与发送端封装顺序相反,先解外层,再解业务格式。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/785766.html