华为服务器H14(主流型号多指基于鲲鹏920处理器的TaiShan 200系列)报错时,最快速的处理路径是:先通过BMC/iBMC管理网口登录Web界面抓取完整告警日志,再根据告警ID精准定位故障件,避免盲目拆机复位。
华为服务器h14报错怎么办:从日志定位到硬件修复的实操流程
遇上报错别急着拍重启键,我们在机房处理过大量H14设备,绝大多数启动失败或运行告警都指向内存、RAID卡、电源模块或散热风扇这几类部件,以下流程按故障排查的优先级排序。
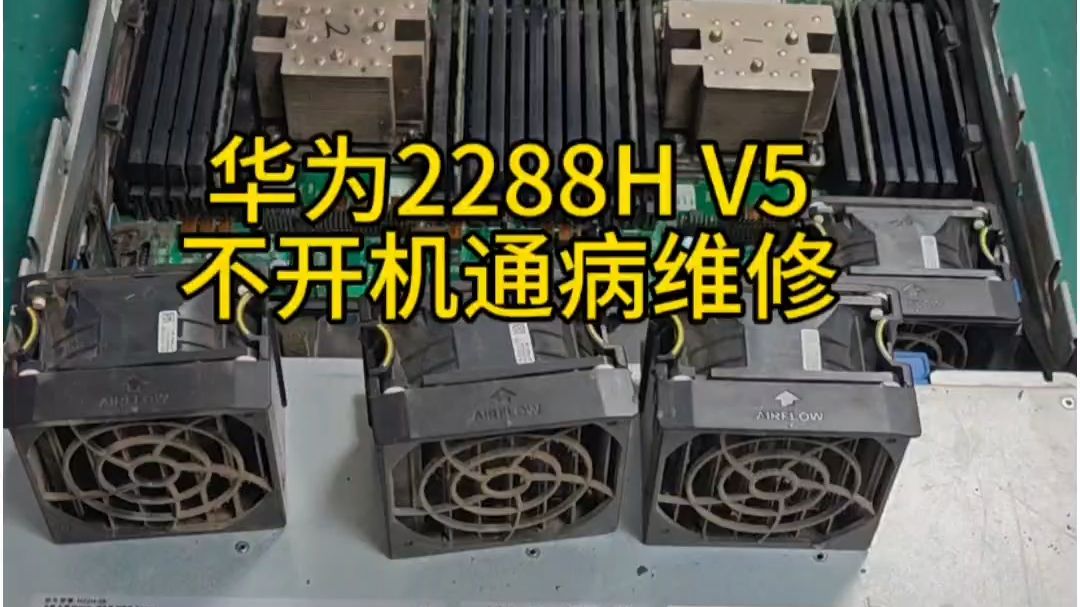

第一步:通过BMC/iBMC管理口抓取告警快照
华为服务器H14的管理芯片默认IP是168.1.2,出厂账号密码通常贴在设备前面板的标签贴纸上,电脑网线直连管理口,把本地IP改成同网段(例如168.1.10),浏览器输入管理地址登录。
登录后建议按以下顺序操作:
- 进入系统信息 > 事件日志,记录所有报错ID(形如
0x1201、0x040F等等)。 - 截取传感器读数页面,重点看CPU温度、主板进风温度、12V电压、3.3V电压这三类关键数值。
- 点击实时监控查看风扇转速百分比,确认是否有风扇停转。
拿到报错ID后,访问华为技术支持官网的“产品支持”页面,在搜索框输入H14型号和报错ID,能直接查到对应的故障码解释,如果无法联网,拨打华为企业服务热线,报出服务器序列号和报错ID,客服能直接给出故障件指向。
第二步:区分硬件故障与固件问题
行业共识认为,H14设备出现的报错约有半数属于固件版本缺陷或配置冲突,并非硬件物理损坏,判断方法很简单:看BMC日志中是否存在大量“Corrected”或“Threshold”类记录。
如果日志显示以下两类情况,优先考虑升级固件而非更换硬件:
- 内存Correctable Errors频繁出现:RAID卡或BIOS版本过旧导致内存训练参数异常。
- 硬盘链路复位记录:SAS/SATA背板固件与硬盘固件存在兼容性缺口。
登录BMC的“固件升级”界面,上传从华为官网下载的最新BIOS、iBMC和硬盘背板固件包,升级过程不能断电,机柜环境建议先挂接UPS再执行升级。
华为服务器h14启动失败原因排查及内存报错处理
业内专家指出,H14设备在加装或更换内存后未通过内存训练,是启动失败类报错中最常见的情形,设备在BIOS自检阶段检测到内存拓扑变化,会强制触发完整的内存训练流程,此时面板上的健康指示灯呈现黄色闪烁状态。
内存报错的三种典型表现与对策
报错场景一:开机后显示器无信号,管理页显示内存Rank未识别。
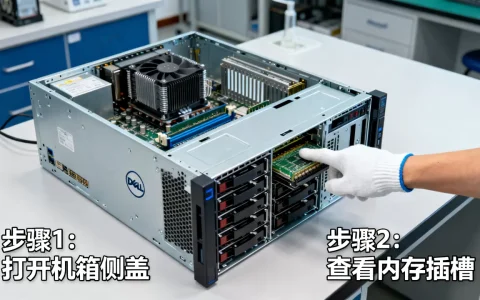
这种状况多数是内存未插到位或顺序错误,TaiShan 200系列对内存插槽填充顺序有严格规定,并非随便插满就能识别,具体规则是:每一个CPU优先填满通道0,再依次填充通道1和通道2,如果内存只装了四条,应该插在CPU1和CPU2各自的第一通道上,先打开机箱侧盖,对照主板丝印的插槽编号重新安装内存条,听到两侧卡扣“咔嗒”声才算到位。
报错场景二:日志中出现多个内存地址的Uncorrectable Error。
这类报错指向硬件颗粒损坏概率较高,先做交叉验证:把报错内存槽位的条子拔下来,换到另一台正常服务器的空槽位测试,如果在另一台机器上依然报错,直接走华为原厂保修流程更换内存条,若在另一台机器上一切正常,则反向测试原H14上的该内存插槽,即插一根已知良好的内存到报错槽位,开机引导系统。
报错场景三:系统运行过程中随机死机,日志里看到内存饥饿相关记录。
排查内存配置容量是否匹配CPU支持规格,H14单颗鲲鹏920处理器最高支持16个内存通道(不同型号有差异),总容量上限可达1TB以上,若配置了满规格内存但报错,需要检查是否混用了不同频率的DDR4内存条,行业惯例是同一台服务器的内存必须同品牌、同型号、同批次,混插降频运行容易产生信号稳定性问题。
内存训练耗时的误区
不少维护人员看到H14开机在内存配置页面停留五到八分钟,就误判为死机,其实这是设备在内存容量较大时进行的全量训练过程。首次加电或硬件变更后的首次启动,内存训练耗时十分钟以内都属于正常现象,此时耐心等待进度条走完即可,无需干预,反复断电重启会中断训练流程,反而延长后续启动时间。
告警灯红色亮起的华为服务器h14报错处理步骤
前面板告警灯红色常亮,意味着BMC检测到严重故障,这时不要凭经验猜测原因,按管理界面显示的故障部件颜色标识来处理。
| 告警颜色 | 指向部件 | 处理动作 |
|---|---|---|
| 红色闪烁 | CPU、内存、主板 | 停止业务,立刻进入维护窗口 |
| 橘色常亮 | 硬盘、RAID卡 | 确认业务冗余后,可按住硬盘灯对应槽位热插拔确认 |
| 蓝色闪烁 | 硬盘定位(用户主动触发) | 无需操作,这是定位功能 |
| 风扇转速告警 | 散热风扇 | 观察转速值,低于阈值时整机强制关机 |
硬盘故障类告警的快速确认
当管理界面显示硬盘状态为“Offline”或“Predictive Fail”时,执行以下确认步骤:
- 用串口或SSH连接RAID卡管理命令行(如
storcli命令),输入/c0 /eall /sall show查看物理盘状态。 - 检查SAS线缆两端连接是否松动,尤其是热插拔背板与RAID卡之间的连接器。
若多块硬盘同时掉线,优先怀疑背板供电或SAS线缆故障,这比多块硬盘同时物理损坏的概率更高,更换线缆或背板后,多数情况下硬盘能重新被识别。
电源模块告警的识别
H14设备通常配置两个冗余电源模块,单个电源模块风扇停转或输出异常时伴生告警,系统仍可运行,但冗余能力丧失,发现电源告警后,操作前必须确认负载功率低于单个电源的额定输出值,具体操作路径是:核对铭牌上的额定功率,再对比iBMC“电源管理”里读取的整机实时功耗,满足替换条件后,可以带电拔插损坏电源模块进行更换。
数据中心高温场景下风扇高转速报错的应对
机房空调故障或机柜风道堵塞时,H14会触发进风温度过高告警,风扇转速飙升至100%,处理顺序是:先查看iBMC温度传感器读数,当前进风温度是否超过35摄氏度,CPU板温度是否接近85摄氏度的降频线。
- 温度超标时,直接调低机柜空调设定温度,并检查设备前后门的气流方向是否正常。
- 温度正常但风扇转速高,检查风扇防尘网积灰情况,积灰严重时使用气吹或吸尘器清理,无需拆下风扇。
若清理后转速仍异常,可能是风扇轴承磨损,通过管理页面的“风扇测试”功能逐颗测试风扇,测试中转速无变化的那个风扇即为故障件,申请备件后停机更换。
系统运行中报PCIe链路错误或网卡消失的修复建议
H14设备在运行虚拟化平台时,偶尔出现PCIe设备掉卡或网卡在系统中消失的报错,先从BMC日志中查看是否有PCIe的错误记录,若存在就优先升级BIOS到最新版本,华为在2026年后发布的BIOS版本中修复了多型号PCIe链路训练的兼容性问题。
升级后若问题依旧,将设备停机断电,物理检查PCIe Riser卡插槽和扩展卡的金手指,使用干净橡皮擦轻擦金手指表面氧化层,重新插回时确认卡扣扣紧,涉及多张GPU卡或高速网卡的高功耗扩展卡,检查辅助供电线是否接实,供电不足会导致高负载时设备随机掉卡。
华为服务器h14日常维护时可执行的关键检查项
避免性能突发意外,可以在日常巡检中执行如下简便检查:
- 每月检查一次iBMC的健康事件日志,观察是否有“Warning”级别告警持续累积。
- 每季度比对一次固件版本与华为官网发布的最新版本差异,必要时规划升级窗口。
- 每半年清理一次风扇防尘滤网与机箱内部积灰。
- 关注硬盘S.M.A.R.T.信息中的Reallocated Sector Count,数值持续增长时提前规划数据迁移和硬盘更换。
Q&A:华为服务器h14报错怎么办的常见问题解答
问:BMC管理界面登录不进去,前面板又报错,如何强制恢复?
答:长按前面板复位键十秒以上可以强制重启BMC芯片,不影响运行中的业务系统,重启后等待约五分钟,再尝试用默认IP登录管理页面。
问:报错显示RAID组状态为Degraded,如何判断是硬盘损坏还是阵列卡问题?
答:进入RAID卡管理界面查看物理硬盘状态,只有单块盘显示Failed时,坏盘概率较大,更换硬盘后自动重建,若多块盘同时掉线或盘状态显示Missing,更可能是线缆或阵列卡故障,需考虑更换硬件组件。
问:发生过内存报错并更换内存条后,开机耗时比原来长了一倍,这正常吗?
答:更换内存或调整配置后,服务器需重新执行完整内存训练来适配新硬件,这个过程的耗时与内存容量和通道数正相关,大约维持到下一次硬件变更前,训练完成后,每次开机启动时间会回落到常规水平。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/787317.html