你的MC服务器提示“达到最大内存”时,核心解决办法是调整JVM启动参数中的-Xmx值,并配合优化垃圾回收器;但如果是内存持续上涨后崩溃,则说明存在插件泄漏或区块加载异常,单纯调大内存反而会让问题更严重。
很多开服朋友的第一反应是把内存加到最大,服务器反而更卡,今天咱们从实际排查步骤聊到具体参数配置,一次性讲透这件事。
我的世界服务器内存设置多少合适?先分清物理内存和JVM分配
服务器“达到最大内存”和电脑物理内存耗尽,是两码事,你给Java虚拟机(JVM)划了2GB,那游戏最多只能用2GB,就算物理机有32GB空闲也没用。
- Xms:启动时占用的初始内存
- Xmx:运行中能使用的最大内存
- 两者的差值越大,运行中扩容和缩容的次数就越多,卡顿概率越高
行业共识认为,Xms和Xmx设为相同值能显著减少GC暂停频率,如果你用的是Paper或Purpur服务端,推荐这样写:
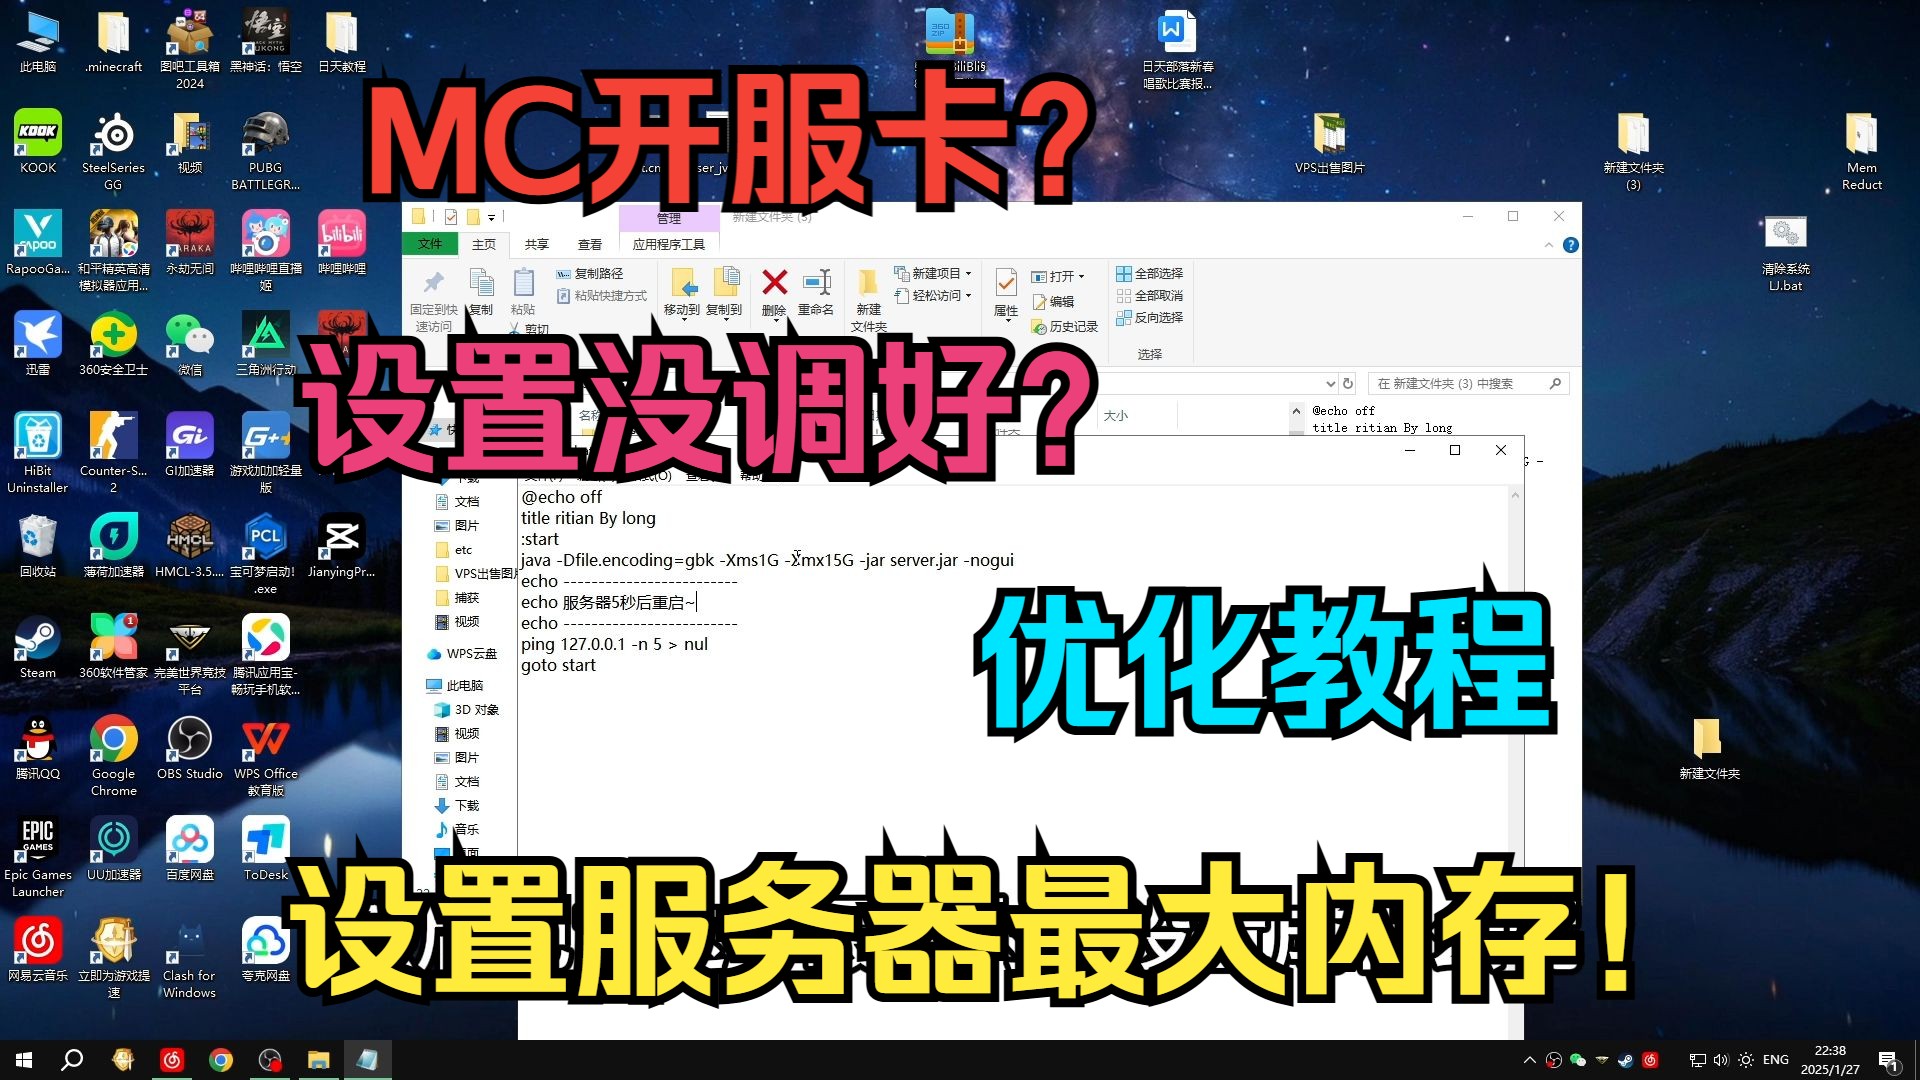
java -Xms6G -Xmx6G -XX:+UseG1GC -jar server.jar nogui
这里的6G要根据你实际物理内存的一半到三分之二来定,如果宿主机只有8GB,分6GB给MC服务器,操作系统和其他进程会因为没有余量而频繁使用虚拟内存,磁盘读写飙高,服务器照样卡死。
内存分配参考表
| 物理内存 | 建议分配 | 适用规模 |
|---|---|---|
| 4GB | 2GB | 小型私人服,5人以内 |
| 8GB | 4-5GB | 小型社区服,10-20人 |
| 16GB | 8-10GB | 中型MOD服,20-40人 |
| 32GB | 16-20GB | 大型插件服,50人以上 |
如果你的服务器是CentOS或Ubuntu系统,用free -h查看真实可用内存,再用top确认Java进程的RES列是否已经逼近Xmx值。
mc服务器内存占用高怎么办?从日志和命令定位根源
单纯加内存是治标不治本,你需要先搞清楚内存到底被谁消耗了。
第一步:打开GC日志
在启动参数里加上这行:
-Xlog:gc:gc.log:time,uptime,level
跑个半小时,打开gc.log,如果看到Full GC频繁发生,且每次回收后内存占用都在高位,说明堆内存中存在无法回收的对象多半是插件或MOD的静态集合在缓存数据。
第二步:用jstat观察实时状态
Java自带的jstat比任何面板都直观,先jps找到服务端PID,然后执行:
jstat -gcutil 1234 1000 10
每秒输出一次,连续10次,重点看FGC列(Full GC次数)和FGCT列(Full GC总耗时),如果FGC在短短10秒内上涨了好几次,那内存配置再大也会在半小时内耗尽。
第三步:检查区块和实体数量
很多“内存涨到最大”的情况,其实是大量未卸载区块造成的,用/paper entity list或/tps查看服务器负载,如果TGS长期低于15,先跑/minecraft:timings paste,把生成的链接打开分析。
业内专家指出,单个区块加载范围超过8个,内存消耗会呈几何倍数增长,查看server.properties里的view-distance,建议调低到6以下,如果是模组服,检查simulation-distance,这个值比view-distance更吃内存。
我的世界服务器内存溢出后,怎么调整启动参数才不白调
调整参数不能只改数字,垃圾回收器的选型和具体参数,直接影响内存利用率。
首选G1GC,而不是默认的并行收集器
Java 8自带的Parallel GC在内存超过4GB时反而会频繁触发Full GC,换成G1后,停顿时间更可控。
java -Xms6G -Xmx6G -XX:+UseG1GC -XX:MaxGCPauseMillis=200 -XX:ParallelGCThreads=4 -jar server.jar nogui
MaxGCPauseMillis=200表示目标暂停时间不超过200毫秒,如果机器核数较少,ParallelGCThreads设4就可以,过高反而增加上下文切换开销。
优化G1的Region大小
G1GC把堆内存划分成Region。-XX:G1HeapRegionSize默认会根据堆大小自动计算,对于6GB的堆,Region大小会锁定为8MB,如果你运行的是大型整合包,类加载和缓存对象特别多,可以显式设为16MB:
-XX:G1HeapRegionSize=16m
预分配内存的隐藏价值
加一行-XX:+AlwaysPreTouch,启动时让JVM直接物理触碰所有内存页,这样系统在启动阶段就完成内存分配,运行过程中不会因为向操作系统申请新的内存页而出现轻微顿挫,缺点是启动时间会变长5-10秒,但对于常驻服务器来说,这波交换是值得的。
Aikar’s Flags的改良版本
很多Wiki推荐的Aikar’s Flags是针对Paper的经典优化,但其中一些参数在较新版本中已经默认调整,实际使用中,这几条仍然有效:
-XX:+UseG1GC -XX:+ParallelRefProcEnabled -XX:MaxGCPauseMillis=200 -XX:+UnlockExperimentalVMOptions -XX:+DisableExplicitGC
注意不要加-XX:+UseStringDeduplication,这个选项在本服内存泄漏时会让Minecraft的字符串对象去重,反而额外消耗CPU,曾经有群里的小伙伴加了后,TPS从20跌到了11。
模组服内存怎么分配?针对Forge/Fabric的专项建议
模组服务和插件服的内存行为完全不同,插件大多依赖Bukkit API,而模组经常直接操作底层区块和实体对象,内存泄漏概率高得多。
判断是内存不足还是内存泄漏
在服务端控制台执行:
/forge tps
再打开F3菜单看内存条。如果内存占用曲线持续上行,重启后恢复正常,过几小时又涨到接近Xmx值,那基本可以确定是某个模组的缓存没有定期清理。
常见高内存消耗模组类型
- 区块缓存类:如
Chunk Pregenerator生成过多边界需要定时清理 - 实体AI类:如
Mob Grinding Utils的大规模刷怪区域 - 自动化存储类:如
Storage Drawers的缩略图缓存 - 世界生成类:如
Biomes O‘ Plenty的地形预生成
针对这类模组,用/spark profiler(需要安装Spark模组)开启5分钟采样,结束后在网页输出中查看Heap memory消耗最高的类,基本能定位到根因,比如之前遇到一个服务器总是内存打满,最后发现是Refined Storage的网络节点在频繁扫描周围方块导致的。
MOD服推荐的内存策略
不要给模组服分配超过物理内存的60%,模组服不仅吃内存,还吃CPU,如果你只有8GB机器跑一个100个模组的整合包,大概率不是内存不够,而是CPU单核性能瓶颈导致区块加载速度极慢,看起来像卡死。
服务器一直内存高,如何从源头降低占用而不是堆内存
调参只是治标,真正稳妥的做法是减少内存需求。
清理实体和掉落物
kill @e[type=item]清理地面掉落物entityscan查看附近实体数量- 降低
server.properties里的max-tick-time对超负荷实体的容错值
更换轻量级服务端
如果你仍然在使用纯Vanilla服务端,换到Paper是内存占用一次性下降10%-20%的可行路径,Paper的分块系统(Chunk System)比原版更高效,在保持原版玩法不变的前提下,内存碎片更少,Purpur是Paper的分支,额外解锁了一些性能开关。
对面板服的建议
如果是购买的云服务器面板,比如MCSManager或Pterodactyl面板,注意检查“删除多余容器”选项,有些面板创建实例时默认预留大量swap分区,这部分不会占用物理内存,但会让系统误判内存使用率,排查时用htop看真实的RES列,比面板显示的值更可信。
Q&A:MC服务器最大内存问题常见解答
我的世界服务器内存设置多少合适?4GB内存的机器能开服吗?
4GB物理内存的机器,Xmx设置为2GB以下比较稳妥,能流畅运行10人以内的插件服,使用Paper服务端+`view-distance=4`时,再开一些轻量级插件问题不大,模组服建议至少8GB起步,部分大型整合包(如Better MC)甚至建议12GB以上。
最大内存调到8GB后,内存占用一直涨,多久要重启一次?
如果每天都会涨到7.5GB以上并且触发频繁Full GC,建议先做一次OOM分析,用jmap -dump:format=b,file=heap.bin <pid>导出堆转储,配合Eclipse MAT或VisualVM进行对象直方图分析,如果确认是插件泄漏,重启只能救急,常见泄漏源是连续使用/back指令相关的插件,以及定时器没有正确取消的脚本。
主机商给的内存条类型会影响最大内存上限吗?
Java进程的Xmx值分配受JVM位数和操作系统限制,与DDR4还是DDR5无关,32位JVM理论极限约为1.5GB(实际可用1.2GB),你无法在32位环境里设置-Xmx4G,检查一下java -version输出中是否包含64-Bit字样,如果是32位JVM,直接卸载后安装64位JDK(推荐Temurin或Zulu的Java 17),内存问题会立刻缓解大半。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/787720.html