GPU服务器能不能先短租再转成包月,答案是肯定的,但并非所有平台都支持无缝转换,能否实现取决于服务商的计费规则和资源配置策略。
短租转包月不是简单的”续费”,它涉及计费模式切换、费用清算、甚至硬件调度策略变更,如果你只是按天租了一台GPU服务器跑几天模型,然后想直接在这个实例上转成包月,大概率会碰壁,但换个角度,从阶梯计价和资源预留维度来看,这个需求完全可以被满足,关键看你选对平台和操作方法。
GPU服务器能不能先短租再转成包月:平台规则决定可行性
要回答这个问题,先得搞清楚市面上的GPU租赁模式分哪几类,目前国内主流的GPU云服务器提供商,大致分为两种计费架构:按量付费(后付费)和包年包月(预付费)。
按量付费实例:多数平台不支持直接”变更计费方式”
按量付费是我们通常理解的”短租”,按秒或按小时计费,随时开通随时释放,想从这个状态直接转成包月,行业共识是:绝大多数云厂商不允许对已创建的按量实例直接执行”转包月”操作,原因是两者的底层资源池隔离策略不同,按量实例属于动态资源池,物理节点可能随时被回收,而包月实例属于预留资源池,有明确的物理位置和排他性。
部分头部平台提供”按量付费转包年包月”的变通操作,通常是通过“实例规格变更”或”续费转套餐”功能实现,具体路径一般是在控制台的实例列表里,找到”更多操作”选项,看是否有”转包年包月”按钮,如果没有,最简单的替代方案是:通过自定义镜像备份系统盘数据,退掉按量实例,再购买包月实例,最后用镜像重建环境,这种做法虽然多花十几分钟,但数据完整性和环境一致性完全可控。
新模式:弹性时长套餐,本质是”短租后补差价升级”
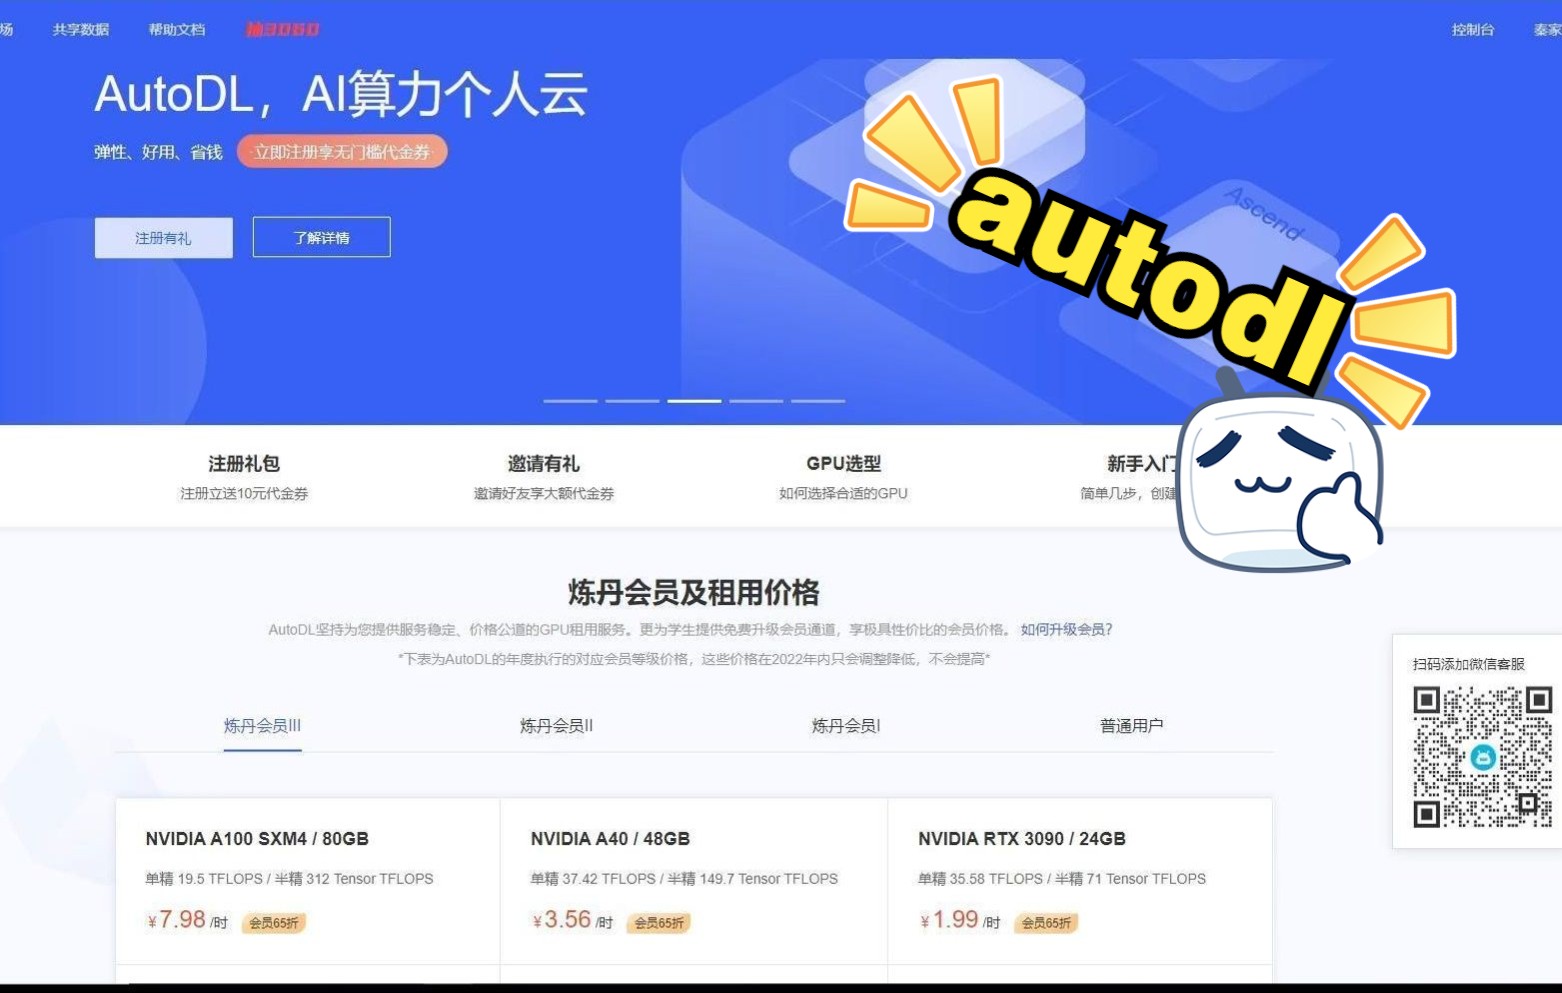
近年来,不少专门做GPU算力租赁的中间商平台(非传统云厂商)推出了更灵活的模式,这类平台通常提供小时租、日租、周租、月租的分级套餐,在这种模式下,”先短租再转包月”就变得非常顺畅你只需要在短租订单到期前,在订单详情页选择”升级为包月”,系统会自动扣减已用时长对应的费用,补足差价即可,这种模式本质上不是”修改计费方式”,而是”重新购买一个包月产品并退还短租未消费部分”,体验上无缝衔接。
线下托管和整机租赁:完全是另一套玩法
如果是租用物理整机(比如8卡A100整机托管,或者GPU服务器托管至IDC机房),先短租再转包月的逻辑就变得更像”商务谈判”,线下租赁通常按合同走,短租合同(比如3个月)到期前,可以与服务商协商续签长期合同,获得更低的月单价,这种情况下,不存在”实例切换”,而是重新签订一份预付合同,原先的押金和短租费用按合同条款清算。
GPU服务器短租和包月怎么选:成本模型差异极大
搞清楚能不能转之后,更核心的问题其实是”该不该转”,短租和包月的价格差异远不止”按月折算更便宜”那么简单。
价格差异:单价差距可达50%以上
以业界常见的单卡A100(80G)租赁行情为例,按量付费的单价约为每小时20-30元,而包月的单卡成本折算到每小时会下探至10-15元。等量算力下,包月成本要比短租低一半左右,不过需要注意,包月意味着你必须持续付费,哪怕GPU闲置。
| 对比维度 | 按量短租 | 包月长租 |
|---|---|---|
| 计费粒度 | 秒/小时 | 月 |
| 平均每小时成本 | 高(溢价明显) | 低(约为短租的50%-70%) |
| 弹性释放 | 随时释放,无违约金 | 提前退订可能扣费 |
| 资源确定性 | 可能被回收/迁移 | 资源独占,物理位置固定 |
| 适合场景 | 代码调试、临时跑批、短期验证 | 模型训练、7×24小时服务 |
适合转包月的关键信号:连续使用超过7天
这里给一个简单实用的判断标准:如果你在同一个实例上连续开机超过7天,并且未来两周内还有持续算力需求,就应该转包月,业内专家指出,7天是短租与包月的成本平衡点按量付费跑7天的费用,通常已经接近包月费用的50%-60%,继续按量租下去性价比会迅速恶化。
不适合转包月的例外:高频弹性需求
有一种情况不建议转包月:你的任务呈现明显的潮汐特征,比如白天空闲、晚上跑批,或者每周只需集中跑3天,这种情况下,按量付费随开随关,虽然单价贵,但总支出可能比包月更低,包月后GPU闲置时段照样扣费,反而浪费预算。
实际操作:短转长三种路径全对比
如果确认要转包月,具体怎么操作?按平台类型和执行成本排序,有三种路径。
控制台一键转换(仅限特定厂商)
适用平台:部分头部云厂商的特定实例规格(如竞价实例转包月有时开放入口),操作路径:登录控制台 → 进入ECS/GPU实例列表 → 点击实例ID进入详情页 → 找到”变更计费方式”或”续费管理” → 选择”转包年包月” → 确认支付差价,注意,这种操作通常要求实例处于”运行中”或”已停止”状态,且不适用于竞价实例和抢占式实例。
镜像迁移(通用性最高,推荐)
适用平台:所有云厂商和租赁服务商,实操步骤:
- 在源实例上执行
nvidia-smi和df -h记录当前驱动版本和数据盘挂载情况。 - 创建自定义镜像:控制台 → 实例 → 更多 → 制作镜像,等待镜像状态变为”可用”。
- 购买新的包月实例,规格选择与源实例一致(注意CPU、内存、GPU型号和显存大小)。
- 使用自定义镜像创建系统盘,启动后将数据盘快照或对象存储中的数据拷贝回实例。
- 校验环境:执行
python -c "import torch; print(torch.cuda.is_available())"确认CUDA可用。
这套方法多花大约15分钟,但最稳妥,不会卡在平台限制上。
商务换签(线下租赁专用)
适用场景:整机租赁、IDC托管、长周期项目制合作,流程是:短租合同期满前15天,联系销售提出转签需求 → 双方确认新合同时长(通常6个月或1年) → 按包月价重算费用,短租期间已缴纳的押金抵扣新合同押金 → 签订补充协议,原短租合同终止,这种模式下,包月价一般在短租价基础上打7-8折,但合同期内退订的违约金条款需要仔细阅读。
短租转包月最容易踩的三个坑
转换过程中,有几个细节不处理好很容易吃亏,尤其是涉及费用和资源状态的问题。
坑一:数据盘不随镜像迁移
很多人在”制作镜像”时只勾选了系统盘,忽略数据盘,如果训练数据集和模型权重存在数据盘上,镜像迁移后数据盘需要手动挂载并拷贝数据。建议在制作镜像前,先将数据盘做快照,或者用 rsync -avP /data user@目标IP:/data 直接同步过去。
坑二:包月实例的计费周期从”创建时间”起算
下单包月实例时,计费周期通常从资源创建成功的那一刻开始,而不是从自然月的1号开始。提前释放包月实例,已支付费用通常不退还,只能提工单申请特殊审批,很多情况下审批不会通过,所以操作前务必确认项目周期,避免拍脑袋下单。
坑三:IP和公网带宽的变动
短租实例通常绑定的按量公网IP,转包月后IP地址可能被释放或更换,域名解析和防火墙白名单需要同步更新,建议在转换前,将短租实例的弹性公网IP转换为包年包月计费方式,或者准备迁移后的IP变更通知。
Q&A:常见疑问集中解答
Q:先短租再转包月,GPU服务器租用价格怎么算更划算?
如果平台支持”补差价升级”,结算逻辑是:假设按量单价100元/天,包月单价2000元/月,你已按量使用了3天(300元),升级时只需要再支付2000-300=1700元,如果平台不支持差价抵扣,那么建议直接释放短租实例,用镜像重建包月实例,避免为已经用掉的短租时长重复买单。
Q:国内GPU服务器租赁有哪些地域选择需要注意?
国内用户租用GPU服务器,地域选择直接影响延迟和数据合规性。训练和推理任务通常优先选择华东地区(如上海)和华北地区(如北京)的节点,因为数据中心资源最丰富,带宽品质和冗余保障较好,如果做金融量化或对数据主权敏感的业务,可以优先考虑境内地域,避免使用海外节点带来的跨境链路不稳定问题,地域切换只影响网络延迟和部分内网互通能力,不影响包月价格模型。
Q:短租转包月后,显存和驱动配置需要重新验证吗?
需要,即使镜像一致,物理宿主机可能不同,驱动版本与内核模块的兼容性会有细微差异,迁移后建议执行三段验证:先 nvidia-smi 看显存是否显示正常,再运行 torch.cuda.is_available() 确认CUDA上下文可用,最后跑一个小的卷积算子或矩阵乘法,对比TFLOPS是否符合预期。
最终结论很明确:GPU服务器短租转包月不是标准化的云产品功能,但有镜像迁移和订单升级两种变通路径可达到目的,如果你是个人开发者或中小企业用户,优先走镜像迁移路径,熟悉后全程操作不超过20分钟,如果短期任务使用率超过50%,直接算一笔账包月的单位算力成本是短租的一半左右,长期看省下的费用相当可观,值得尽早切换。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/788211.html