服务器大多数迷惑行为并非硬件故障,而是瞬时资源耗尽、日志误读、监控盲区与网络链路问题共同作用的结果,排查优先级应高于直接重启。
服务器半夜自己重启,日志里却什么都没有
场景描述: 凌晨3点,业务群没人说话,监控大屏突然飘红,登录服务器一看,uptime显示系统启动时间在几分钟前,last reboot输出空白,journalctl翻半天只有正常关机的记录。
这种“沉默重启”在物理机和云服务器上都很常见,多数情况并非操作系统主动重启,而是底层硬件或虚拟化平台介入,物理机常见诱因包括电源模块抖动、内存单比特错误触发内核panic、BMC固件误判温度阈值,云服务器则可能是宿主机迁移或内存热迁移失败后的强制HA切换。
排查这类问题有一个简单有效的实操路径:
- 检查
/var/log/messages或/var/log/syslog中panic或kernel stack痕迹 - 用
mcelog --client查看硬件错误记录 - 登录云厂商控制台查看“系统事件”或“故障迁移”记录
- 确认是否配置了
watchdog或ipmi定时重启策略
行业共识认为,服务器重启后正常是怎么回事,多数指向瞬时过载触发系统自我保护机制,如果重启后能稳定运行数周,硬件故障概率相对较低,重点应从内核版本和驱动兼容性入手。
服务器重启后正常是怎么回事,业务却对不上账
场景描述: 重启大法好使,但业务方不干了,凌晨挂的订单、中间态的任务、写到一半的缓存日志全部丢失,接口幂等性差的服务直接产生脏数据,运维和技术Leader的第一反应往往是:早知道就不重启那么快了。
重启不是问题,没有预判重启后果才是问题,服务器在宕机前通常有几十秒到几分钟的“濒死窗口”,这段时间足够做三件事:
- 抓取
jstack或top -Hp定位占CPU最高的线程 - 记录
ss -s查看当前TCP连接状态分布 - 把
/proc/meminfo和/var/log/dmesg尾部输出保存到外部存储
很多团队的监控告警阈值设置过低,磁盘使用率超过80%就狂发警报,但真正致命的往往是内存回收抖动或inode耗尽。告警疲劳会让值班人员忽略关键信号,等真正出问题时已经来不及优雅排障。
服务器宕机怎么排查,核心思路是先保现场再恢复,如果服务器还没有完全失去响应,优先执行:
df -ih查看inode使用率,确认是否存在小文件垃圾堆积cat /proc/loadavg对比CPU核数判断负载是否异常dmesg -T | tail -50检查OOM Killer和硬件错误记录sar -q回看历史负载趋势,确认是否存在规律性资源峰值
服务器ip被拉黑,业务没违规却连不上
场景描述: 产品经理反馈后台登不上去,研发检查代码没问题,网络工程师测试端口通不通也正常,最后发现是服务器ip被云厂商的安全策略封了,理由是“对外扫描行为”,更冤枉的是,被封的服务器只是一台刚上线的测试机,根本没有对外访问权限。
这类情况在高防服务器和共享出口IP的云服务器上出现频率更高,业内专家指出,多数IP封禁源于相邻租户的违规行为被连带追溯,尤其是同网段内其他机器发起DDoS或暴力破解时,安全策略会按IP段进行临时封禁。
排查步骤建议按以下顺序:
- 登录云厂商控制台查看“安全管控”或“封禁记录”
- 用
curl ifconfig.me确认当前出口公网IP是否变化 - 检查
/var/log/secure中是否有大量认证失败记录 - 联系服务商客服获取精确封禁原因,而非盲目换IP
如果封禁记录明确显示是自身业务触发的防护策略,常见场景包括:爬虫定时任务没有限速、Redis或MongoDB端口暴露到公网并被扫描、邮件服务被第三方滥用发送垃圾邮件。封IP不可怕,可怕的是不知道为什么被封。
服务器配置修改后不生效,文件明明改对了
场景描述: 改完nginx.conf执行了nginx -s reload,配置却跟没改一样,检查文件内容确认语法正确,nginx -t也提示OK,访问行为却依然走旧逻辑,排查半小时发现是include的顺序问题,前面的配置把后面的覆盖了。
这种情况在Nginx、PHP-FPM、MySQL三件套的服务器上尤其常见,配置文件层层include、不同目录下存在同名配置文件、环境变量被父进程继承等因素都会导致“改了等于没改”的假象。
有效的排查方式:
- 用
nginx -T查看实际生效的完整配置,对比文件中写的差异 - 确认
php-fpm是否开启了opcache,代码更新后是否需要reload - 检查
/etc/sysctl.conf与/proc/sys/下实际值是否一致,部分参数需sysctl -p重载 - 注意AWS、简米云等平台的控制台参数可能与服务器内部配置相互覆盖
多数情况下,配置不生效并非服务器“抗命”,而是配置加载顺序和缓存机制在起作用。验证配置是否生效的最佳方式,不是看文件内容,而是看进程实际运行参数。
服务器宕机怎么排查,数据中心巡检也找不到根因
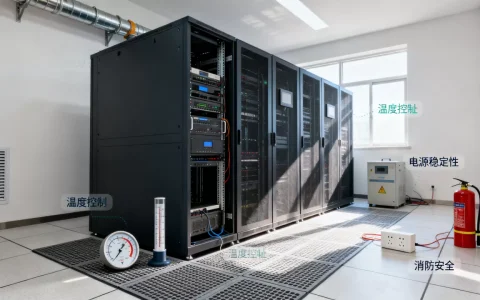
场景描述: 机房巡检一切正常,服务器硬件指示灯全绿,电源模块无告警,硬盘无坏道,但服务器就是间歇性失联,每次持续两三分钟,然后自动恢复,这种“幽灵宕机”最消耗排查精力,因为故障消失后所有指标都恢复正常。
从网络层面看,数据中心内部的防火墙上联带宽达到瓶颈是一个容易被忽略的因素,业务高峰期的突发流量会占满出口带宽,导致TCP重传率飙升,看起来就像服务器停止响应,实际上服务器本身负载不高,是流量出不去。
另一个高频诱因是ARP表项老化或交换机端口协商异常,服务器网卡在千兆和百兆之间反复切换,或者双网卡绑定模式配置错误导致环路,都会让连接时断时续。
排查路径:
ethtool eth0查看网卡当前速率和工作模式- 对比交换机的端口统计与服务器侧流量是否匹配
- 查看
/var/log/messages中是否有link down/link up反复切换记录 - 检查
net.ipv4.tcp_retries2参数,确认TCP重试策略
在选择服务器配置时,如果业务对网络稳定性要求高,建议优先考虑独享带宽而非共享带宽,并在架构上预留冗余链路,避免单点物理链路故障导致整个服务不可用。
关于服务器迷惑行为的常见问题
服务器无故重启是否一定意味着硬件故障?
不完全是,统计显示,约半数的服务器重启与硬件无直接关系,更多是内核崩溃、文件系统错误、资源耗尽或虚拟化平台操作所致,建议先查journalctl -b -1查看上次启动前的系统日志,若存在OOM记录,优先排查内存配额和业务占用。
服务器ip被拉黑后如何快速恢复业务?
若确认是安全策略误封,最有效的方式是提交工单解封,通常10至30分钟生效,紧急情况下可临时切换备用IP或使用CDN回源IP绕过封禁,根本上要收敛对外暴露端口,关闭不必要的公网访问,整段IP被封时直接更换服务器所在地域重新部署,效率高于反复申诉。
服务器配置修改后不生效应优先检查什么?
优先确认进程是否重载了配置,以及配置文件中是否存在重复或冲突的指令,例如nginx -s reload只能让工作进程加载新配置,master进程的启动参数不会被更新;crontab修改后需确认守护进程是否正确读取了新的定时任务列表,多实例部署时,还需确认修改的是否为实际被加载的配置路径。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/793949.html