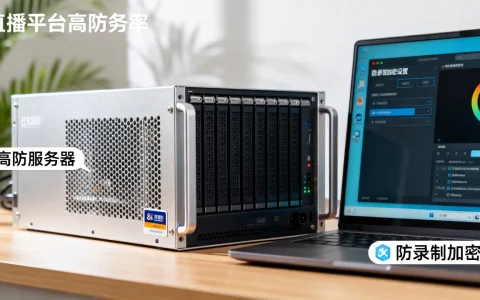
算力服务器的核心组成是GPU(图形处理器)、CPU(中央处理器)、内存、存储和网络互连五大模块,其中GPU承担超过80%的并行计算任务,是决定整机算力水平的第一要素。
算力服务器的核心组成详解
算力服务器并非一台普通电脑的简单升级,它在架构设计上完全围绕“并行计算”来展开,你把它想象成一个大型流水线工厂会更直观CPU是厂长,GPU是负责重复体力劳动的主力工人,内存是工位旁的物料台,存储是仓库,网络是连接各个工厂的运输车队。

CPU:算力服务器的调度中枢
CPU在算力服务器中不负责主要的数学运算,但担任所有指令的调度工作,它需要管理PCIe通道、内存寻址、网络数据分发,以及与GPU之间的数据交换。
实际配置中,算力服务器多为双路CPU架构,主流方案包括Intel至强系列和AMD霄龙系列,核心数量通常在32核到64核之间,值得关注的是,CPU与GPU的配比有讲究如果你用的是8卡GPU服务器,那么CPU的核心数、PCIe通道数必须能喂饱8张显卡的数据吞吐需求,否则GPU会频繁处于等待状态,算力利用率大打折扣。
GPU:算力服务器的效率核心
GPU是算力服务器区别于传统服务器的根本标志,它由数千个计算核心组成,特别适合处理矩阵运算、深度学习训练、科学仿真等任务。
按性能层级划分,市面常见三类:
- 训练级GPU:如NVIDIA A100、H800,显存通常40GB或80GB,用于大模型预训练和微调
- 推理级GPU:如L40S、A10,显存24GB左右,用于模型部署和实时推理
- 入门级GPU:如RTX 4090、L20,适合小规模实验和开发调试
业内专家指出,训练和推理场景对GPU的需求差异很大,训练卡需要更大的显存带宽来搬运中间计算结果,而推理卡更看重吞吐量和延迟指标,多数情况下,一张H800的单卡功耗达到700W,整机8卡满载功耗在3000W以上,这是机房部署时必须提前考虑的散热和电力成本。
内存与存储:数据流转的通道与仓库
算力服务器的内存规格与普通服务器不同,它要求大容量、高频率、纠错能力,单条内存普遍采用32GB或64GB的DDR5 ECC内存,整机配置通常在512GB到2TB之间,容量过小会导致GPU频繁与硬盘交换数据,训练速度骤降。
存储部分采用分级架构:
- 系统盘:两块480GB或960GB的SSD做RAID 1,安装操作系统和驱动
- 数据盘:多块3.84TB或7.68TB的企业级NVMe SSD,用于存放训练数据集和模型参数
- 缓存盘:部分高性能场景会额外配置一块大容量SSD作为数据预读缓冲区
以典型的8卡训练服务器为例,存储配置需要同时满足高吞吐和低延迟两个要求,NVMe SSD的读写速度比传统SATA SSD快5到10倍,这个差距在加载TB级数据集时体现得非常明显。
网络互连:多卡协作的数据血管
GPU服务器内的数据交换依赖PCIe总线,而服务器之间的数据交换依赖网络,当前主流算力服务器有两条技术路线:
- PCIe 4.0/5.0架构:每张GPU通过PCIe通道直连CPU,带宽充足但扩展性有限,适用于4卡到8卡机型
- NVLink + NVSwitch架构:NVIDIA专属的GPU直连方案,带宽是PCIe的5倍以上,大型集群几乎全部依赖NVLink实现卡间高速通信
如果组建大规模算力集群,还需要配置InfiniBand或RoCE网络,单个GPU节点之间同步梯度数据时,传统千兆网络会成为严重瓶颈,行业共识是使用200Gbps或400Gbps的高速网卡以及配套的交换机才能满足集群训练需求。
算力服务器配置怎么选
不同使用场景,算力服务器的硬件侧重完全不同,你在采购前先搞清楚自己的业务类型,否则很容易花冤枉钱。
深度学习训练场景
这类场景对GPU显存的容量和带宽苛求极致,配置重点如下:
- GPU数量:4卡或8卡起步,建议选择支持NVLink的型号
- CPU:双路,单颗32核以上,主频不低于2.5GHz
- 内存:至少512GB,训练参数在百亿级时建议1TB
- 存储:数据盘建议4TB NVMe SSD起步
- 网络:至少25Gbps内网,集群训练必须上100Gbps或更高
AI推理部署场景
推理场景追求多路并发和低延迟,配置思路与训练截然不同:
- GPU数量:2卡到4卡即可,重点看显存容量是否装得下模型
- CPU:单路或双路均可,核心数要求不高但单核性能要强
- 内存:128GB到256GB足够,关键在于内存带宽
- 存储:系统盘+数据盘双盘即可,不需要超大容量缓存
异构计算与科学仿真场景
这类应用涉及大量双精度计算,对CPU的浮点运算能力要求极高,除了GPU外,还需要考虑是否配置FPGA(现场可编程门阵列)或ASIC芯片作为加速单元,用CPU+GPU+专用芯片的异构架构来应对多种计算负载。
算力服务器租用还是自建划算
很多中小团队在采购算力服务器时都会纠结自建和租用的问题,两者各有适用边界,需要用实际的算力需求和资金情况来判断。
自建的优势与代价
自建的优点在于硬件资源完全可控、数据安全度高、长期使用均摊成本低,但代价也很明显:
- 一次性投入大,一台8卡训练服务器整机价格通常在40万到120万元区间
- 机房环境要求高,需要解决供电、散热、机柜空间
- 硬件迭代快,GPU每两到三年更新一代,残值率难以预估
租用的灵活性与价格参考
云服务器按需付费,可以随时扩展和缩减规模,目前国内主流云厂商的GPU云服务器租用价格,以单卡A100(40GB显存)为例,按小时计费通常在40元到80元之间,包月价格在1.8万到3万元上下,具体价格因地域和机房不同有差异,北京、上海、贵州等数据中心聚集区的价格相对更有竞争力。
算力服务器租用价格对比表:
| 配置规格 | 适用场景 | 月租参考区间 |
|---|---|---|
| 单卡RTX 4090 | 模型调试、小规模推理 | 3000-6000元 |
| 单卡A100 40GB | 大模型微调、中等训练 | 15000-25000元 |
| 8卡A100整机 | 百亿级大模型训练 | 10万-20万元 |
混合模式的可行性
行业内相当一部分企业选择了“固定资产+弹性云资源”的混合架构,核心业务跑在自己机房,波动性任务临时租用云GPU,这种方式兼顾了成本控制和算力弹性,对于刚刚起步的团队,先租用云服务器验证业务模型,待运行稳定后再考虑自购是最稳妥的路径。
算力服务器散热与功耗规划
散热设计直接决定算力服务器的运行稳定性和寿命,这个问题在实际部署中经常被忽视,8卡GPU服务器满负荷运行时,整机功耗轻松突破3000W,相当于一个普通家庭全天用电量的数倍。
- 风冷方案:适用于机房环境温度可控、机柜通风良好的场景,也是大多数中小机房的主流方案
- 液冷方案:适用于高密度部署场景,散热效率比风冷提高40%以上,但初建成本更高
在你部署算力服务器之前,务必确认三个数字:机柜可用电力余量、空调制冷量、每U空间的散热能力,这三个数字任何一个不达标,GPU都会因温度过高而自动降频,实测算力输出可能连标称的50%都达不到。
算力服务器配置清单与检查要点
最后给你一份实操性较强的配置核验清单,照着做能有效避免踩坑:
- 确认GPU型号与显存容量和标称一致,用
nvidia-smi命令验证 - 确认CPU支持的PCIe通道数足够分配给全部显卡
- 检查内存条数量和频率是否匹配主板规格,建议开启XMP或对应的ECC配置
- 测试整机满载运行30分钟以上,用
ipmitool sdr命令查看温度传感器数据 - 确认网卡速率与交换机端口匹配,使用
iperf3工具验证实际带宽
算力服务器的本质是一个通过高速互连将数千个计算核心串联起来的并行计算系统,GPU决定性能上限,CPU调度全局资源,内存带宽避免数据瓶颈,存储容量承载海量样本,网络互连连接集群规模,五者缺一不可,选型时优先锚定GPU规格,再根据业务场景倒推其余部件的配套等级,避免木桶效应的短板即可。
算力服务器热门问题解答
算力服务器和普通服务器最大的区别在哪里?
算力服务器额外搭载了高性能GPU或专用加速芯片,具备大规模并行浮点运算能力,普通服务器的计算任务主要靠CPU完成,而算力服务器把重计算任务卸载到GPU上,单机浮点运算能力能提升数十倍甚至数百倍,尤其适合AI训练、科学计算和视频编解码等场景。
训练大语言模型需要什么配置的算力服务器?
训练百亿参数规模的大模型,推荐至少在8卡A100或H800级别以上的配置,配套CPU核心数不少于64核,内存不低于1TB,存储不低于10TB NVMe SSD,如果是千亿参数以上级别的模型,单机已经无法胜任,需要组建多节点集群并配置高速互联网络。
算力服务器托管和租用机柜需要注意什么?
托管算力服务器最关键的是电力容量和散热条件,单台8卡GPU服务器建议预留至少4kW的电力配额,机柜需要有独立的散热通道,租用机柜前先确认运营商的电力冗余策略,并签订SLA协议明确故障恢复时效,同时确认日常远程维护和硬件巡检的具体流程。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/795456.html