当ssh远程服务器连接断开时,正在运行的任务不会自动终止,但前提是你使用了正确的工具和方法,否则进程会随连接中断而消亡。解决这个问题的核心思路是让任务脱离终端会话独立运行,业界最成熟的方案是tmux、screen以及systemd服务托管,本文将逐一拆解每种方案的适用场景、实操步骤和避坑指南,并给出应对连接频繁断开的排查思路。
为什么ssh一断,任务就没了
要解决问题,得先理解问题的根源,一个Linux进程的生命周期与它的控制终端紧密绑定,当你通过ssh登录服务器时,会在远端创建了一个伪终端(PTY),所有在这个终端里运行的命令,都把这个终端当作“爹”。
一旦网络抖动或你关闭本地电脑,ssh连接断裂,内核会给终端对应的会话(Session)发送SIGHUP信号(挂断信号),默认行为下,收到这个信号的进程会直接退出,这就是你辛辛苦苦跑了一晚上的数据训练脚本,第二天起来发现“连接断开,命令失效”的根本原因。
这个机制是几十年的Unix设计传统,本意是防止孤儿进程消耗资源,但也一直在给远程开发者添堵,搞清楚了这一点,应对策略就清晰了:要么让进程忽略SIGHUP,要么给它换一个永不消失的“爹”。
ssh断开后如何让任务继续执行:三大主流方案横向对比
根据任务类型、服务器权限和你的使用习惯,业内常用的方案有以下三类,它们的核心逻辑都是“进程托管”,但复杂度与适用场景不一样。
| 工具/方案 | 核心原理 | 适用场景 | 学习成本 | 重启后恢复 |
|---|---|---|---|---|
| tmux | 终端复用器,任务挂在tmux服务上 | 交互式任务、多窗口管理、日常开发 | 中 | 手动恢复会话 |
| screen | 老牌终端复用器,原理同tmux | 系统自带、极简环境 | 低 | 手动恢复会话 |
| systemd服务 | 将任务交给init进程托管 | 长期稳定运行的服务、开机自启 | 高 | 自动恢复(需配置) |
tmux处理“跑了一半”的任务
这是目前行业内的默认标准,tmux是一个终端复用器,它的核心思想是:你在tmux创建的窗口里跑任务,任务的实际父进程是tmux服务端,这个服务端跟你当前的ssh连接没有依附关系,就算你彻底退出ssh,tmux服务端依然在服务器上老老实实替你看着任务。
适合的场景:你现在就在服务器上跑着某个长时间任务(比如make编译、python train.py),突然发现可能要断网,这时候用tmux“续命”是成本最低的。
实操步骤:
- 创建会话:在终端输入
tmux new -s work,这会创建一个名为“work”的新会话,你会进入一个看起来一模一样的终端界面,但此时你的命令已经在这个会话里运行了。 - 运行任务:正常执行你的脚本或命令。
- 脱离会话:按键盘组合键
Ctrl+b,然后按d(detach的首字母),屏幕上会提示[detached],你就回到了正常的ssh终端界面,这时候任务依然在tmux会话里疯狂运行。 - 验证与重连:直接断开ssh,过一段时间再连上来,输入
tmux attach -t work,你会发现界面正是你之前离开时的样子,任务还在跑。
不适用场景:如果你忘了先创建tmux会话怎么办?有一种临时的补救办法:使用disown命令,在任务运行时按Ctrl+z挂起,输入bg转到后台,再输入disown,这样能移除任务的作业表关联,隔离SIGHUP信号,但这类方案对已运行任务的保护不够彻底,只适合应急。
screen极简环境下的后备选项
相比之下,screen是更“老炮”的解决方案,很多精简版Linux系统可能没装tmux,但大概率装了screen。
核心命令速查:
- 新建会话:
screen -S name - 脱离会话:
Ctrl+a然后按d - 查看会话:
screen -ls - 重新连接:
screen -r name
区别在哪里? 行业共识认为,tmux的分屏能力和配置灵活性远强于screen(tmux支持在同一个会话里切分多个窗格),而screen胜在预装率极高和配置极简,如果只是为了保住一个临时任务,用哪个都一样;如果你有复杂的多窗格协同需求,tmux是更合适的选择。
nohup与setsid最简单的“命令级”方案
如果你不需要再回到那个交互界面,只想让任务在后台默默地跑完,nohup是最直接的工具。
# 标准用法,将输出重定向到指定文件,避免输出信息堆积
nohup python train.py > train.log 2>&1 &
这里逐段拆解这个命令的含义:
nohup:让进程忽略SIGHUP信号。> train.log:将标准输出写入文件。2>&1:将标准错误输出也重定向到同一个文件,这样报错信息也能留下。&:让命令在后台执行。
命令执行后,会返回一个PID(进程ID),你需要记录这个PID,或者用echo $!查看,下次连上来时,用ps -ef | grep train.py就能确认进程是否还在。
但nohup有个致命弱点:你无法再重新“抓住”这个进程去查看它的实时输出或传递按键指令,它跑成功了就是成功,失败了你也只能翻日志。
systemd长期服务的正规打法
如果你在服务器上部署的是需要7×24小时运行的服务,比如Web服务、消息队列消费者,就别用tmux或nohup了,业内专家强烈推荐使用systemd(或initd)来管理。
编写一个unit文件放在/etc/systemd/system/下:
[Unit]
Description=My Custom Service
[Service]
Type=simple
ExecStart=/usr/bin/python3 /opt/myapp/main.py
Restart=always
RestartSec=5
[Install]
WantedBy=multi-user.target
执行systemctl enable myapp和systemctl start myapp,此后,这个进程由1号进程(init)托管,与你的ssh连接彻底绝缘,它会监听进程崩溃信号并自动重启,随机器开机自启,这是将任务“托管”给系统的终极方案。
ssh连接频繁断开:怎么排查和预防
抓住了“挥手”的问题,还得治“老断线”的毛病,如果只是偶尔断一次,tmux足够兜底;但如果几分钟就掉线一次,就得从网络与配置下手了。
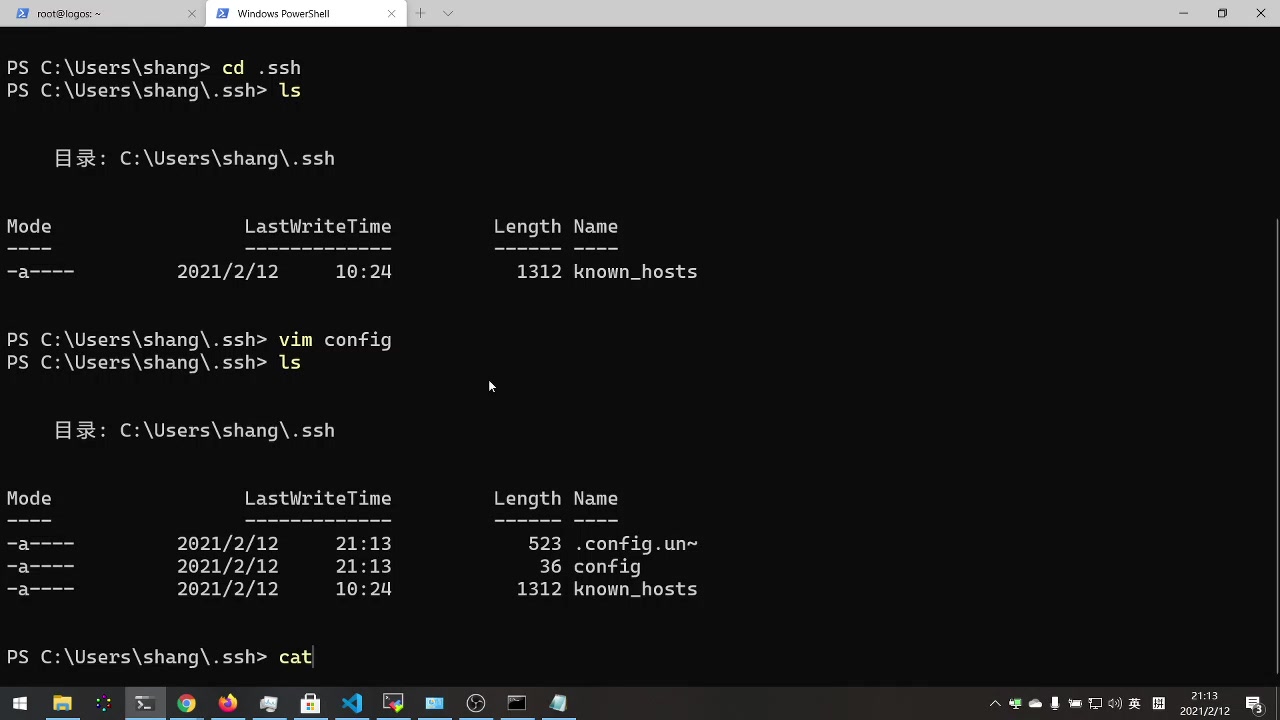
客户端侧调整(Mac/Linux命令,Windows参考terminal)
打开你本地机器的ssh配置文件(~/.ssh/config),加入这两行:
Host
    ServerAliveInterval 30
    ServerAliveCountMax 3
这段配置的意思是:每30秒向服务器发送一个空心跳包,如果连续3次(即90秒)没有收到回包,才判定连接断开,这能有效避免路由器和运营商把长时间空闲的连接踢掉。
服务端侧兜底(需要root权限)
登录服务器,编辑/etc/ssh/sshd_config文件:
# 允许保持连接的心跳间隔,单位秒
ClientAliveInterval 30
# 允许发送心跳的最大次数,超过即断开
ClientAliveCountMax 3
改完记得systemctl reload sshd让配置生效,注意,这两个参数在配置里默认是被注释掉的,需要手动取消注释或追加。
断线前的最后一道防线:immediately action
当会话确实已经断开时,不要慌张,你的第一反应应该是做两件事。
第一件事检查:重新登录服务器后,立即执行ps -ef(或者top)查看进程状态,如果一个任务进程的父进程ID是1(即systemd/init),那说明它已经被系统收养,脱离了原有的终端,你不用担心它,如果父进程不是1,而是变成了当前sshd的PID,那就说明任务可能还处于“未死”状态。
第二件事检查:观察nohup.out或日志文件的最后写入时间,用tail -f跟踪一下日志末尾,确认文件是否还在随着任务更新,这是判断Java/Python任务是否“还活着”的最直接证据。
高阶技巧:如何解决“tmux会话残留”带来的困扰
当服务器承载了太多历史粘滞会话,管理起来会变得混沌,最令新手困惑的是:提示lost server或[tmux] kill-server failed,这通常发生在你试图以错误的用户权限去访问另一个用户的会话时,此时不要拼利用kill -9硬清会话,因为tmux kill-session -t 会话名才是正确清除指定会话的指令。
关于价格与部署场景的延伸:不少用户关心“云厂商的集群管理界面和本地tmux的取舍”如果用的是简米云/酷番云的轻量服务器,控制台自带的“VNC登录”访问的是物理机的虚拟终端,这个终端通常不会因你的网络变化而断开,但云端控制台偶尔的运维升级也会导致连接重置,本着不依赖单一故障点的原则,核心生产会话还是托管在tmux里更稳妥。
ssh远程服务器断开后怎么办:关键决策总结
全部看完可能有点长,如果只记三句话,那就是:
- 交互式长任务:立刻用
tmux new -s mytask重开会话再跑。 - 一次性后台任务:用
nohup command > log.log 2>&1 &最省心。 - 常驻服务:直接改写成systemd服务,搞定重启自启。
Q&A 列表
我忘记在tmux里跑任务了,ssh已经断开,怎么补救?
补不了的,这算是一个操作纪律问题,断开的那个终端已经被内核强制清空了,无法找回,你能做的只有重新登录,然后再启动一次任务,并把它放到新的tmux会话里运行,用nohup或者把任务更细致地拆分成多个可重复执行的子步骤,进程的生命周期从被创建那一刻就决定了它的“监护人”是谁,这是底层的性质。“断线补启动”是不可能的,只能防患于未然。
有没有可能让进程完全免疫SIGHUP,永不关闭?
让进程对SIGHUP免疫是可行的,用nohup或者trap '' HUP就能让进程忽略该信号,但忽略信号不等于进程不会被系统资源限制或OOM(内存溢出)杀死,更关键的在于,一个进程能不能存活,最终由它的生命周期和运行状态决定,如果你的服务因为内存被占满而被OOM Killed,不管有没有nohup,进程都会消失,对重要任务而言,可靠的守护机制是重中之重。
tmux和screen到底哪个更耗费服务器资源?
在资源占用上,两者几乎可以忽略不计,tmux和screen的内存占用一般都在几兆甚至十几兆的规模,对服务器来说是个小数目,在当今动辄2G内存起步的云服务器上,没必要在这个层面上做区分,差异更主要还是在功能扩展性和操作习惯上,如果你说要跑一个多节点的分布式任务,资源的瓶颈显然在计算和网络IO,跟终端复用器没有直接关系。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/806401.html