AI展现优化
-
如何写清迁移文档让交接复盘都省心,交接文档怎么写?
迁移文档不是写给领导看的,而是写给下一个人、下一次事故和下一个项目的,文档写清了,交接省心,复盘也有据可查,能少走一半弯路,为什么迁移文档越来越像“刚需”2026年的业务系统早已不是一台机器、一个数据库就能搞定的时代,容器编排、微服务拆分、跨云部署成为常态,一次迁移涉及的网络策略、依赖链路、数据同步点,往往比想……
-
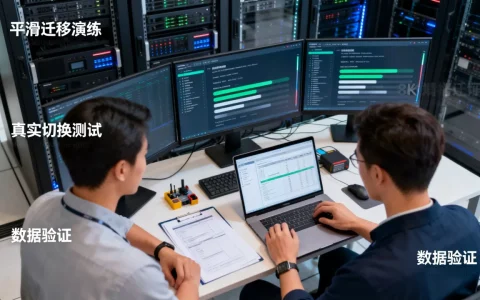
为什么平滑迁移要演练真实切一次再上线,如何避免迁移风险?
平滑迁移不能只靠演练,真实切一次才是检验方案是否可靠的唯一标准,与其在预设脚本里反复排练,不如在业务低峰期动真格,让流量和真实数据替你发现所有隐藏的问题,真实切换才是迁移的试金石很多团队习惯把迁移演练做成一场精心准备的表演,环境是克隆的,数据是脱敏的,连流量都是模拟的,演练通过后自信满满,结果上线当天故障频发……
-
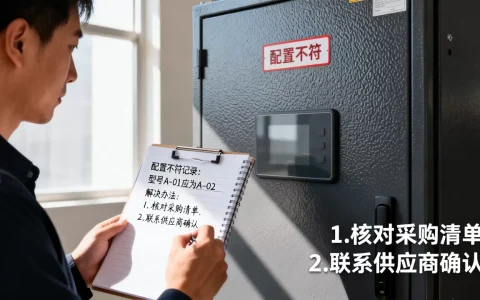
验收阶段发现配置不符怎么处理,有哪些解决办法?
验收阶段发现配置不符时,最有效的处理办法是立即停止验收流程,固定书面证据,然后按合同约定启动变更或索赔程序,切勿先签字后补协议,验收阶段出问题并不少见,但处理方式直接决定项目尾款能否顺利收回、责任如何划分,很多负责人一看到配置与合同不符就慌了,要么直接拒绝验收导致僵局,要么被乙方几句话糊弄着先签了字,这两种极端……
-
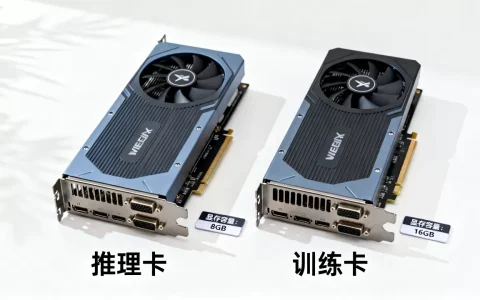
推理卡与训练卡在显存容量上的选择差异
推理卡与训练卡的显存容量选择逻辑截然不同,推理场景更注重容量与带宽的匹配、并发批处理能力以及单位成本承载的吞吐量,而不是单纯追求大容量,训练卡需要在显存中同时存放权重、梯度、优化器状态和中间激活值,容量不够直接导致训练中断;推理卡只需存放权重和KV Cache,但在线服务的延迟和吞吐要求决定了显存必须刚好卡在性……
-
在线推理服务如何降低首字延迟的工程实践
在线推理服务降低首字延迟,本质上不是把模型跑得更快,而是让用户请求和数据流动的每个环节都更紧凑,核心手段包括投机解码、动态批处理、流式传输协议优化以及推理引擎选型,为什么首字延迟比总延迟更致命用户点击聊天框发送消息后,屏幕上光标转了多久才蹦出第一个字,这个时间被称作首字延迟,业内专家指出,多数用户对AI服务的耐……
-
容器化训练任务如何调度计算资源?,有哪些高效策略?
容器化训练任务的计算资源调度,核心是三层协同:Kubernetes原生调度器管基础调度,设备插件管GPU分配,作业级调度器管排队与优先级,只靠默认调度器跑大模型训练,一定会撞墙,容器化训练任务资源怎么调度:先把调度器逻辑讲透很多团队把训练任务塞进容器,以为配上 nvidia.com/gpu: 8 就完事,结果集……
-
多卡服务器中NVLink与IB如何分工?,NVLink和IB网络区别是什么?
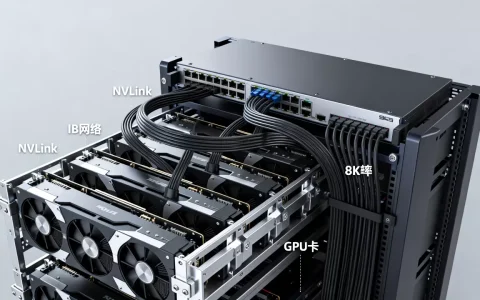
多卡服务器中NVLink负责GPU之间的高速数据直连,IB网络(InfiniBand)负责服务器节点之间的横向扩展通信,两者分工明确,共同搭建起大模型训练和科学计算的高速公路,这句结论听起来简单,但实际落地时,很多用户在选购和配置多卡服务器时,经常会混淆这两者的职责,导致花了高价买设备,性能却卡在瓶颈上,这篇文……
-
模型仓库冷温热数据分层存储怎么取舍,有哪些方案?
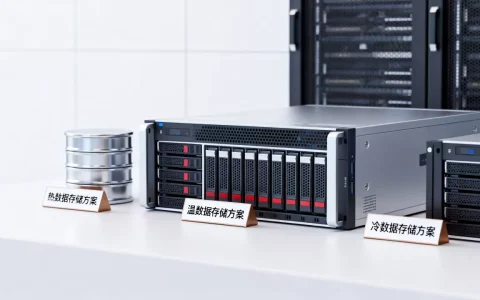
按访问频率把数据拆成热、温、冷三层,热层用高性能介质,冷层用低成本对象存储,温层卡在中间,这样既能压住成本,又不拖累训练和推理速度,实际维护模型仓库的时候,你会发现所有数据都长一个样,但它们的「命」不一样,有些每天被拉出来反复训练、调参,有些只是躺在那里等一个可能永远不回来的回滚请求,如果一视同仁用SSD伺候……
-
大模型训练显存不足如何切分,有哪些高效策略?
显存不足时大模型训练的切分策略,核心思路是把模型、梯度、优化器状态拆开,按需分布到多张卡上;没有万能方案,只有按硬件和模型规模选组合,当一张显卡的显存被模型参数占满,报错“CUDA out of memory”时,很多人第一反应是换更大显存的卡,但在2026年,单卡显存增长远慢于模型参数膨胀,切分训练已经成为主……
-
推理批量大小如何影响GPU利用率,批量大小怎么设置最优?
推理批量大小直接决定GPU计算单元能否被充分喂饱,调大batch size通常是提升GPU利用率最直接、成本最低的手段,但它并非越大越好,显存上限和延迟要求共同画出了天花板,为什么GPU利用率会卡在batch size上很多人盯着nvidia-smi里跳动的百分比,以为是显卡不行或者代码写得差,相当一部分“利用……